

MySQL 数据库表合并与分区实现详解
本文介绍 MySQL 中提升查询效率的两种核心机制:表合并与表分区。首先通过 MERGE 存储引擎将多个结构相同的 MyISAM 表合并为逻辑容器,随后详细演示了基于 RANGE、LIST、HASH、LINEAR HASH 及 KEY 的五种分区策略及其 SQL 语法,帮助优化大数据量下的数据管理。
2026-10-15
8
本文介绍 MySQL 中提升查询效率的两种核心机制:表合并与表分区。首先通过 MERGE 存储引擎将多个结构相同的 MyISAM 表合并为逻辑容器,随后详细演示了基于 RANGE、LIST、HASH、LINEAR HASH 及 KEY 的五种分区策略及其 SQL 语法,帮助优化大数据量下的数据管理。
文章详细解析MySQL中保证数据完整性与有效性的五大核心约束:非空、唯一、主键、外键及检查约束。通过创建表的SQL语句与插入测试数据的代码块,演示单列与多列联合约束的具体写法,并对比自然主键与业务主键的设计差异,阐明父子表操作顺序对数据一致性的影响。
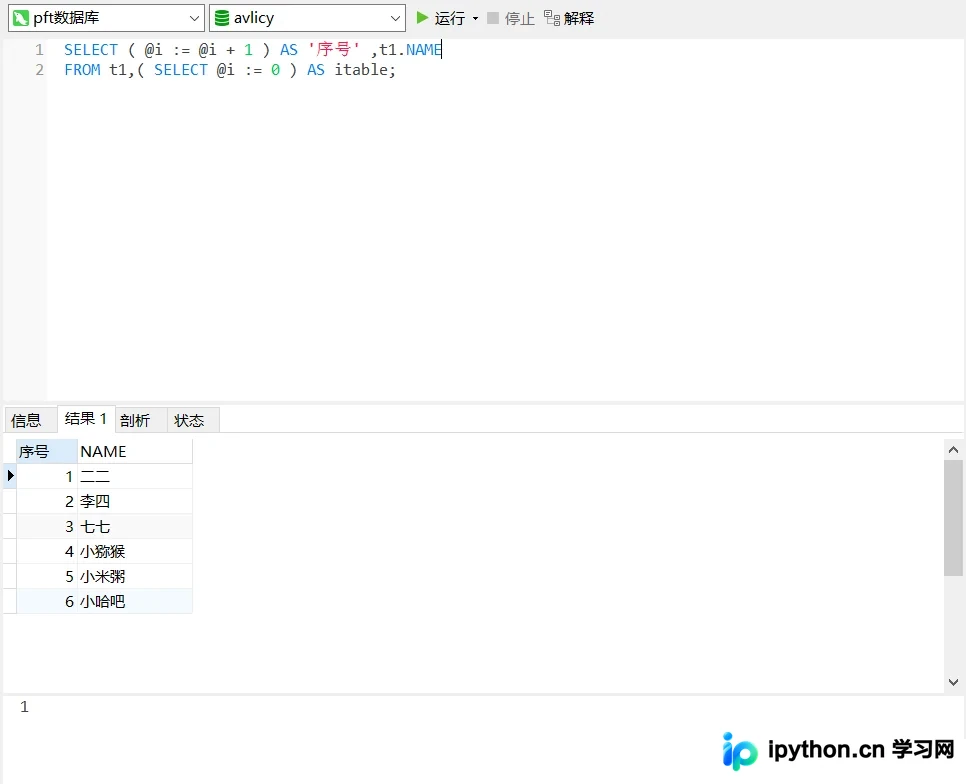
在MySQL中,普通查询使用用户变量可直接添加序号,但结合LIMIT进行分页时,每页都会从头计算。本文详细介绍如何利用用户变量的初始化机制,通过传递分页偏移量作为初始值,实现在多页数据中保持序号连续递增的效果,并解析核心SQL逻辑与符号区别。
本文介绍如何在MySQL中使用REGEXP操作符进行正则表达式匹配。涵盖基本字符匹配、OR逻辑(|)、字符类([])、特殊字符转义、预定义字符集、多次匹配元字符(*)以及定位符(^/$)等核心语法,并提供对比LIKE的详细SQL示例,帮助开发者更灵活地进行复杂数据筛选。
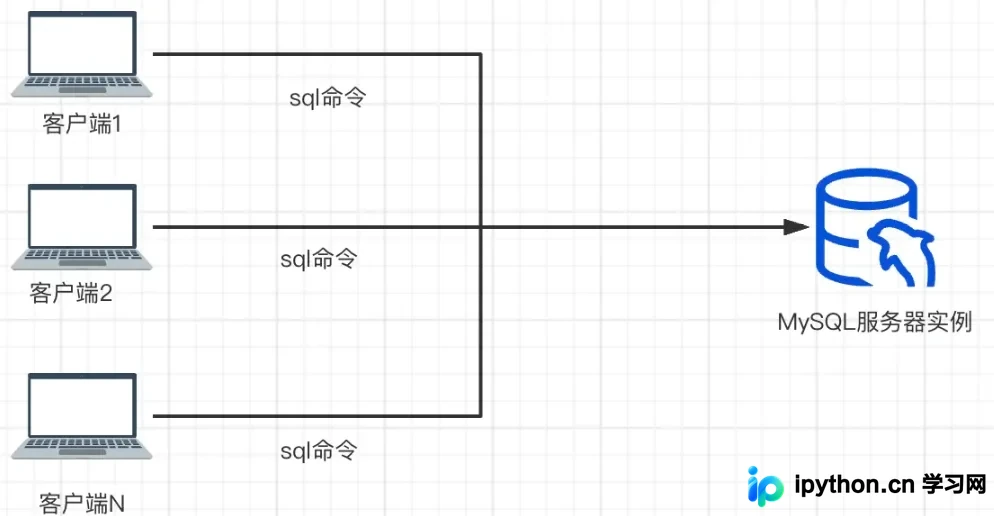
本文深入解析MySQL的客户端/服务器运行架构,阐明两者作为独立进程的交互机制。重点介绍三种通信方式,特别是生产环境通用的TCP/IP协议,并提供标准的命令行连接参数与安全输入密码的建议。
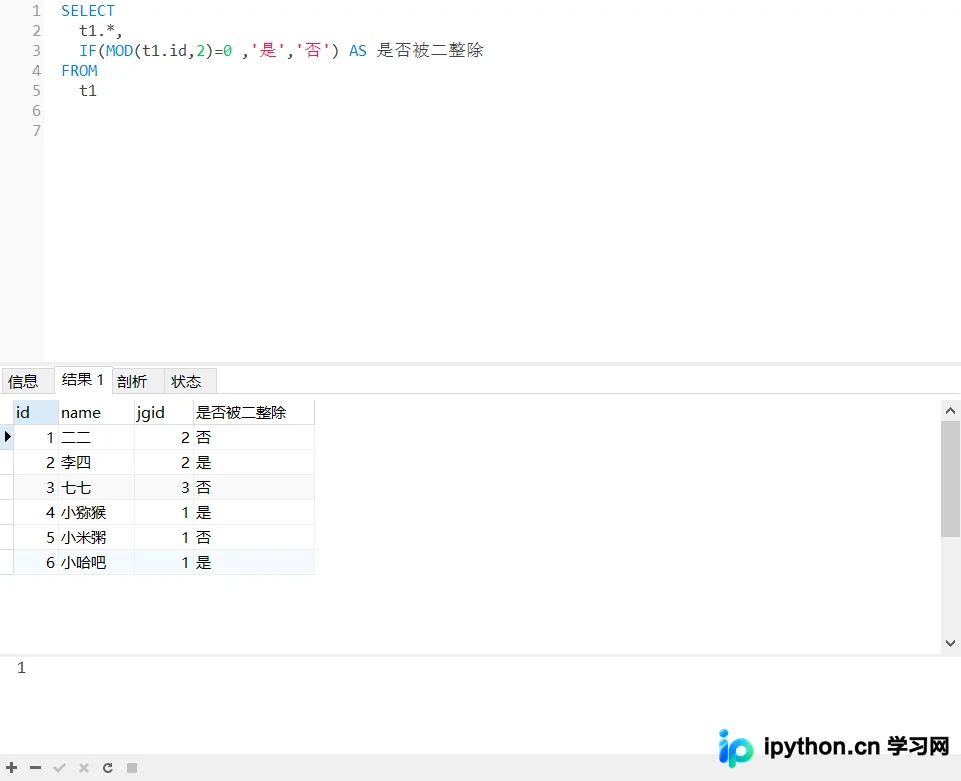
本文详细介绍MySQL数据库中利用IF函数和CASE表达式进行数据条件判断的方法。通过建表测试,演示IF在查询选择与WHERE过滤中的应用,以及CASE将数值字段映射为角色标签的技巧,提供可直接运行的SQL代码与执行结果示意。
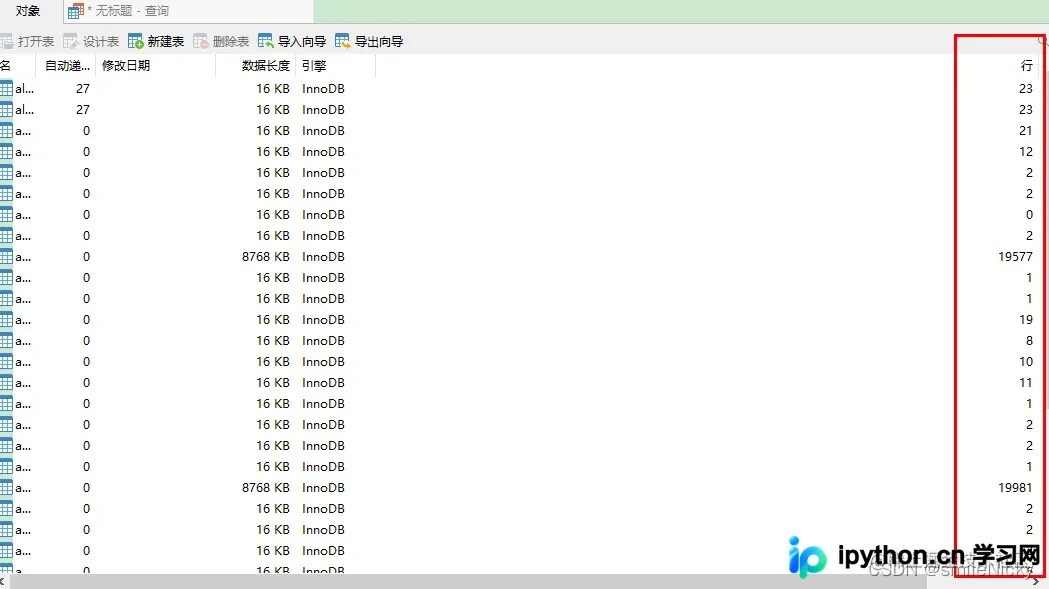
在MySQL中高效统计一个数据库内所有表的记录数和数据容量。通过查询 system 库中的 information_schema.tables 表,可以使用一条SQL语句获取各表的 table_rows(预估行数)、data_length(数据大小)和 index_length(索引大小)。需要注意 InnoDB 引擎的行数仅为近似值,且建议对结果进行降序排列以便快速定位大容量表。
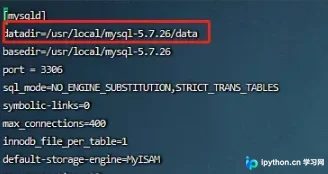
本文解析 MySQL 与 Linux 文件系统的深层关联。从设置 datadir 数据目录入手,说明数据库文件夹和 .db.opt 的生成机制。重点对比 InnoDB 的系统表空间 ibdata1 与独立表空间 idb,以及 MyISAM 的分文件存储(.frm/.MYD/.MYI),揭示不同存储引擎在磁盘上的物理表现。
在MySQL中设置自增主键(AUTO_INCREMENT)的初始值,常用于需要特定ID区间的场景。常用方法包括建表时指定、使用ALTER TABLE修改现有表,以及在删除数据后重置计数器。本文详细梳理了四种核心实现方式及其实际效果对比,帮助用户根据数据保留需求选择最优策略。
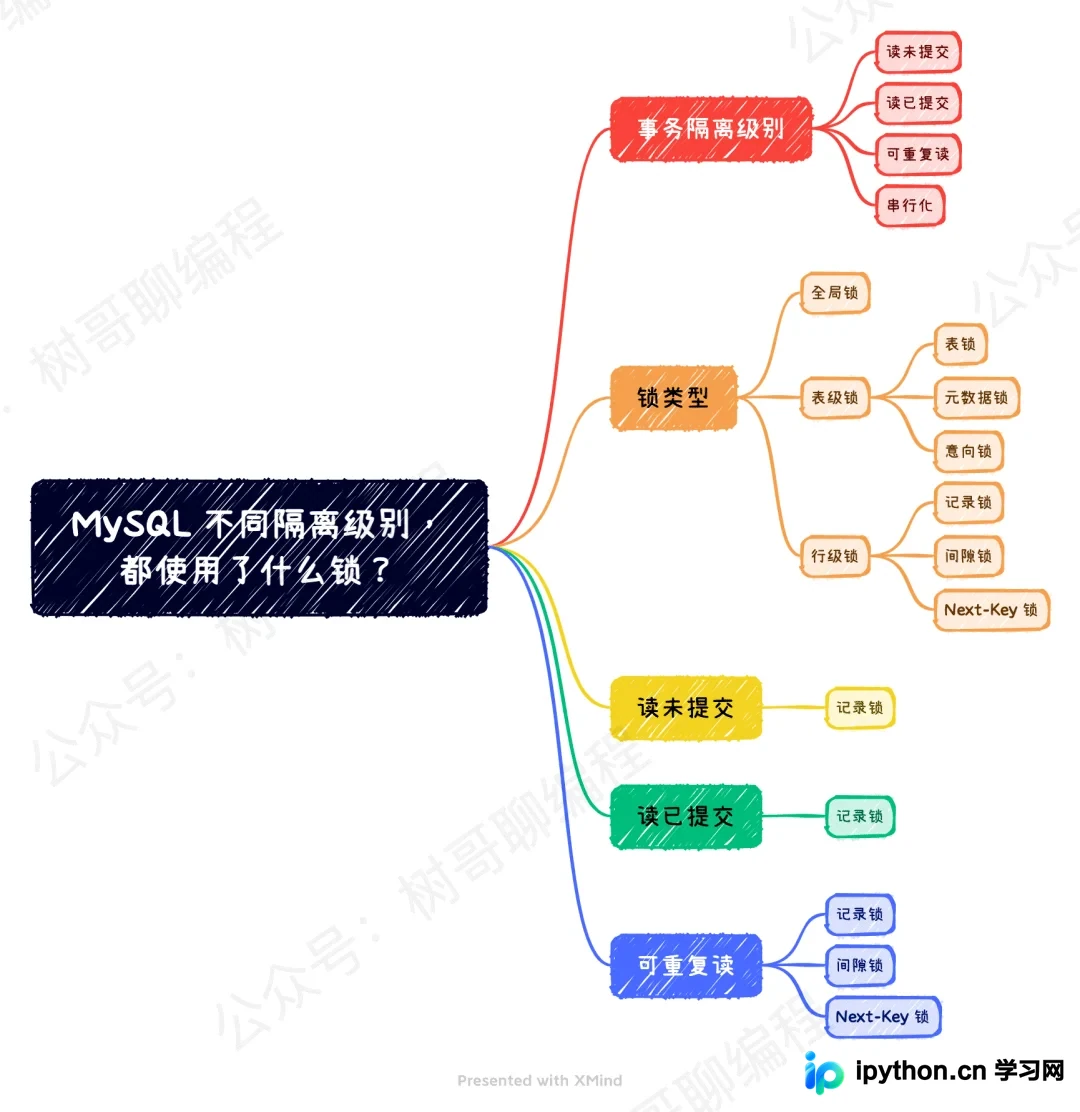
本文深入解析 MySQL 事务隔离级别与加锁机制的关系。通过对比读未提交、读已提交和可重复读三种隔离级别下的并发操作,揭示记录锁、间隙锁和 Next-Key 锁的使用场景,解答为何 MySQL 默认隔离级别能有效避免幻读。
本文总结MySQL创建外键失败的多种原因,涵盖字段类型与字符集不一致、引擎非InnoDB、主外键缺少索引、外键命名重复、级联动作与空值约束冲突等。通过检查表结构参数、修正语法与索引设置,帮助开发者快速定位并解决建表错误,确保关系型数据库引用完整性生效。
本文详细记录使用Python爬取京东商品信息及评论并存入MySQL的全过程。重点解决了SQLAlchemy中非主键字段无法自增的问题,以及应对京东强反爬机制导致的空白页现象。通过对比多线程与单线程加延时的策略,最终确定单线程逐条爬取是避免被屏蔽的有效方案。