

MySQL开发者必备的14个实用技巧与命令
本文总结了MySQL开发中14个高频实用的功能,涵盖聚合分组、字符串处理、时间操作、数据导入导出及性能排查。内容包含group_concat拼接字段、insert ignore去重插入、select...for_update悲观锁机制以及explain分析执行计划等核心知识点,帮助开发者解决复杂查询、并发控制及故障排查问题,提升数据库操作效率。
2026-10-15
6
本文总结了MySQL开发中14个高频实用的功能,涵盖聚合分组、字符串处理、时间操作、数据导入导出及性能排查。内容包含group_concat拼接字段、insert ignore去重插入、select...for_update悲观锁机制以及explain分析执行计划等核心知识点,帮助开发者解决复杂查询、并发控制及故障排查问题,提升数据库操作效率。
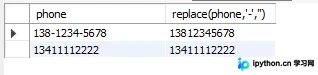
本文详细解析MySQL中REPLACE函数的使用方法,涵盖基础语法、SELECT查询中的即时替换效果及UPDATE语句中的批量数据修正。通过电话号码去连字符、拼写纠错等实例,演示单一替换与嵌套多层替换的操作技巧,并重点提醒列名不加引号的关键注意事项,帮助开发者高效处理数据库文本清洗任务。
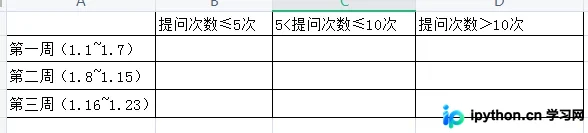
本文详解MySQL中如何利用date_format()和内置日期函数,分别按年、月、周、日对数据进行分组统计。通过具体代码示例展示不同粒度时间的格式化方法,并提供基于自然周计算的复杂业务场景解决方案,帮助开发者灵活处理各类时间维度报表需求。
本文详细解析MySQL索引合并机制,涵盖Intersection(交集)、Union(并集)及Sort-Union三种类型。重点说明在等值匹配、主键范围过滤下的适用条件,对比单索引回表与多索引合并的成本差异,并提供通过联合索引替代索引合并以提升查询性能的优化建议。
本文介绍MySQL中实现多表关联更新的四种核心方法,包括直接列出多表、INNER JOIN、LEFT JOIN以及子查询方式。通过具体代码示例展示如何同步两张表的数据,帮助开发者突破单表更新限制,提升数据处理效率与准确性。
为解决业务中唯一 ID 或高并发场景下的不重复序号需求,本文提供两种 MySQL 自定义序列号的实现方式。方法一通过创建序列表配合原子操作函数 `seq` 获取增量值;方法二构建包含 `f_currval`、`f_nextval` 和 `f_setval` 函数的完整序列管理方案。无需引入外部组件如 ZooKeeper 或 Redis,即可利用数据库自身的事务特性保障并发安全。
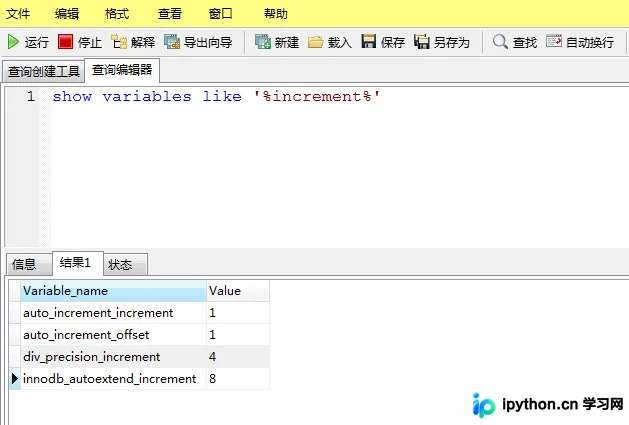
当 MySQL 自增 ID 出现非预期的间隔(如每次增加 2)时,通常是由全局参数 auto_increment_increment 设置不当导致。本文介绍如何通过 SHOW VARIABLES 查看配置,并使用 SET 语句将增量恢复为 1 的具体操作步骤,同时简述了自增 ID 的机制与潜在风险。
当MySQL自增主键步长异常时,通常由auto_increment_increment参数设置引起。本文详解如何查看当前环境配置,并通过SET命令在全局和会话层面将步长恢复为1,确保ID连续增长。同时简述了建表时AUTO_INCREMENT修饰符的作用。
本文通过转账案例深入解析 MySQL 事务机制,阐述如何利用 START TRANSACTION、COMMIT 和 ROLLBACK 保证数据原子性与一致性。详细说明事务的 ACID 特性及 Undo/Redo Log 的作用,并对比脏读、幻读等并发异常,指导用户根据业务场景选择合适的隔离级别以平衡性能与数据安全。
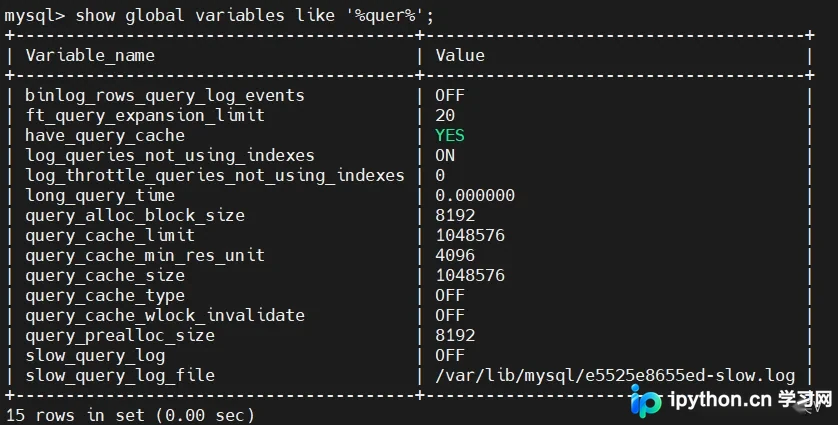
本文详解如何通过MySQL自带的慢查询日志功能定位执行缓慢的SQL语句。涵盖启用日志、设置阈值(long_query_time)、查看日志文件及解析关键字段的方法,并补充了pt-query-digest等高效分析工具的使用场景,帮助DBA快速识别并优化数据库性能瓶颈。
在MySQL中避免插入重复记录,除了使用唯一索引外,还可以利用 INSERT ... SELECT WHERE NOT EXISTS 语句实现条件插入。该方法通过子查询检查主键或特定字段是否已存在,仅当记录不存在时执行插入操作,适用于单条及批量数据的去重处理,有效保障数据完整性。
MySQL服务器CPU占用过高常由大量空闲连接未关闭或复杂查询引起。可通过调整my.cnf中的wait_timeout和interactive_timeout参数减少无效连接,或使用show processlist命令检查Sleep状态的连接数及具体执行语句。及时发现并优化未释放的连接和慢查询是解决性能瓶颈的关键。