

SQL Server 行列互转实战:Pivot/Unpivot 与 CASE WHEN 应用指南
本文详解SQL Server中行列互转的两种核心场景。行转列推荐使用PIVOT操作或动态CASE WHEN聚合,适用于将多行记录合并为单行宽表;列转行推荐使用UNPIVOT或UNION ALL拼接,适用于将宽表数据还原为长表格式。文章提供从SQL Server 2000到2005+版本的动态SQL生成逻辑及静态示例,涵盖静态列、动态列及聚合统计(如总和)的实现细节。
2026-10-16
0
本文详解SQL Server中行列互转的两种核心场景。行转列推荐使用PIVOT操作或动态CASE WHEN聚合,适用于将多行记录合并为单行宽表;列转行推荐使用UNPIVOT或UNION ALL拼接,适用于将宽表数据还原为长表格式。文章提供从SQL Server 2000到2005+版本的动态SQL生成逻辑及静态示例,涵盖静态列、动态列及聚合统计(如总和)的实现细节。
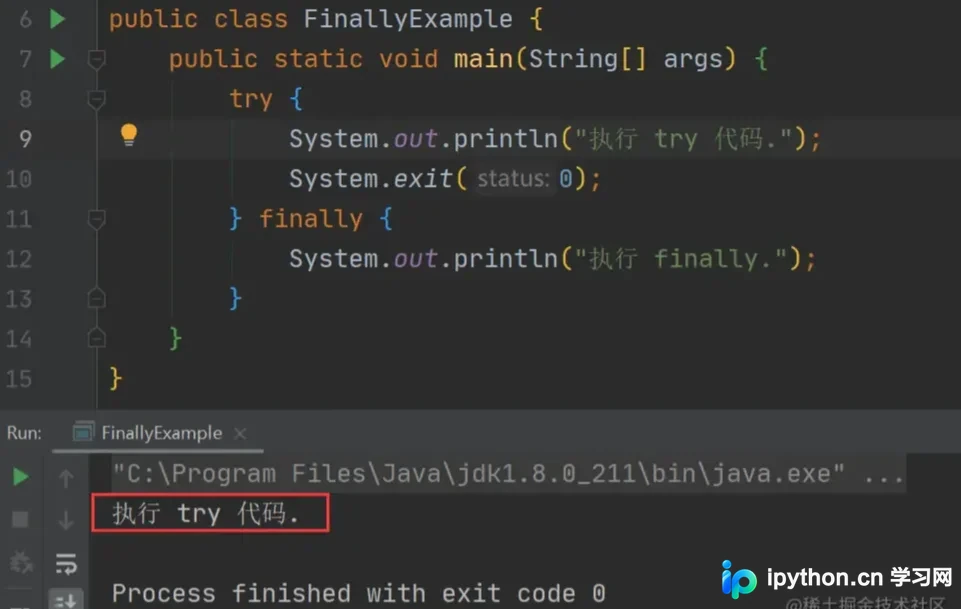
深入解析Java中易混淆的三个概念:final作为修饰符锁定类、方法及变量;finally用于确保代码块无论是否发生异常都能执行,常用于资源释放;finalize是Object类的对象回收钩子,因执行不稳定且性能低下已在JDK9弃用。本文通过示例代码说明其具体行为及最佳实践,帮助开发者避免常见陷阱。
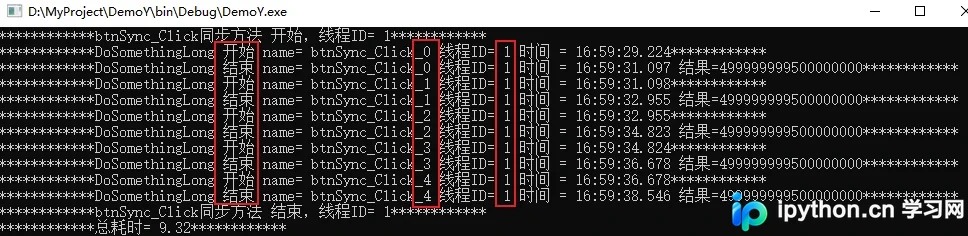
本文详解C#中同步与异步多线程的执行差异,通过代码对比演示BeginInvoke、async/await组合以及回调函数的实现方式,重点讲解IAsyncResult信号量控制及Func泛型返回值的正确获取方法,帮助避免UI阻塞。
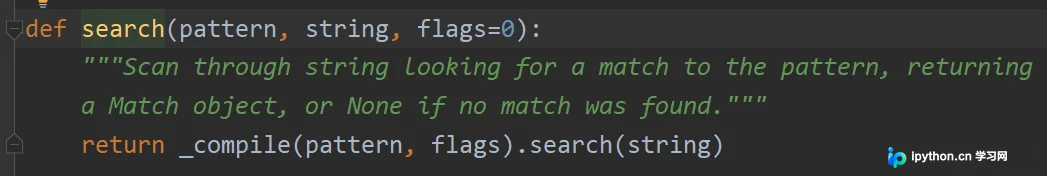
本文深入解析Python中正则表达式模块re的search()函数。详细讲解其匹配机制、可选参数flags(如re.I忽略大小写、re.S包含换行符等)的具体含义,并通过多个代码示例演示如何提取字符串、处理分组匹配及使用命名分组。结合HTML解析实战,对比search与findall的区别,帮助开发者掌握高效字符串匹配技巧。
本文深入解析Python中正则表达式圆括号()的使用陷阱。重点说明re.findall()在有分组时仅返回分组内容,而re.search().group()可获取完整匹配。通过Hive与Python代码对比,阐述括号在分组、字符集及量词中的区别,帮助开发者避免匹配结果不符合预期的问题。
本文通过完整代码示例,展示如何使用Go语言标准库与第三方工具处理CSV考勤文件。涵盖GBK至UTF-8编码转换、命令行参数解析、数据筛选写入JSON文件,以及基于JSON的工时汇总计算。同时提供使用官方csv库和Gin框架实现数据导出的最佳实践,解决中文乱码及内存占用问题。
在微服务架构下,多实例部署常导致资源竞争。本文通过Java代码模拟库存扣减场景,展示未加锁时的数据不一致问题。随后介绍利用Jedis结合SET NX PX命令实现原子性加锁与Lua脚本释放锁的原理,并提供SpringBoot环境下的完整示例代码,确保高并发下的数据准确性。
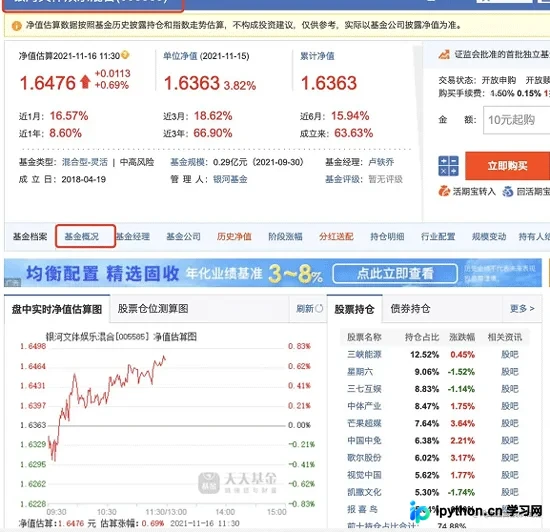
本文详细讲解如何使用Python爬虫获取基金基本信息。针对XPath定位失效的情况,文章演示了如何利用BeautifulSoup库解析HTML页面,通过定位table和td标签提取基金公司、经理、成立时间等关键数据,并展示最终代码实现与结果输出。
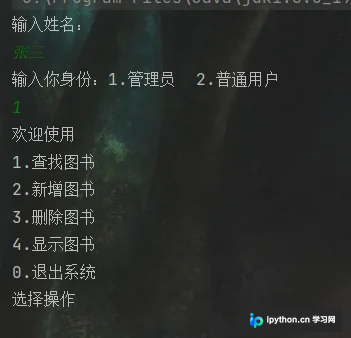
本文详解如何使用Java面向对象思想从零构建一个基于控制台的图书管理系统。通过User继承、IOperate接口实现和Book数组管理,演示封装、多态与设计模式在基础项目中的应用。包含完整的包结构设计与增删改查核心代码逻辑。
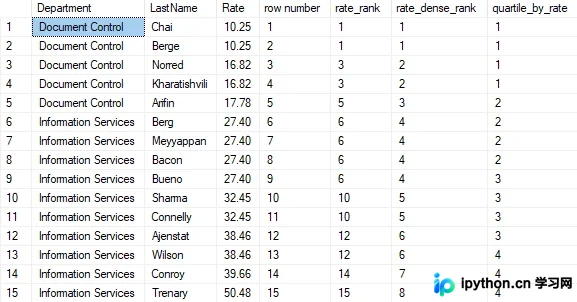
本文详解 SQL Server 中的窗口函数,涵盖 ROW_NUMBER、RANK、DENSE_RANK、NTILE 等排名函数,以及 LAG/LEAD、FIRST/LAST_VALUE、PERCENT_RANK、分位数计算等高级分析函数。通过具体示例演示如何基于 OVER 子句进行数据分组排序与同比环比分析。
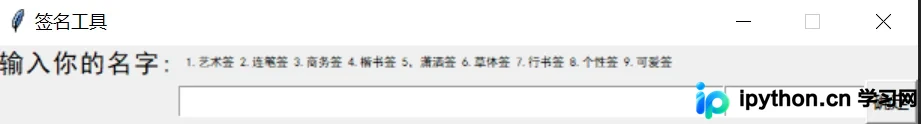
本文介绍如何使用Python结合Tkinter库与网络爬虫技术,开发一个在线个性签名生成工具。通过模拟HTTP请求获取签名网站接口数据,解析返回的图片链接,并在GUI界面中展示及保存生成的签名图片,实现从用户输入到结果展示的完整流程。
本文详解如何在Go中利用crypto包实现AES对称加密。涵盖CBC模式下的数据填充(PKCS7)、字符串加密解密封装,以及针对大文件的流式分块读写与Base64编码方案,附带性能测试参考与操作逻辑说明。