

Go语言切片核心考点解析:扩容策略与传参陷阱
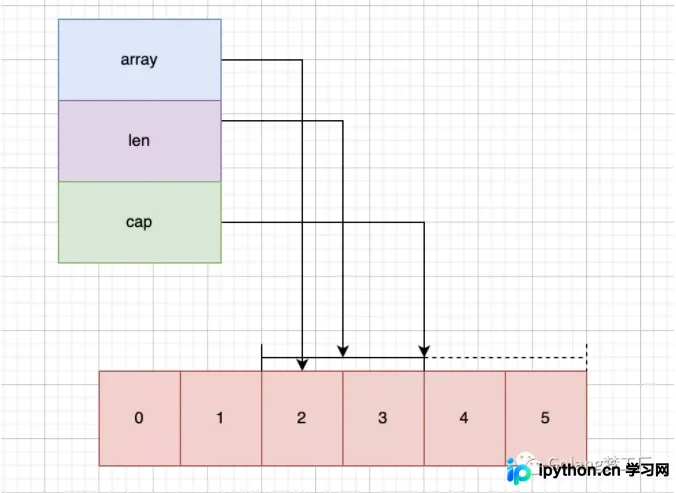
本文深入解析Go语言中切片的常见面试考点。涵盖切片与数组的区别、切片内部结构对性能的影响、零值/空值/Nil切片的辨析,重点剖析growslice源码揭示的2倍及1.25倍扩容逻辑,并详细演示参数传递时的引用失效陷阱以及Range遍历时的值拷贝误区,帮助开发者避开底层隐患。
2026-10-16
0
本文深入解析Go语言中切片的常见面试考点。涵盖切片与数组的区别、切片内部结构对性能的影响、零值/空值/Nil切片的辨析,重点剖析growslice源码揭示的2倍及1.25倍扩容逻辑,并详细演示参数传递时的引用失效陷阱以及Range遍历时的值拷贝误区,帮助开发者避开底层隐患。
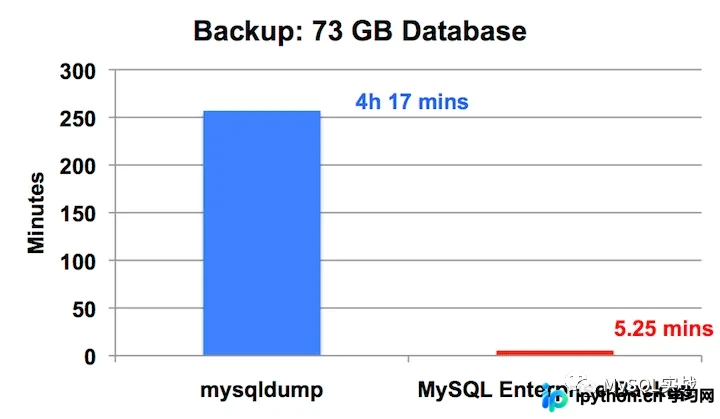
选择MySQL备份工具需综合评估RTO、RPO及存储成本。物理备份速度快但文件大,逻辑备份灵活且移植性强。XtraBackup适合热备全量数据,mysqldump和mydumper常用于逻辑导出。通过定期有效性检测和优化恢复流程,可显著降低数据丢失风险和服务中断时间。
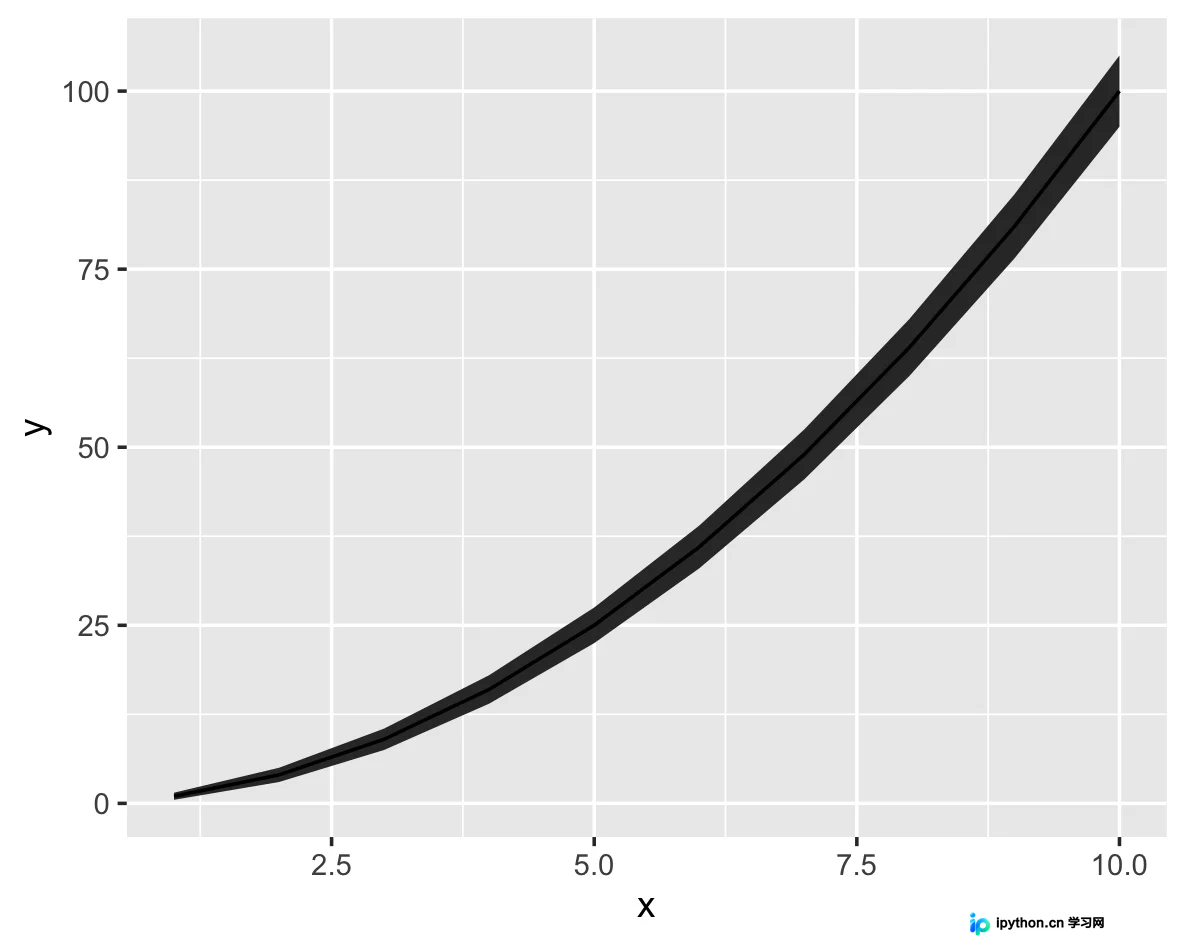
本文详解如何利用 R 语言的 ggplot2 库绘制包含置信区间的折线图。针对单组数据集,演示了 geom_ribbon() 基础用法;针对多组情况,分别讲解了通过 factor 分组和手动指定 aes 参数的两种方法。此外,还提供了调整透明度、线型及去除边框的完整美化代码,帮助开发者快速输出专业的统计图形。
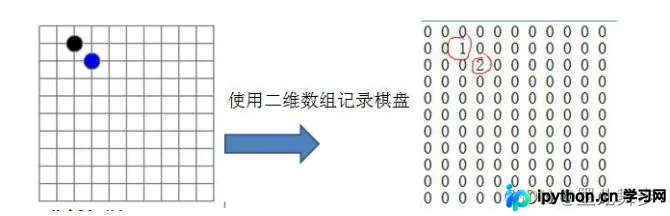
当二维数组中包含大量默认值(如0)时,使用稀疏数组可大幅减少存储空间。本文介绍稀疏数组的原理,并通过Go语言实现将11x11的五子棋棋盘转换为稀疏数组进行存盘,再从稀疏数组还原回原始棋盘,展示具体的代码逻辑与执行流程。
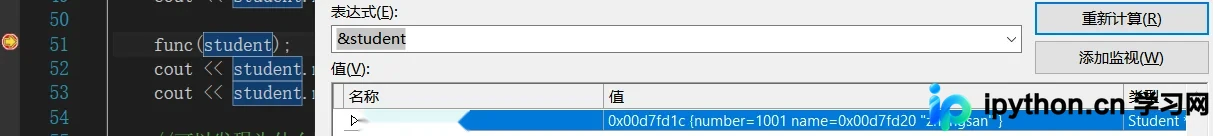
深入解析C++中结构体与类的本质差异及函数调用的三种传参方式。重点对比值传递、引用传递与指针传递的内存地址变化及性能优劣,阐明 struct 默认公有与 class 默认私有的权限控制区别,并提供标准的头文件.h与源文件.cpp代码组织规范,帮助开发者写出高效且符合规范的C++代码。
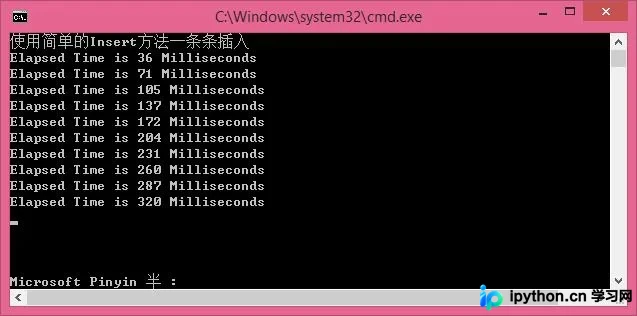
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
本文详细对比了C#中操作Excel的几种主流方式:通过OLEDB查询表快速读取、利用SqlBulkCopy实现数据库高速批量写入、使用Excel COM组件进行复杂的单元格样式与公式编辑,以及NPOI库的应用。文章涵盖了从基础数据导入导出到复杂报表生成的实际操作代码与注意事项,帮助开发者根据数据量级和交互需求选择最优方案。
本文通过完整代码示例,展示如何使用Go语言标准库与第三方工具处理CSV考勤文件。涵盖GBK至UTF-8编码转换、命令行参数解析、数据筛选写入JSON文件,以及基于JSON的工时汇总计算。同时提供使用官方csv库和Gin框架实现数据导出的最佳实践,解决中文乱码及内存占用问题。
深入解析C语言中特殊的柔性数组成员,了解其定义规则、sizeof计算特性以及与指针动态开辟方式的本质区别。通过malloc和realloc的实战代码,掌握如何高效利用连续内存,避免内存碎片并提升CPU访问速度,实现更安全灵活的结构体数据管理。
解决 SQL Server 处理大量数据时的性能瓶颈。本文介绍一个通用的分页存储过程 execByPage,通过动态生成带标识列的临时表,兼容原有 SQL 语句,无需修改应用层代码即可高效返回指定页数据及总记录数,避免游标和复杂 ID 依赖,显著提升大数据量查询速度。
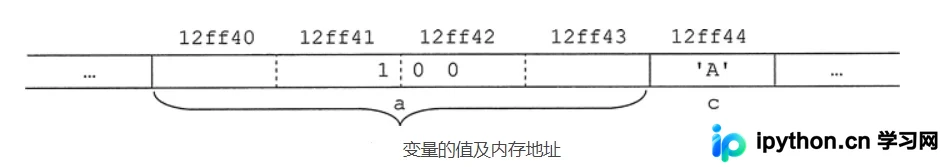
本文深入解析C语言指针的核心机制,阐明指针即地址的本质。涵盖指针类型对访问范围的影响、野指针的成因及初始化安全规范,梳理指针算术运算规则与标准限制,并介绍二级指针及指针数组的使用场景,帮助开发者规避内存错误。
本文通过C语言二维数组实现经典扫雷游戏,讲解如何创建9x9棋盘并扩展为11x11安全区以防止坐标越界。核心逻辑包括初始化棋盘、随机布雷、统计周围雷数及玩家交互循环,帮助理解多维数组在边界处理和逻辑运算中的应用。