Python 20行代码实现批量抠图:基于PaddleHub DeepLabv3+实战
本文介绍如何使用Python和百度PaddleHub库,通过20行代码实现基于DeepLabv3+模型的人像批量抠图。无需复杂训练,直接加载预训练模型即可处理任意尺寸图片,适用于背景清晰的人像处理场景,虽在色彩相近背景下存在局限,但整体效率与效果显著优于手动操作。
2026-10-16
0
本文介绍如何使用Python和百度PaddleHub库,通过20行代码实现基于DeepLabv3+模型的人像批量抠图。无需复杂训练,直接加载预训练模型即可处理任意尺寸图片,适用于背景清晰的人像处理场景,虽在色彩相近背景下存在局限,但整体效率与效果显著优于手动操作。
在 JavaScript 二分查找等算法中,直接使用 `/` 计算中间索引 `min = (low + high) / 2` 会导致结果出现小数,引发非预期行为或死循环。本文分析该错误根源,并介绍使用 `parseInt` 或 `Math.floor`进行向下取整的正确解决方案。
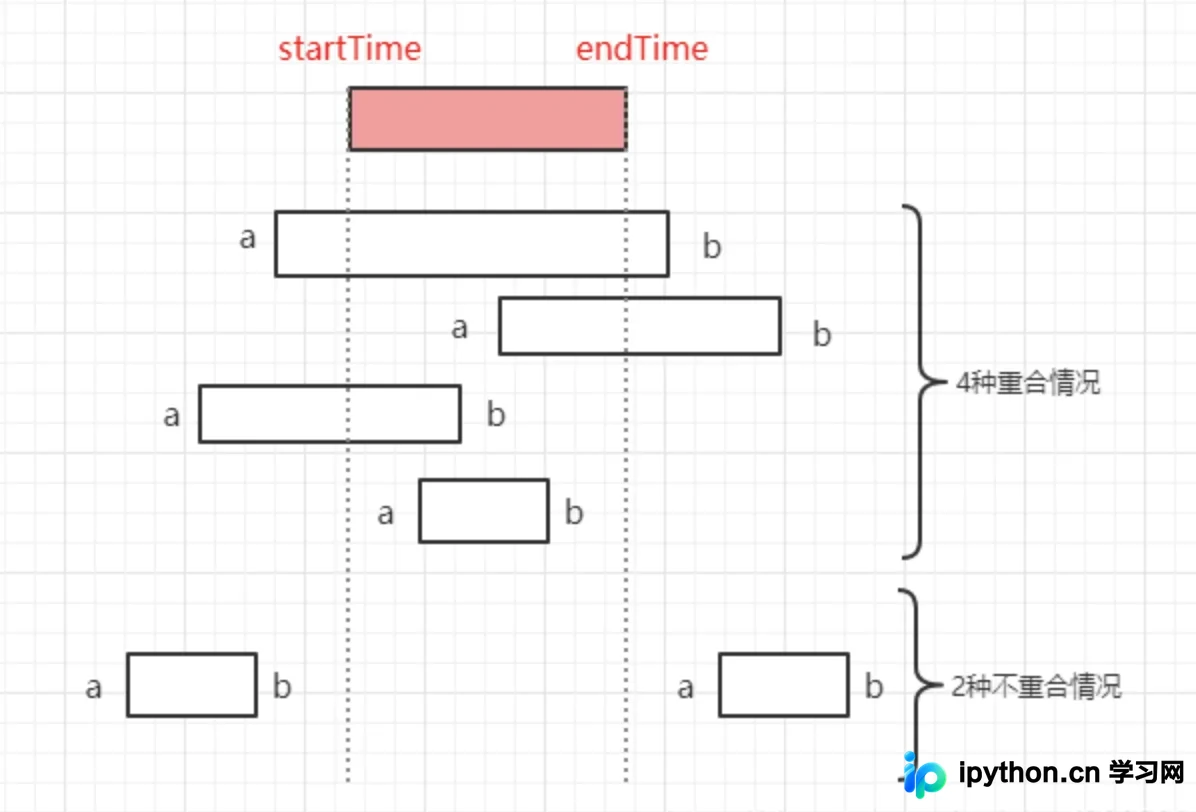
本文介绍了在MySQL中判断两个时间段是否发生重叠的两种高效写法。第一种逻辑直观但略显繁琐,第二种利用取反逻辑极大简化了代码结构。通过清晰的图示解析和SQL示例,帮助用户快速理解并优化数据库中的时间区间查询语句。
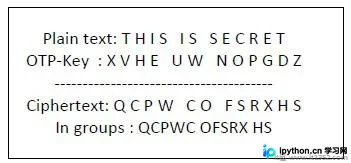
本文详细介绍Python中一次性密码本(One-Time-Pad)的实现方法。文章解析了其作为Vigenere密码变体的不可破性原理,包括密钥长度与明文一致、完全随机及仅使用一次等核心条件。通过安装One-Time-Pad模块,提供命令行工具及Python代码示例,展示如何生成密文与解密过程,并强调密钥管理的重要性。
在 PHP 中使用 foreach 配合引用赋值(&)时,若循环结束后未解除引用,残留的变量引用可能导致后续循环出现逻辑错误。本文将分析该机制的原理,并提供使用 unset() 或索引修改两种标准的修复方案,确保代码健壮性。
本文解析Python神经网络中特征金字塔(FPN)的核心原理。针对小目标在深层网络中特征易丢失的问题,FPN通过自顶向下的上采样与横向连接,融合高低层语义信息,有效增强小目标检测能力。结合YOLO3等结构示例,阐述其下采样与上采样机制,为模型优化提供理论参考。
本文提供基于PHP实现的ISBN-10与ISBN-13格式校验函数。核心逻辑通过计算前N位数字的加权和并取模,推导最后一位校验码,并与实际输入进行比对。代码涵盖权重计算、校验码生成(含ISBN-10的'X'处理)及长度验证,可直接调用以判断图书编码的结构合法性。
TypeScript 的类型缩小是指在特定执行路径中缩小变量类型的过程,主要依赖类型保护机制。本文详解四种常用保护符:typeof 用于基础类型区分,平等比较利用 switch/== 实现字面量收窄,instanceof 处理对象实例判断,in 操作符基于属性存在性区分类别。通过具体函数示例掌握这些语法,提升代码安全性与智能提示准确性。
在MySQL开发中,即使建立了指索,查询依然缓慢往往是因索引失效所致。本文深入剖析导致索引失效的七种典型场景:字段类型隐式转换、表达式计算、使用内置函数、左模糊匹配、违背最左前缀原则、OR条件缺失索引以及IN/NOT IN的影响。通过EXPLAIN分析执行计划,可精准定位问题并制定优化策略。
本文介绍如何使用Go语言的singleflight机制解决热点Key缓存失效导致的数据库冲击问题。文章通过代码示例详细阐述了其去重合并请求的核心原理,展示了如何确保同一时刻对同一Key只执行一次数据获取操作,从而降低系统负载并优化高并发场景下的性能表现。
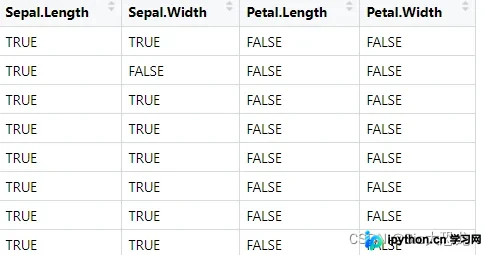
本文详细解析R语言中常用的apply系列函数,包括按行列操作的apply、返回列表的lapply、简化返回类型的sapply、分组聚合的tapply以及多参数并行的mapply。通过iris数据集等真实示例,说明各函数的输入参数、运行逻辑及返回值类型差异,帮助快速掌握数据批量处理技巧。
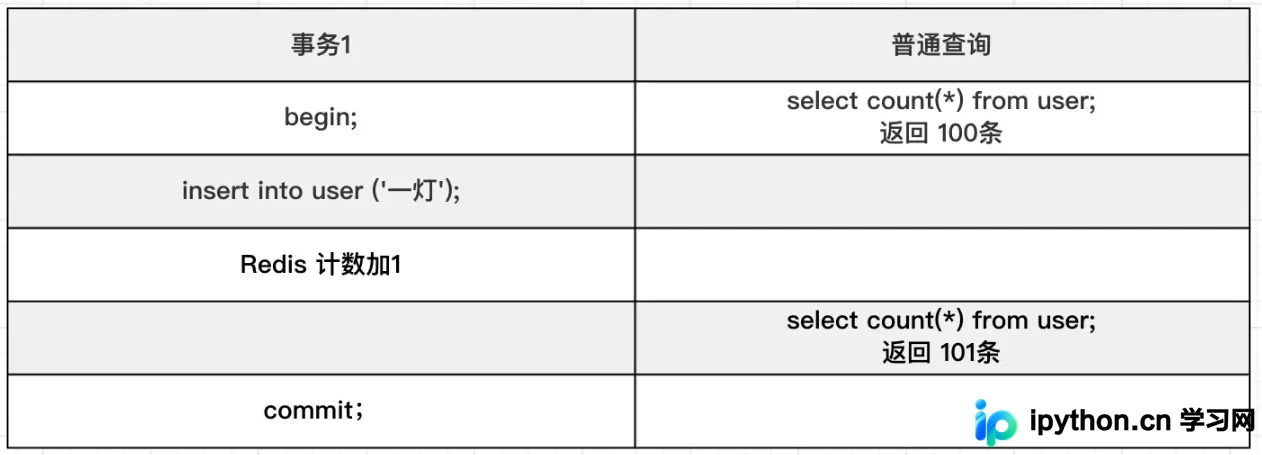
针对MySQL InnoDB引擎下count(*)统计耗时过长的问题,分析MyISAM与InnoDB的行数记录机制差异。介绍使用show table status估算行数的快速方案,对比count(*)、count(id)及count(字段)的性能差异,并指出Redis等缓存方案在处理高并发事务时的局限性,提供实用的查询优化建议。