SQL中UNION与UNION ALL的正确用法及常见陷阱
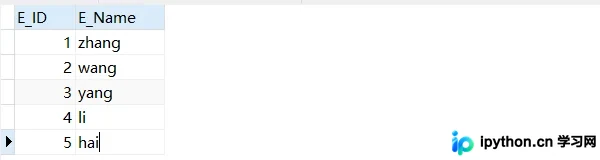
本文详细解析SQL中UNION与UNION ALL的核心区别:前者自动去重并排序,后者保留所有记录且性能更高。通过具体查询示例说明字段数量、数据类型及顺序的一致性要求,重点剖析在聚合统计场景下因类型混淆导致的数值累加错误,并提供避免此类陷阱的实操建议。
2026-10-13
0
本文详细解析SQL中UNION与UNION ALL的核心区别:前者自动去重并排序,后者保留所有记录且性能更高。通过具体查询示例说明字段数量、数据类型及顺序的一致性要求,重点剖析在聚合统计场景下因类型混淆导致的数值累加错误,并提供避免此类陷阱的实操建议。
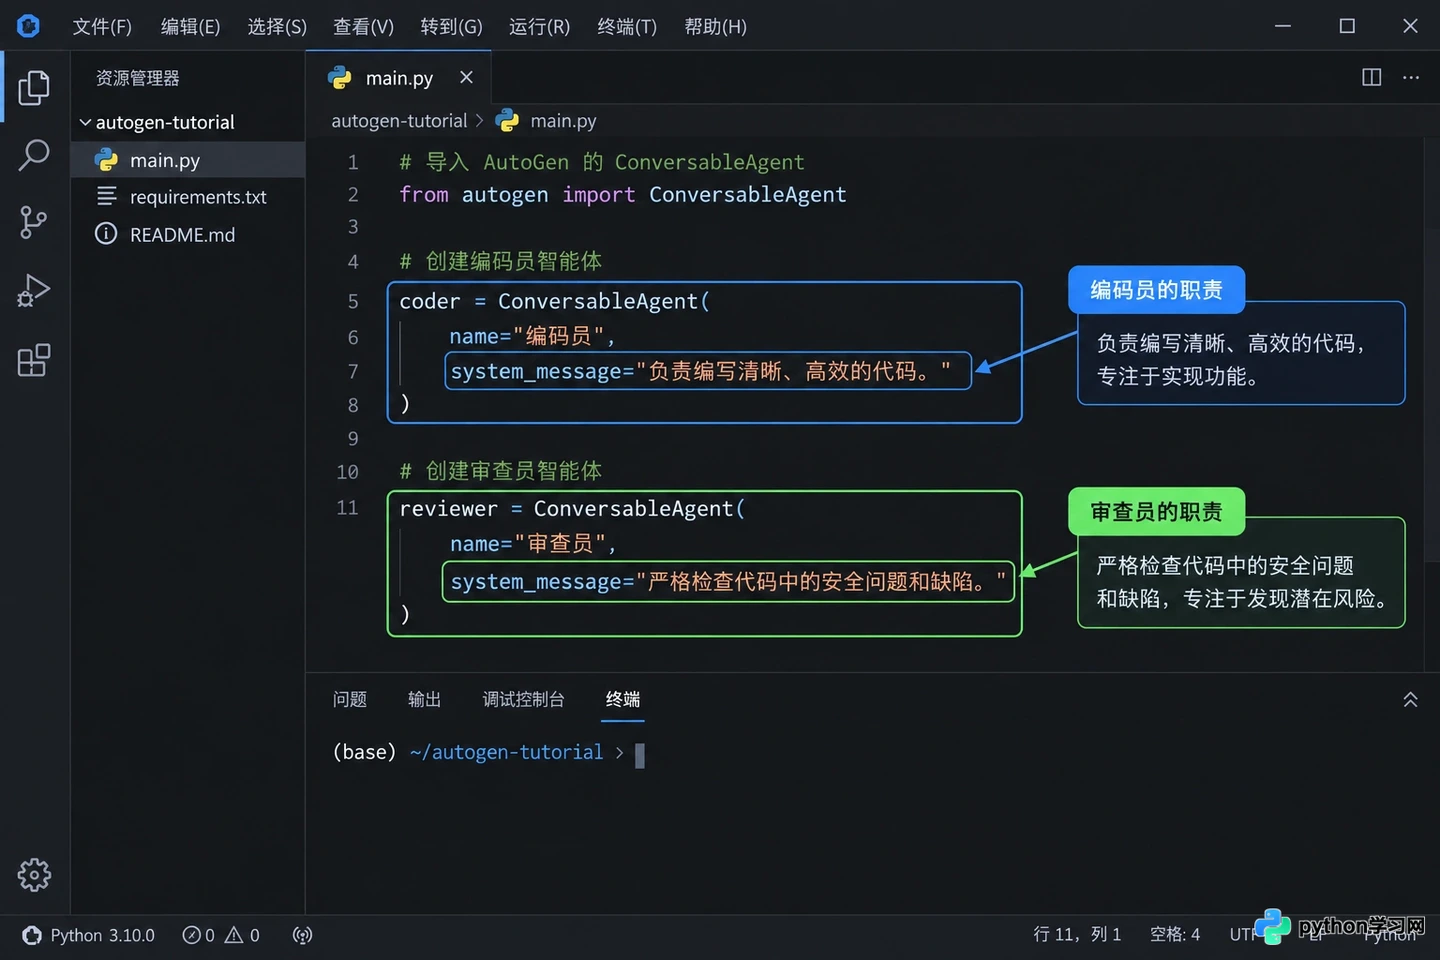
本文深入探讨如何利用AutoGen框架构建多智能体协作系统,通过角色定义、群组聊天管理和任务分发机制,解决单智能体在复杂任务中的能力瓶颈,实现从代码生成到审查的自动化工作流。
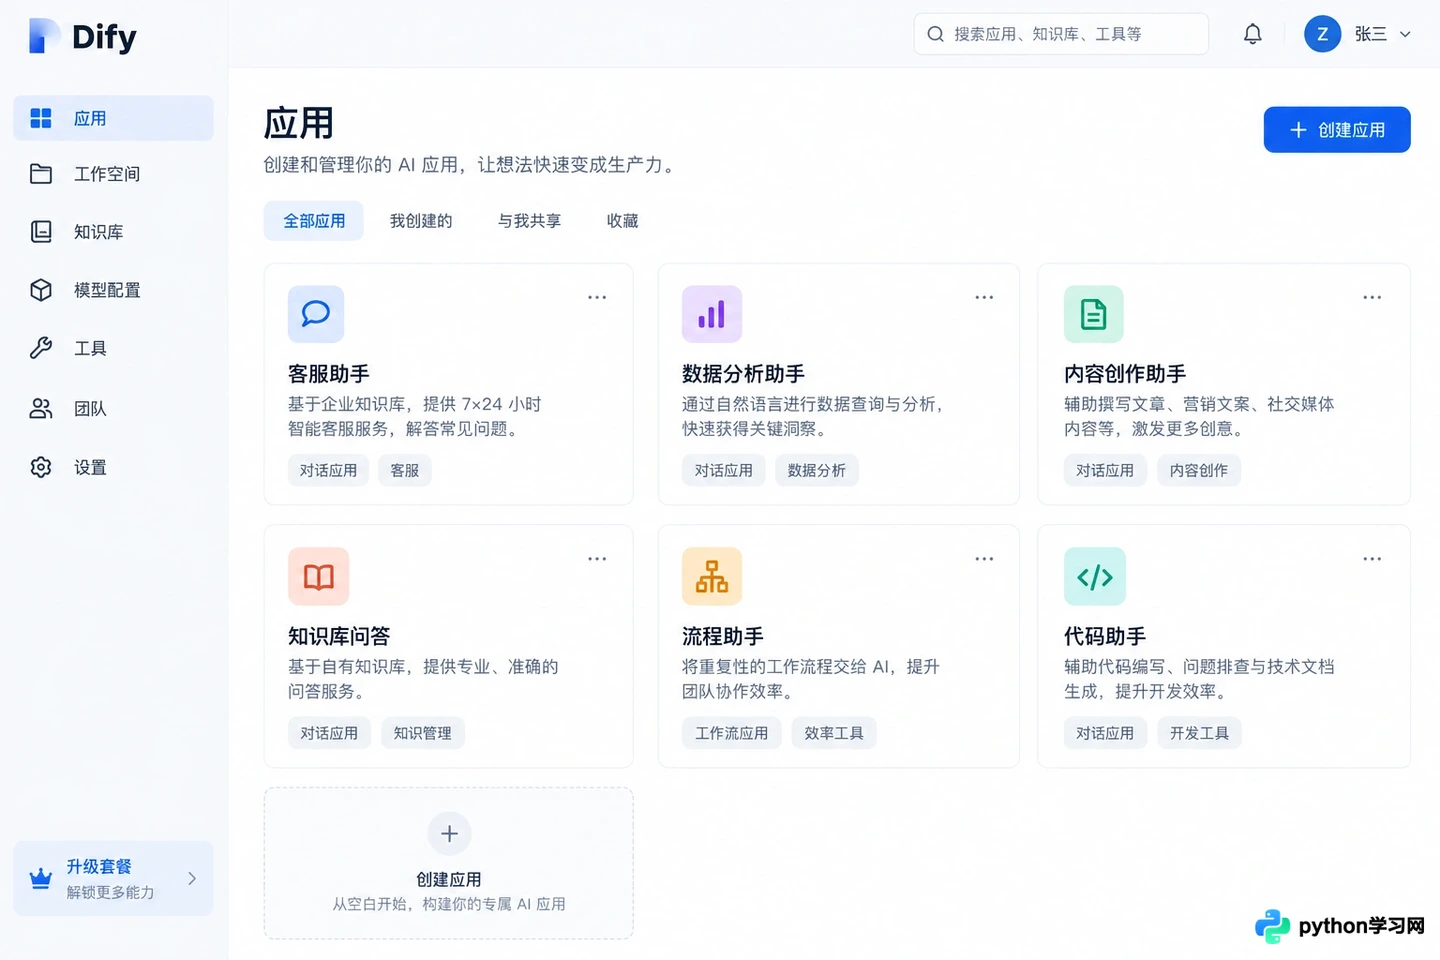
本文深入解析 Dify 作为开源 LLM 应用开发平台的核心价值。通过工作流编排、RAG 知识库构建及后端即服务(BaaS)特性,阐述其如何降低 AI 应用开发门槛,帮助开发者从原型快速过渡到生产环境,解决大模型落地中的工程化难题。
本文提供使用PHP通过ODBC驱动连接Access等数据源并实现数据分页显示的完整代码。详细展示了如何计算总页数、构建首页/前页/后页/尾页链接,以及利用odbc_fetch_into按行提取数据并渲染为HTML表格的过程。该方案适用于需要直接操作ODBC数据源的场景。
本文详细解析 MySQL 主从同步的原理,包括 binlog、I/O 线程及 relay log 的工作机制。通过 Master 开启日志、创建专用用户,以及 Slave 配置 server-id 并执行 CHANGE MASTER TO 命令,实现数据自动备份与读写分离,确保高可用性架构稳定运行。
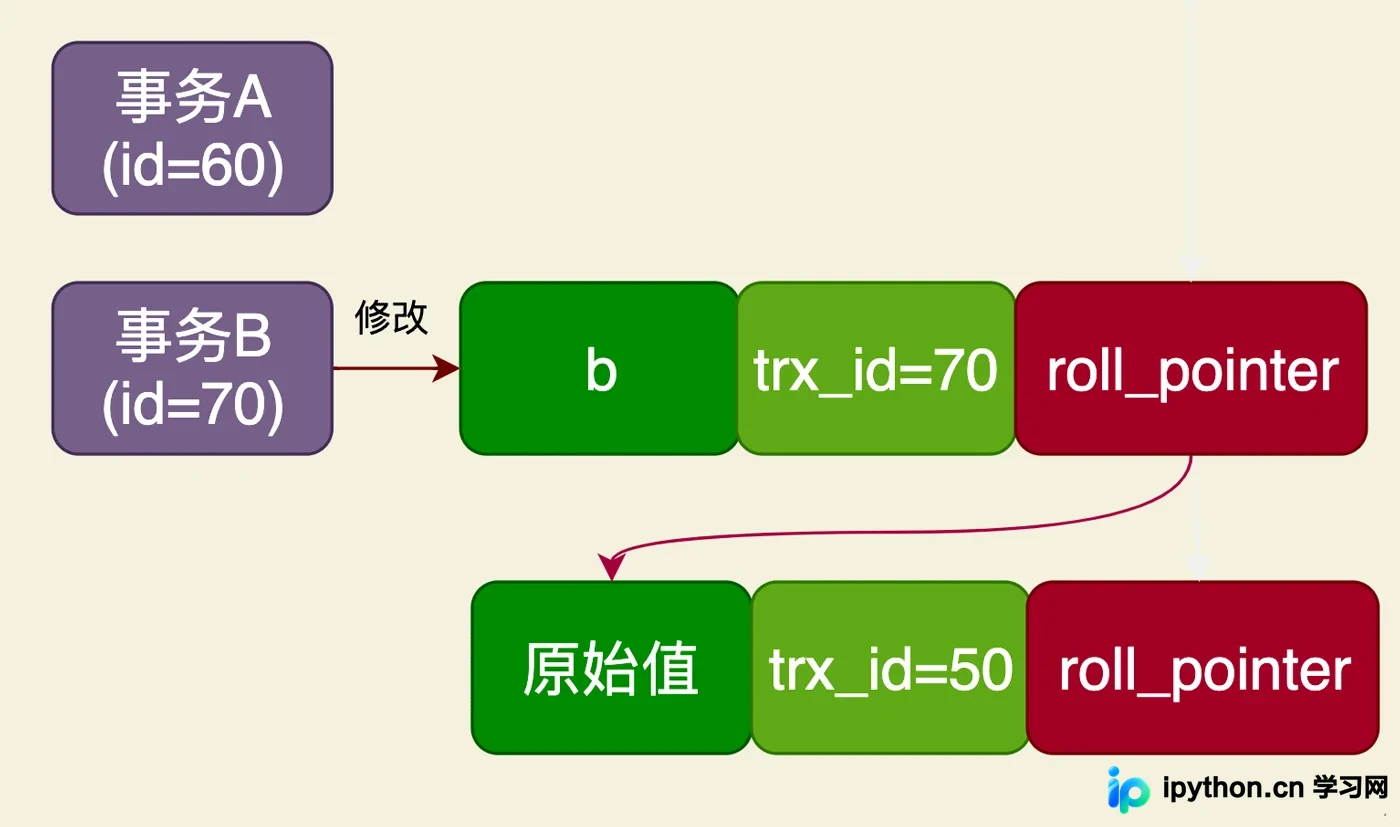
MySQL的RC(Read Committed)隔离级别通过每次查询动态生成ReadView来解决部分数据可见性问题。本文解析ReadView机制如何结合Undo Log版本链条,判断trx_id是否属于活跃事务。相比RR级别,RC在每次读取时刷新视图,从而允许读取到其他已提交事务修改的数据,但仍无法解决不可重复读中的幻读问题。
本文整理了Go语言Beego框架的Web开发常用语法,涵盖控制器重定向、ORM模型字段定义(主键、自增、默认值等)、处理POST字符串及文件上传请求、查询数据以及前端模板循环渲染与时间格式化。适合快速查阅Beego核心开发细节。
本文详解PHP开发中的核心安全原则,强调不信任外部数据。通过正则表达式实现输入清洗,禁用危险的register_globals设置以提升代码可控性。重点讲解如何利用mysql_real_escape_string()或预处理语句有效防止SQL注入攻击,确保Web应用安全。
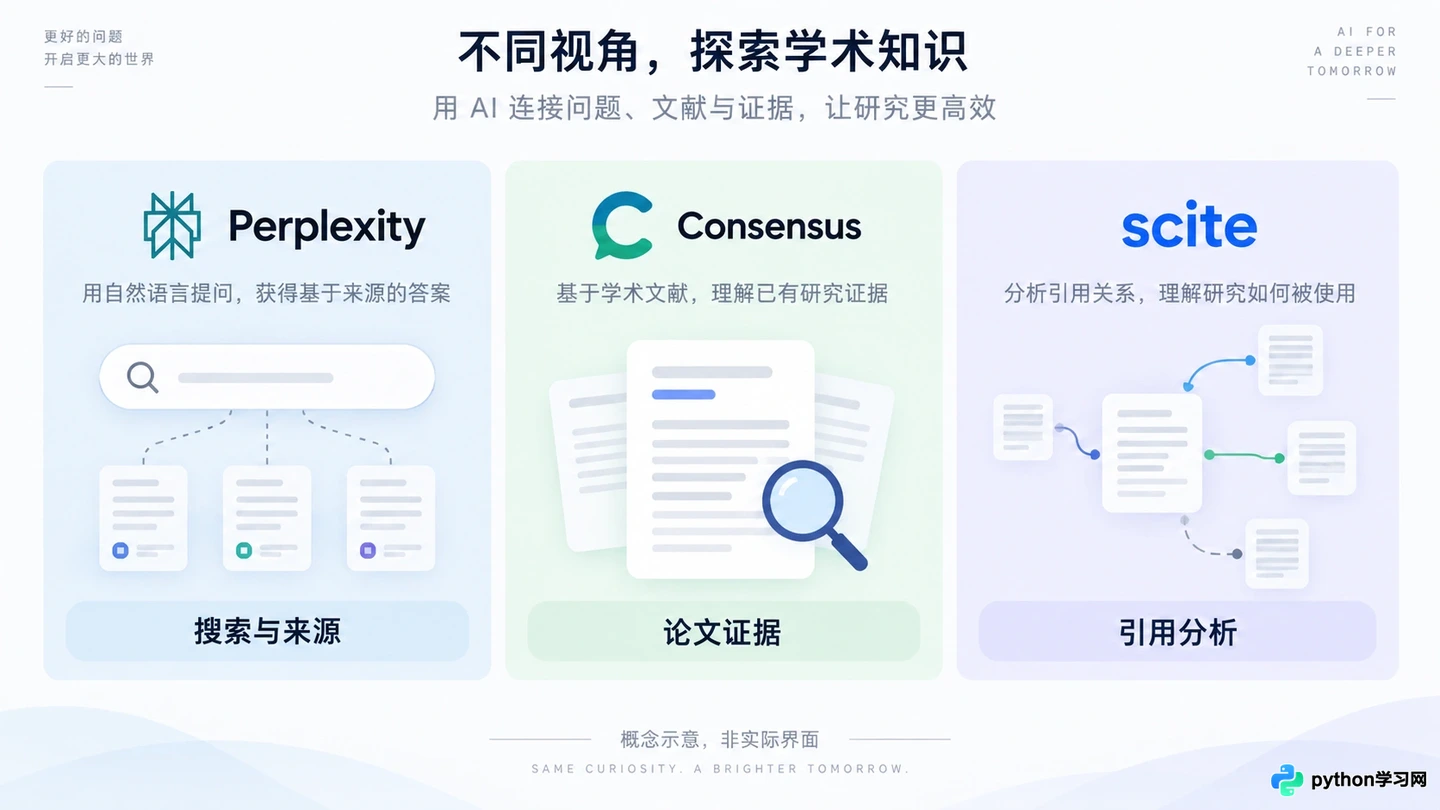
针对学术研究场景,对比Perplexity、Consensus和Scite三款支持来源引用的AI搜索工具。文章从界面布局、引用机制和适用场景三个维度进行导览,帮助研究者快速建立对新一代学术搜索工具的认知地图,解决传统搜索信源难追溯的痛点。
本文解决如何在MySQL中筛选“进行中”状态的数据,核心在于处理开始或结束时间可能为空的情况。通过 `IS NULL` 结合 `NOW()` 函数,实现四种时间边界条件的统一查询。同时提供MyBatis动态SQL的XML配置示例,确保参数灵活传入时逻辑依然准确。
在MySQL中执行PREPARE和EXECUTE时,可能偶尔遇到“Unknown prepared statement handler”错误。本文通过源码追踪发现,该问题源于Percona Server等修改版MySQL中Prepared_statement::set_name函数在拷贝语句名时,未预留字符串结束符\0所需的额外字节,导致内存越界且查找匹配失败。解决方案是将内存分配长度由name_arg.length改为length+1。
针对电商商品检索等场景,介绍MySQL数据同步至Elasticsearch的四种主流方案。包括实现简单的同步/异步双写、成本低但实时性差的定时任务,以及侵入性小、支持复杂聚合的Canal数据订阅方案。通过对比各方案的优缺点及适用场景,辅助技术选型。