

SQL中UNION与UNION ALL的正确用法及常见陷阱

在SQL开发中,UNION用于合并多个SELECT结果集并自动去重,而UNION ALL则直接返回所有记录以提升性能。使用UNION时必须确保各语句的列数、数据类型和顺序严格一致,否则会导致执行错误或数据逻辑偏差,特别是在涉及聚合计算的场景中需格外注意字段对齐。
UNION与UNION ALL的区别
SQL中的UNION操作符用于将两个或多个SELECT语句的结果合并为一个结果集。其核心行为包括:
- 自动去重:UNION会移除重复的行,只保留唯一值。
- 默认排序:通常会对最终结果进行隐式排序(取决于数据库实现)。
- 结构一致性:所有参与联合的SELECT语句必须具有相同数量的列,且对应的列数据类型兼容,列顺序也必须一致。
相比之下,UNION ALL不进行去重处理,而是直接将所有结果拼接,因此执行效率高于UNION,适用于不需要去重的场景。
第1步:基础语法与执行效果对比
首先明确两者的基本语法结构,并通过实际数据验证其差异。
1. UNION 基础用法(去重)
假设有两张员工表:employees_china和employees_usa。
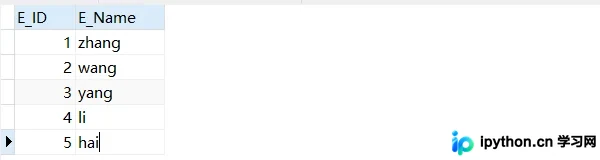
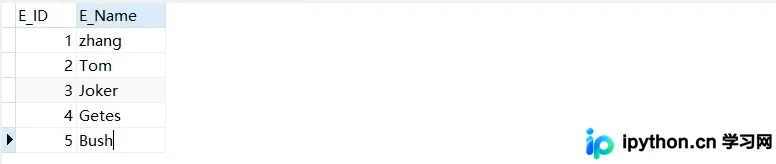
执行以下查询:
SELECT E_ID, E_Name FROM employees_china
UNION
SELECT E_ID, E_Name FROM employees_usa;
该查询会合并两表数据并去除重复行(如果存在相同的ID和姓名组合),结果如下:
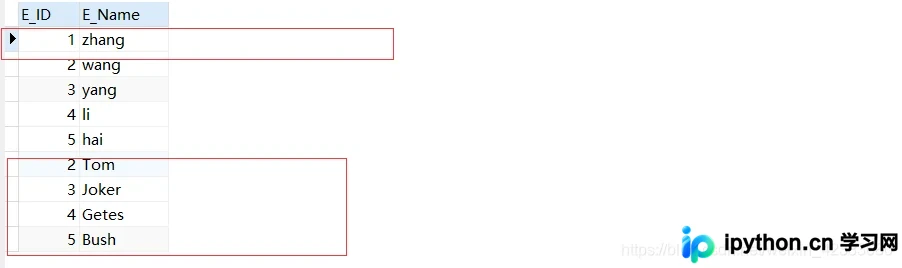
2. UNION ALL 基础用法(保留重复)
使用UNION ALL执行相同查询:
SELECT E_ID, E_Name FROM employees_china
UNION ALL
SELECT E_ID, E_Name FROM employees_usa;
此时,结果集将包含所有原始记录,即使存在完全重复的行也不会被过滤:
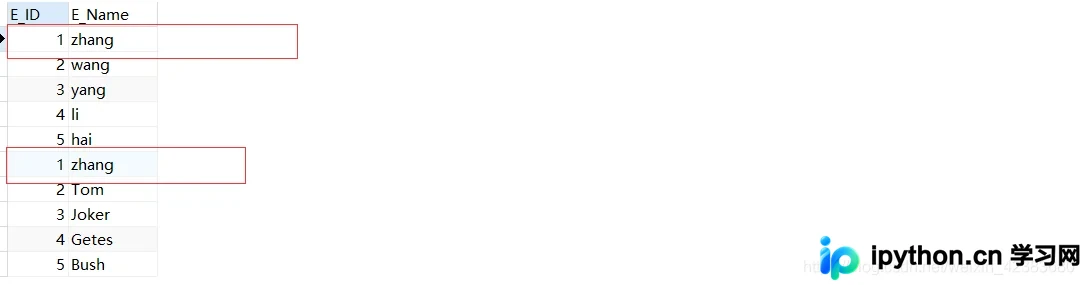
第2步:处理字段不一致的情况
当参与联合的表字段不完全一致时,必须通过补位操作使列数和结构保持一致,否则数据库会报错。
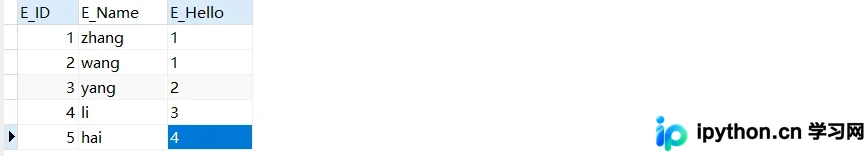
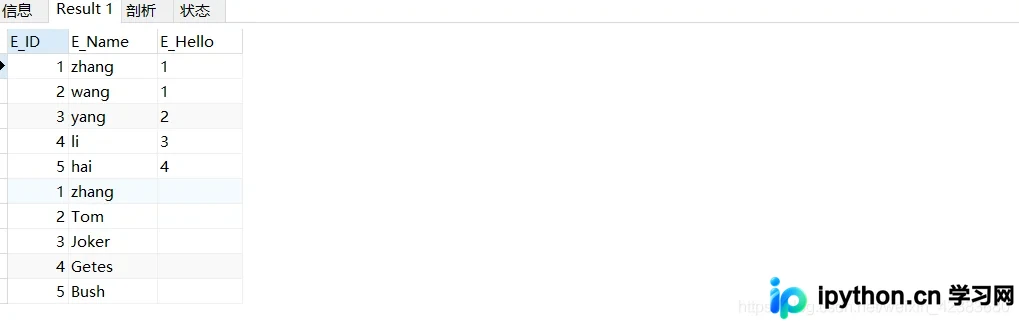
假设employees_china包含E_Hello字段,而employees_usa没有该字段。为成功使用UNION ALL,需在第二个SELECT中对缺失字段使用占位符(如空字符串):
SELECT E_ID, E_Name, E_Hello FROM employees_china
UNION ALL
SELECT E_ID, E_Name, '' AS E_Hello FROM employees_usa;
修正后的结果集结构统一,查询正常执行:
UNION操作的常见陷阱
尽管语法简单,但在复杂查询中使用UNION时极易陷入逻辑误区,尤其是在结合聚合函数或GROUP BY时。
第3步:识别聚合场景下的逻辑错误
典型风险在于对非预期数据进行累加统计。
例如,若某业务表中既有"红色"分类也有名为"79"的分类,在使用UNION合并统计结果时,若未仔细检查字段映射,可能会将数字"79"误认为是某种类型的数据标签,进而与其他"颜色"类别一起参与汇总,导致统计结果严重失真。
示例数据:
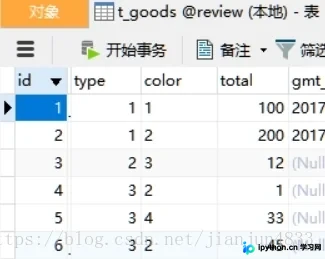
错误的关联查询或不当的类型转换可能导致如下误导性结果:
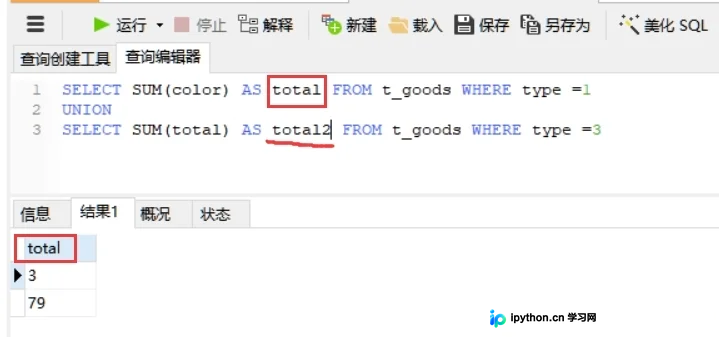
图中展示了一个典型的坑:系统可能将数值型字段"3"和"79"在未经过严格类型校验的情况下,作为普通"类型"文本处理,从而参与后续的SUM或COUNT聚合,造成数据混乱。
关键注意事项总结
- 结构优先:使用UNION前,务必保证每个SELECT语句的字段数量、顺序和数据类型完全一致。
- 性能考量:除非明确需要去重,否则优先使用UNION ALL,因其跳过去重比对步骤,执行速度显著更快。
- 排序规则:如需对最终合并结果排序,应在最后一个SELECT语句末尾添加ORDER BY子句。
- 结果集定义:UNION生成的结果集中,列名始终采用第一个SELECT语句中定义的列名。
- 警惕类型混淆:在处理多源数据合并时,特别注意字段含义是否匹配,避免因同名异义(如ID与代码)导致的逻辑错误。
以上就是SQL中UNION与UNION ALL的正确用法及常见陷阱的详细内容,更多关于SQL语句union的用法与注意事项的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









