Scrapy爬虫生产环境部署完整指南:Scrapyd与ScrapydWeb实战
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
2026-10-15
0
本文详细介绍Scrapy爬虫在生产环境中的服务器部署方案,涵盖Scrapyd服务端、ScrapydClient客户端及ScrapydWeb可视化管理工具的安装与配置。通过具体命令演示项目上传、爬虫启动及参数传递,并结合实际爬取数据展示部署效果与常见问题分析,帮助开发者实现高效、可视化的爬虫集群管理。
本文详细介绍使用Flask框架搭建轻量级API服务的完整流程。内容涵盖数据库配置、全局DB对象定义及数据转码工具类的构建。重点演示了五种SQL查询接口的实现方式,包括无参查询、常规参数传递及复杂的IN参数处理。针对IN参数在URL中的多种传值形式(逗号分隔或多次重复键),提供了可靠的解析方案,并展示了标准化的错误处理与JSON响应返回机制,旨在为开发者提供一套可直接复用的API开发模板。
本文深入解析OpenCV中的图像标注技术,涵盖边界框、多边形分割及语义分割等核心方法。通过Python代码示例,详细演示如何使用cv2模块手动绘制直线、圆形和矩形边界框,并基于K近邻(KNN)算法实现图像颜色分割,为机器学习模型训练提供高质量标注数据。
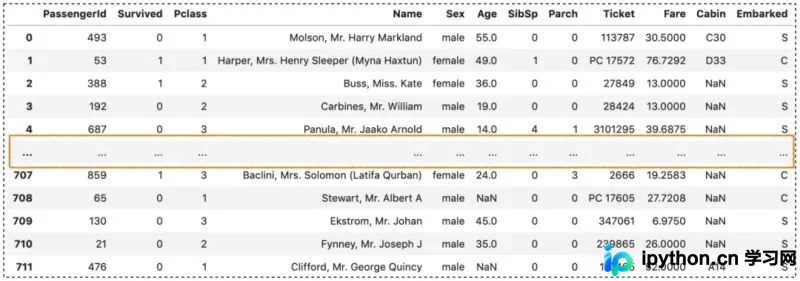
本文详解Pandas中8个常用的set_option配置,涵盖最大行数、列数、列宽、浮点精度、数字格式化及绘图后端等设置。通过调整display相关参数,可优化交互式数据展示效果,提升数据分析效率。
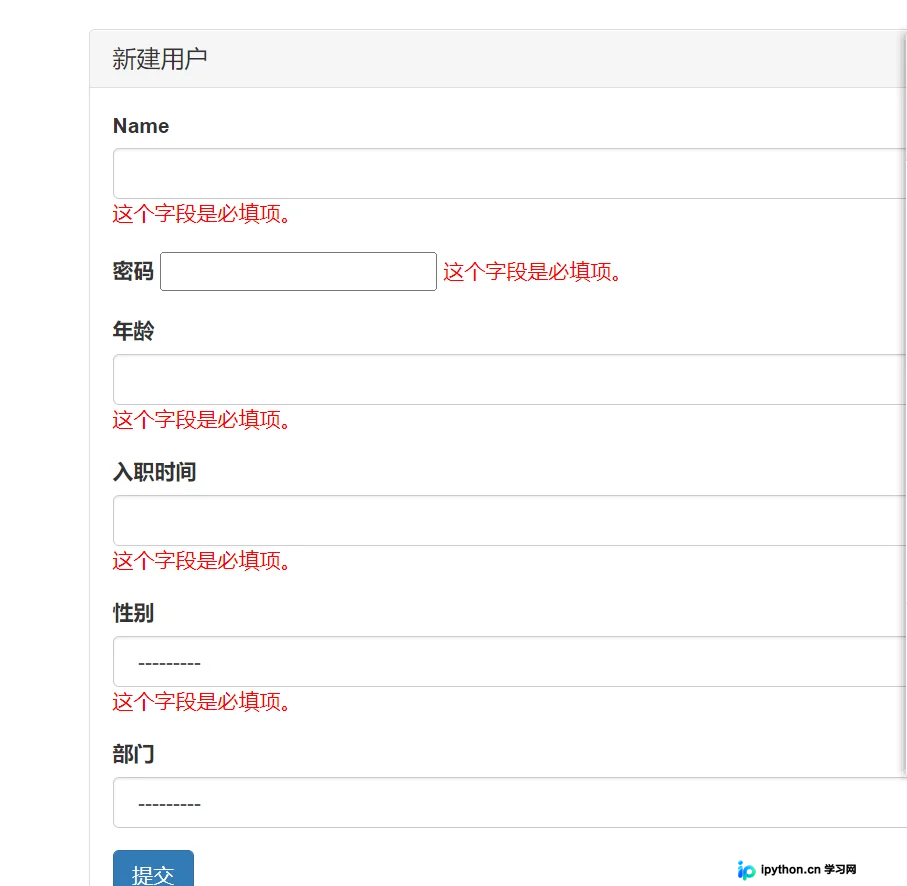
本文详解Django中模板继承与ModelForm的核心用法。通过{% block %}实现HTML复用,利用ModelForm自动绑定模型字段、生成表单HTML、执行数据校验并直接保存至数据库,解决手动处理表单繁琐及缺乏错误提示的问题。
本文详解Django中JWT身份验证的实现机制,涵盖认证与授权的区别、JWT结构解析及存储方案对比。重点介绍将JWT存入Cookie以防范XSS攻击的方法,并提供包含登录视图与Token校验装饰器的完整Django代码示例,帮助开发者安全构建API认证系统。
本文深入解析 NumPy 中 shape 属性的含义及其在多维数组中的应用。通过具体代码示例,展示如何创建一维至四维数组,理解 shape 元组中各数字代表的维度长度,并掌握使用冒号进行多维切片的具体操作与结果分析。
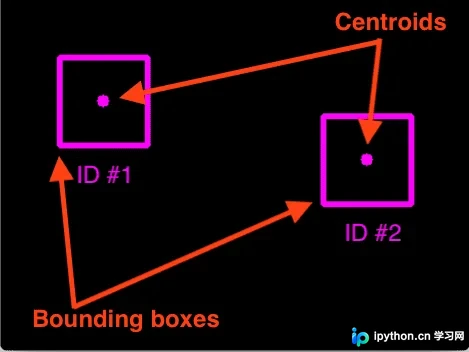
本文详解利用OpenCV实现质心跟踪算法的完整流程。从获取边界框、计算质心、欧几里得距离匹配到新对象注册与旧对象注销,逐步解析核心逻辑。附带CentroidTracker类与驱动脚本的Python源码,适用于视频流中的人脸或物体实时跟踪场景。
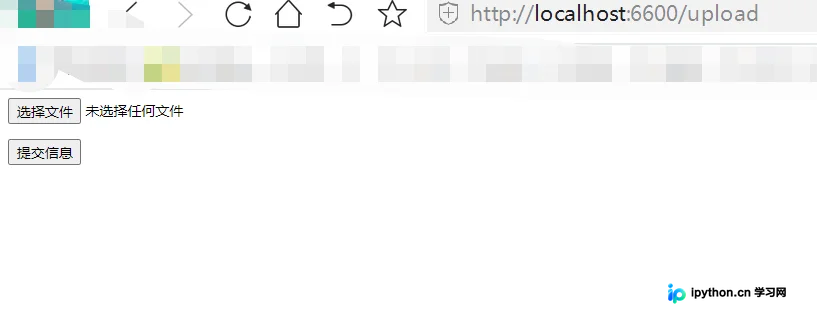
本文介绍在Flask框架下实现图片上传及前端显示的两种方法。方法一通过保存文件后渲染模板显示图片;方法二直接读取文件流并返回响应。文章包含完整的后端Python代码、前端HTML表单及目录结构说明,端口默认设置为8987,适用于本地及服务器部署。
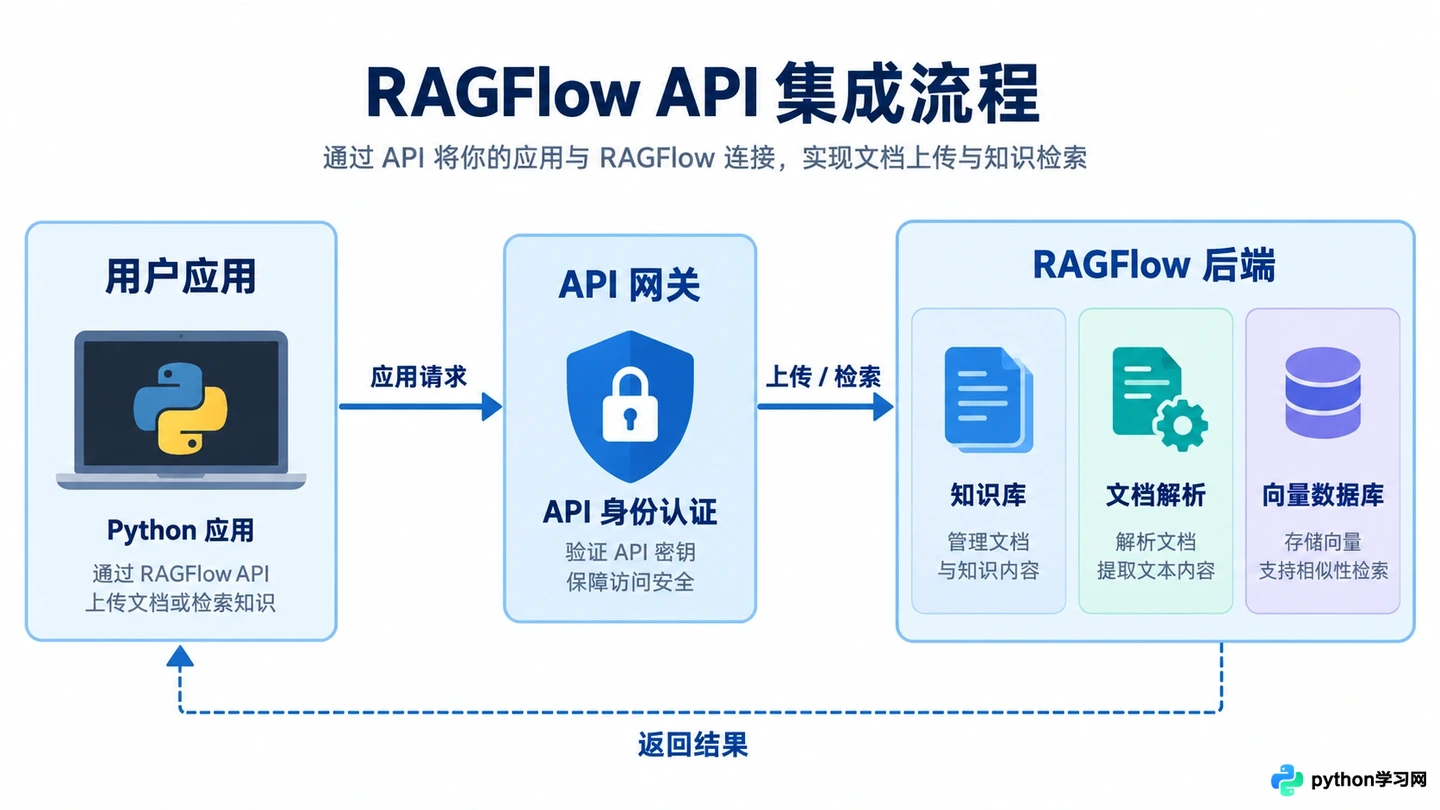
本文介绍如何通过 RAGFlow API 将知识库检索能力集成到业务系统中。涵盖获取 API Key、创建数据集、上传文档、解析配置及执行检索问答的完整流程,帮助开发者快速实现基于私有数据的智能问答功能。
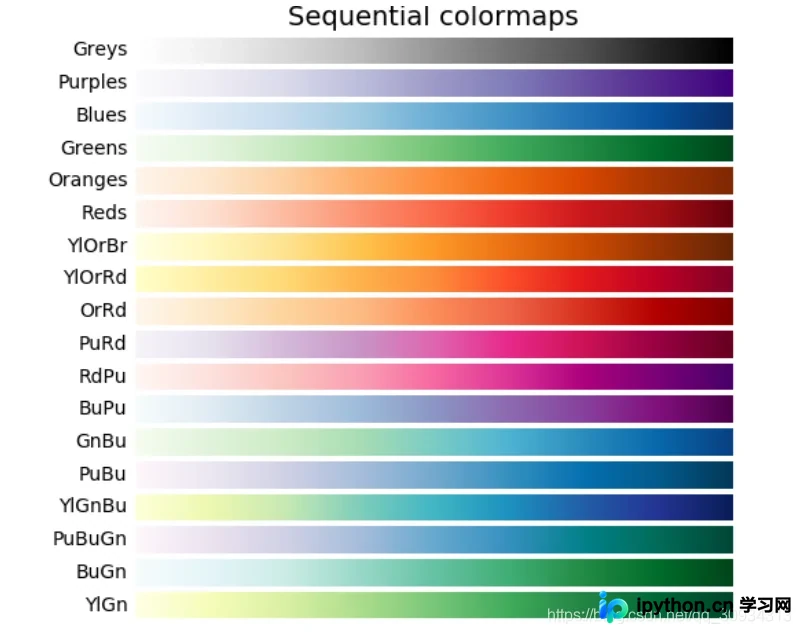
本文详细介绍matplotlib中柱状图、散点图、折线图及箱型图的核心参数。涵盖颜色映射cmap的使用,以及各图表类型的x/y轴数据、透明度、线型、异常值处理等关键属性的具体取值与默认行为,帮助开发者快速掌握可视化配置技巧。
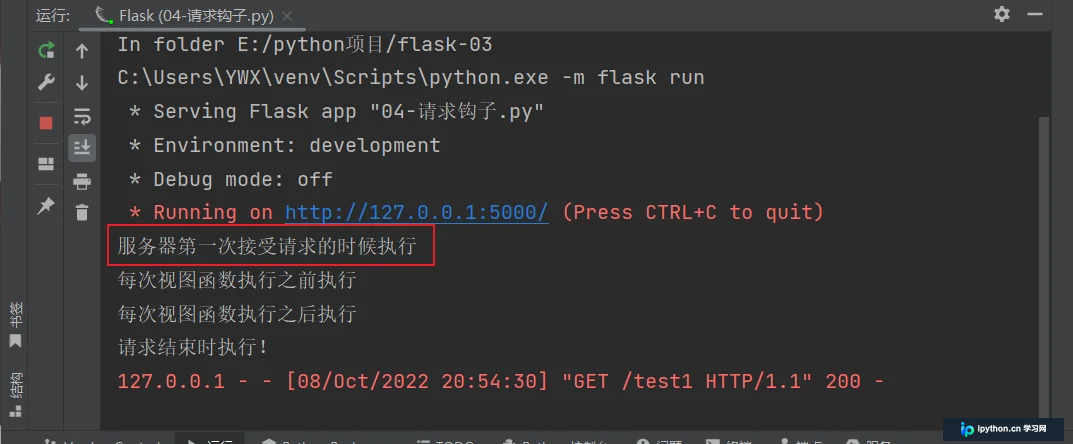
本文详细解析Flask框架中的核心机制。首先介绍四种请求钩子(before_first_request、before_request、after_request、teardown_request)的执行时机与作用;其次区分请求上下文(request、session)与应用上下文(current_app、g)的使用场景;最后讲解如何通过abort主动抛出HTTP异常,并利用errorhandler装饰器捕获和处理自定义错误页面。