

Auto.js Node.js 模式优化 UI 布局代码管理
针对 Auto.js Node.js 模式中直接嵌入 XML 代码导致难以格式化和维护的问题,本文介绍通过将 UI 布局代码分离为独立 XML 文件并利用 fs 模块读取的方法。具体步骤包括创建 layout-xml.xml 文件、编写读取函数以及在 App 对象中动态加载布局,从而提升脚本代码的可读性与可维护性。
2026-10-15
4

针对 Auto.js Node.js 模式中直接嵌入 XML 代码导致难以格式化和维护的问题,本文介绍通过将 UI 布局代码分离为独立 XML 文件并利用 fs 模块读取的方法。具体步骤包括创建 layout-xml.xml 文件、编写读取函数以及在 App 对象中动态加载布局,从而提升脚本代码的可读性与可维护性。
本文介绍Python中docx2txt库的安装与基本用法,演示如何通过命令行或代码从.docx文件中提取纯文本及图片。此外,深入探讨了利用python-docx库解析Word底层XML结构的方法,包括如何识别并提取目录(std标签)和文本框(textbox标签)内容,以及如何通过处理pPr标签还原段落格式,解决文本域保存不显示的问题。
本文详细介绍Python标准库xml.etree.ElementTree的使用方法。涵盖通过parse()和fromstring()解析XML文件,遍历节点、获取属性与文本数据,以及修改、添加和删除节点的操作。同时演示如何创建新的XML文档,并解决原生保存无缩进的问题,提供格式化输出的实用代码示例。
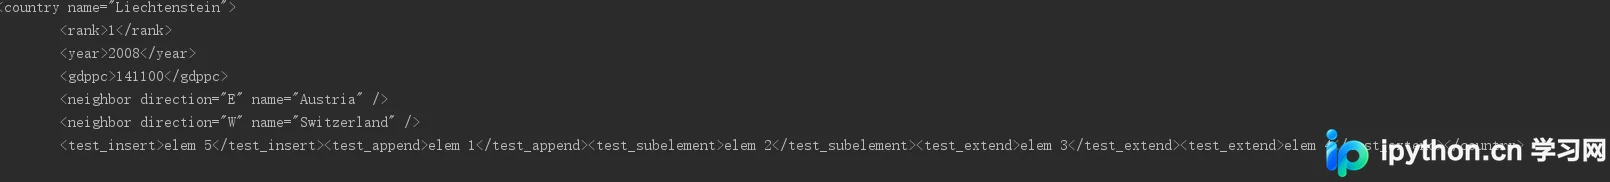
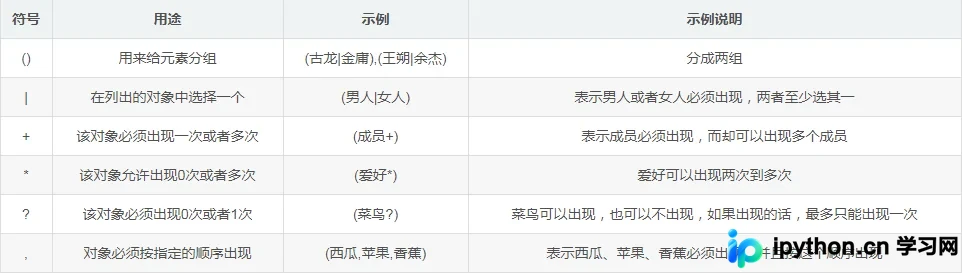
本文详细介绍在Python生成XML文件时如何正确声明和引用DTD文档。内容涵盖内部DTD与外部DTD(SYSTEM与PUBLIC)的区别、DTD基本语法如ELEMENT定义、元素组合类型修饰符以及属性类型的五种分类与特点,帮助开发者规范XML结构。
本文系统讲解Python读取XML文件的方法,涵盖XML基础概念、结构特征及两种主流解析库的使用。通过xml.dom.minidom模块演示节点属性获取、子标签遍历及文本提取,并结合ElementTree模块介绍批量遍历技巧,帮助开发者掌握XML数据处理的实战技能。
本文详细介绍Python中解析XML文件的三种主要方式:SAX、DOM和ElementTree。重点讲解基于事件驱动的SAX解析器及其ContentHandler回调机制,以及将XML加载为内存树结构的DOM解析方法。通过具体代码示例,展示如何利用xml.sax和xml.dom.minidom模块处理大型文件或特定数据提取,帮助开发者根据场景选择合适方案。
本文介绍如何利用C#中的LINQ to XML技术,通过XDocument和XElement类动态生成结构化的XML文件。详细讲解了如何设置XML声明、添加根节点、子元素及其属性,并提供完整的WinForms事件处理代码示例及生成的XML结果参考,帮助开发者快速掌握基于对象模型构建XML的方法。
本文介绍如何利用Python内置的xml.etree模块,将XML格式数据高效转换为TXT文件。重点解析批量处理包含多个XML文件的文件夹场景,通过遍历目录、解析树结构并提取指定标签文本,实现自动化数据提取与格式转换,适用于数据分析前的预处理环节。
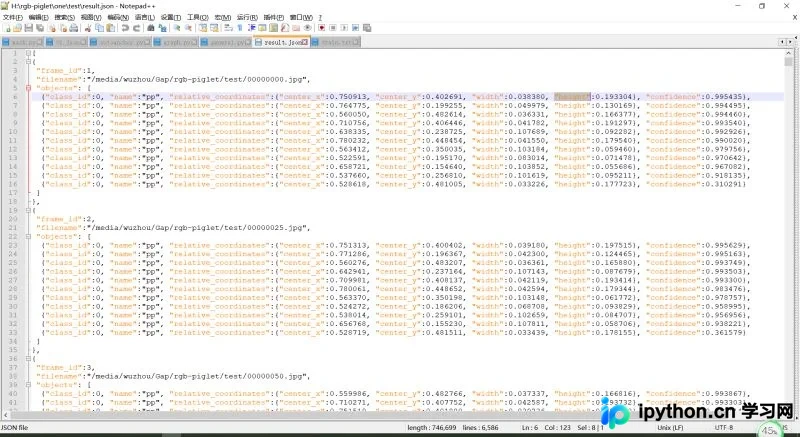
本文介绍如何使用Python将YOLOv4模型输出的JSON检测结果转换为VOC标准的XML格式。通过解析包含图片路径、目标类别及归一化坐标的JSON数据,程序自动生成符合VOC规范的XML文件,便于后续模型训练与评估。
本文详细介绍Python中解析和修改XML文件的两种核心方法:xml.etree.ElementTree与xml.dom.minidom。通过ElementTree,您可以轻松遍历节点、提取文本与属性,并使用set()、SubElement()及pop()方法实现XML内容的增删改。Minidom则提供基于DOM标准的解析方式,适合需要完整文档对象模型操作的场景。
本文分享一个基于C# System.Xml命名空间的XmlHelper辅助类。该类封装了使用XmlDocument进行XML文档管理的常用方法,包括创建XML文件、插入节点及子元素、更新指定XPath节点的属性与文本值、删除整个节点或特定属性,以及查询单个或列表节点数据。适合需要快速处理配置文件中XML数据的.NET开发场景。
本文深入剖析Python应用中常见的十大安全隐患,涵盖输入注入、断言误用、计时攻击、临时文件、YAML与XML解析风险、依赖污染及序列化问题。针对每种漏洞提供具体的代码示例与修复建议,帮助开发者构建更安全的Python应用。