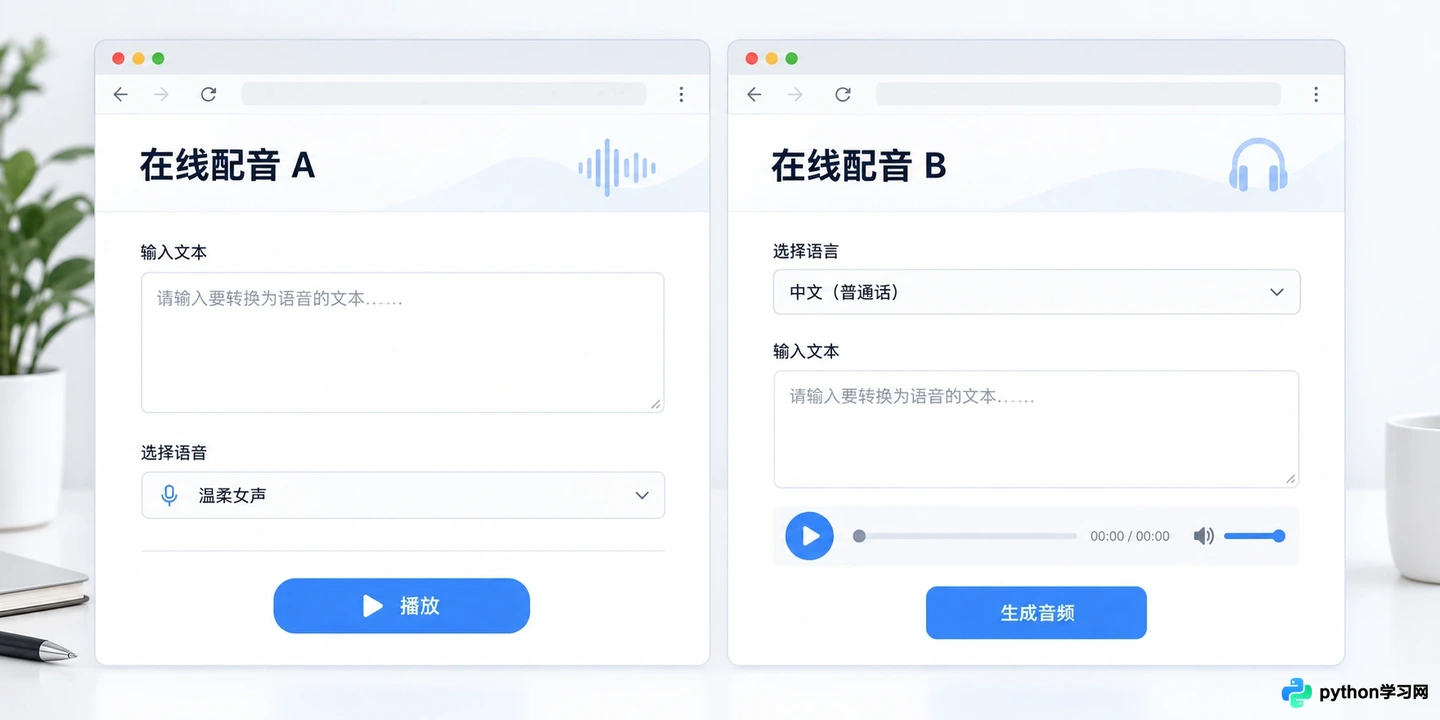
怎么优化在线AI配音的断句与情感表达
本文介绍通过调整标点符号、使用多音字标注及微调语速停顿参数,解决AI配音机械感强、停顿不合理的问题,提升听感自然度。
2026-10-21
46

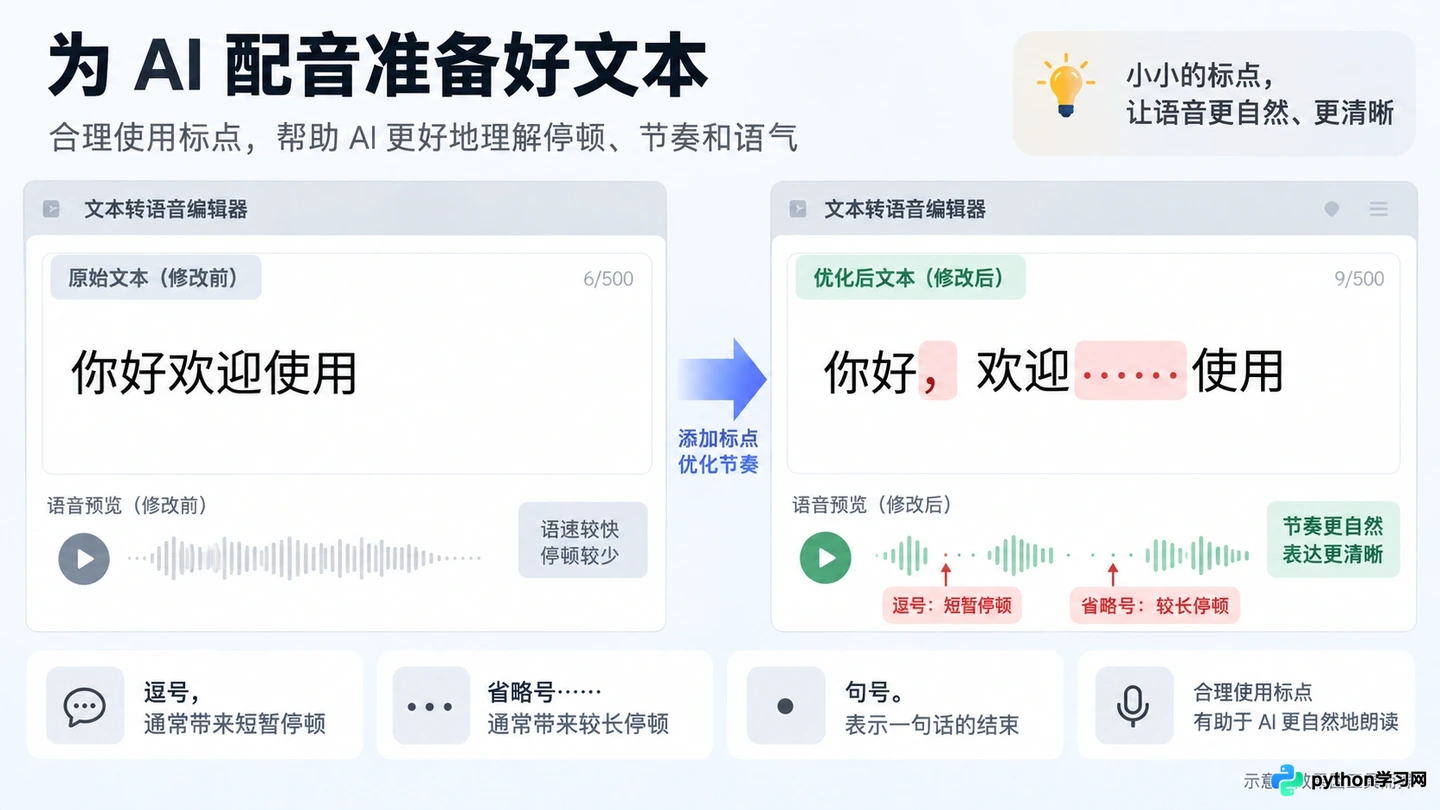
本文针对AI视频翻译中常见的口型不同步和语音生硬问题,从唇形同步技术、语音情感还原及后期微调三个维度提供解决方案。通过合理选择工具参数与后期处理技巧,帮助创作者提升跨国内容传播的自然度与专业感。
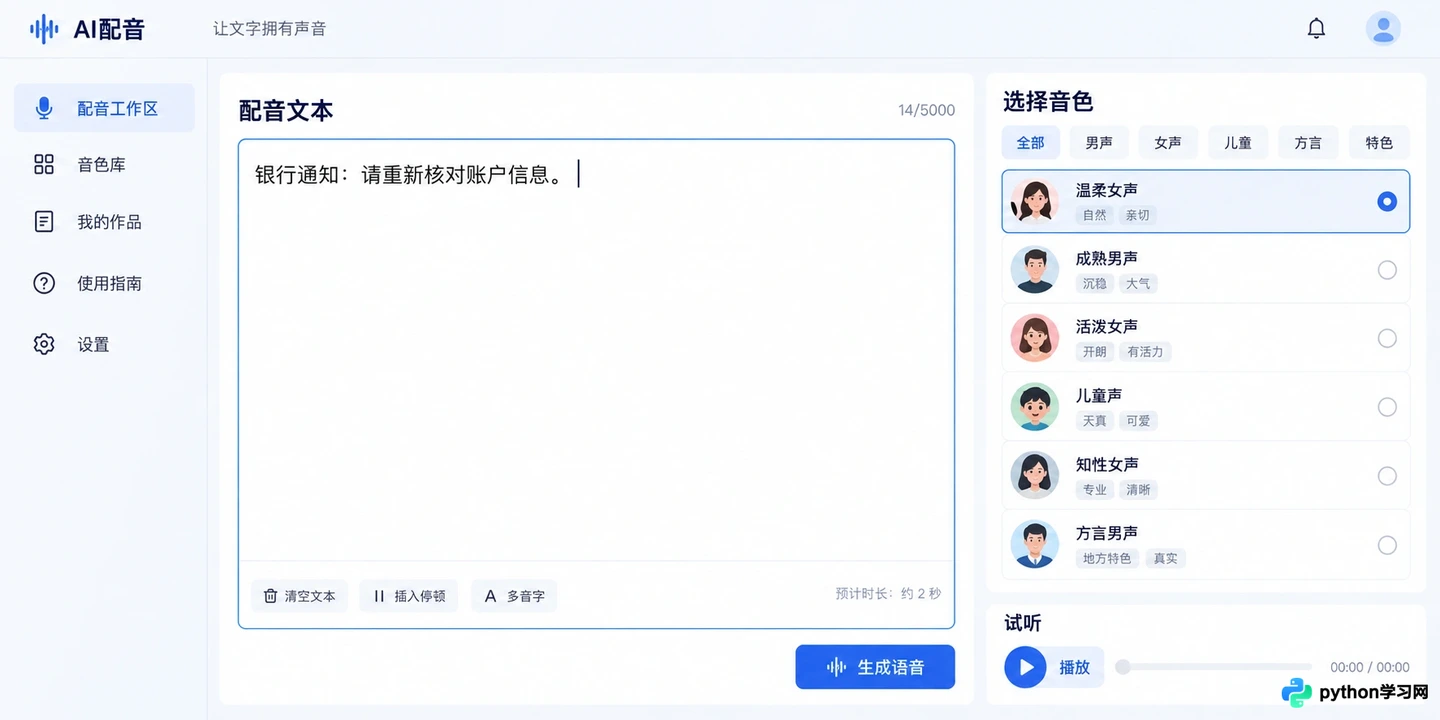
本文介绍在C#中利用微软SAPI实现语音合成的两种主要方法。第一种基于COM组件(SpeechLib),通过SpVoiceClass接口直接操作底层引擎,支持异步朗读、音量与语速调节;第二种基于.NET Framework 3.0+提供的System.Speech命名空间,使用SpeechSynthesizer类封装了语音功能,代码更简洁且无需额外添加COM引用。两者均能实现中英文混合朗读及音频控制,适用于桌面应用程序的TTS需求。
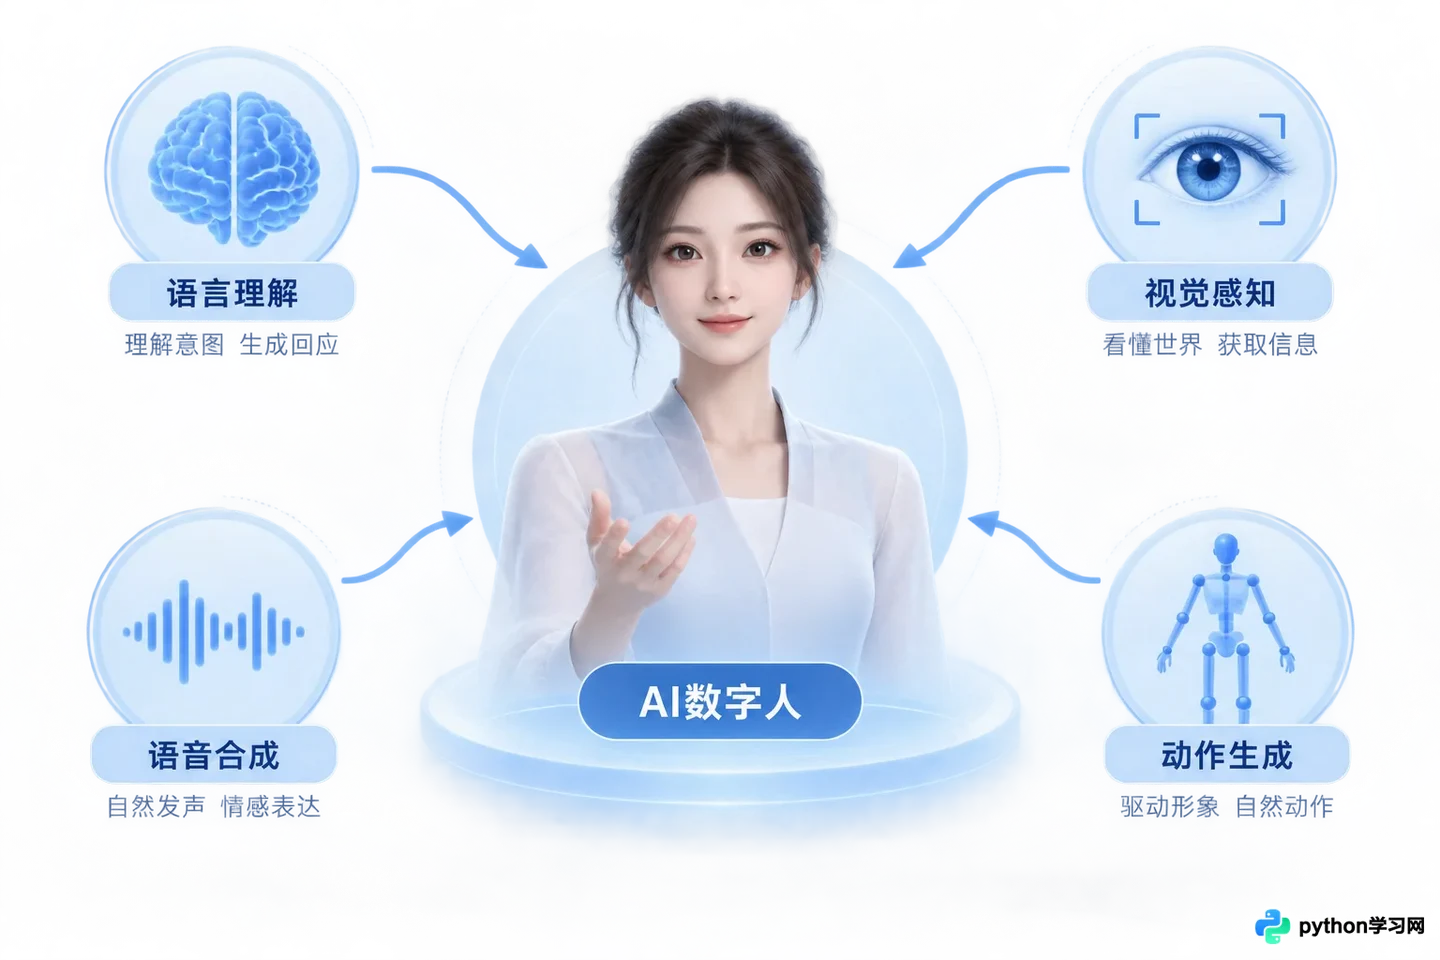
本文简要介绍支撑AI数字人运行的四大核心技术:自然语言处理(NLP)负责理解与生成对话,计算机视觉(CV)实现面部捕捉与表情驱动,语音合成(TTS)赋予声音情感,动作生成技术则让肢体动作自然流畅。通过解析这些技术模块,帮助读者建立对AI数字人底层原理的基础认知。
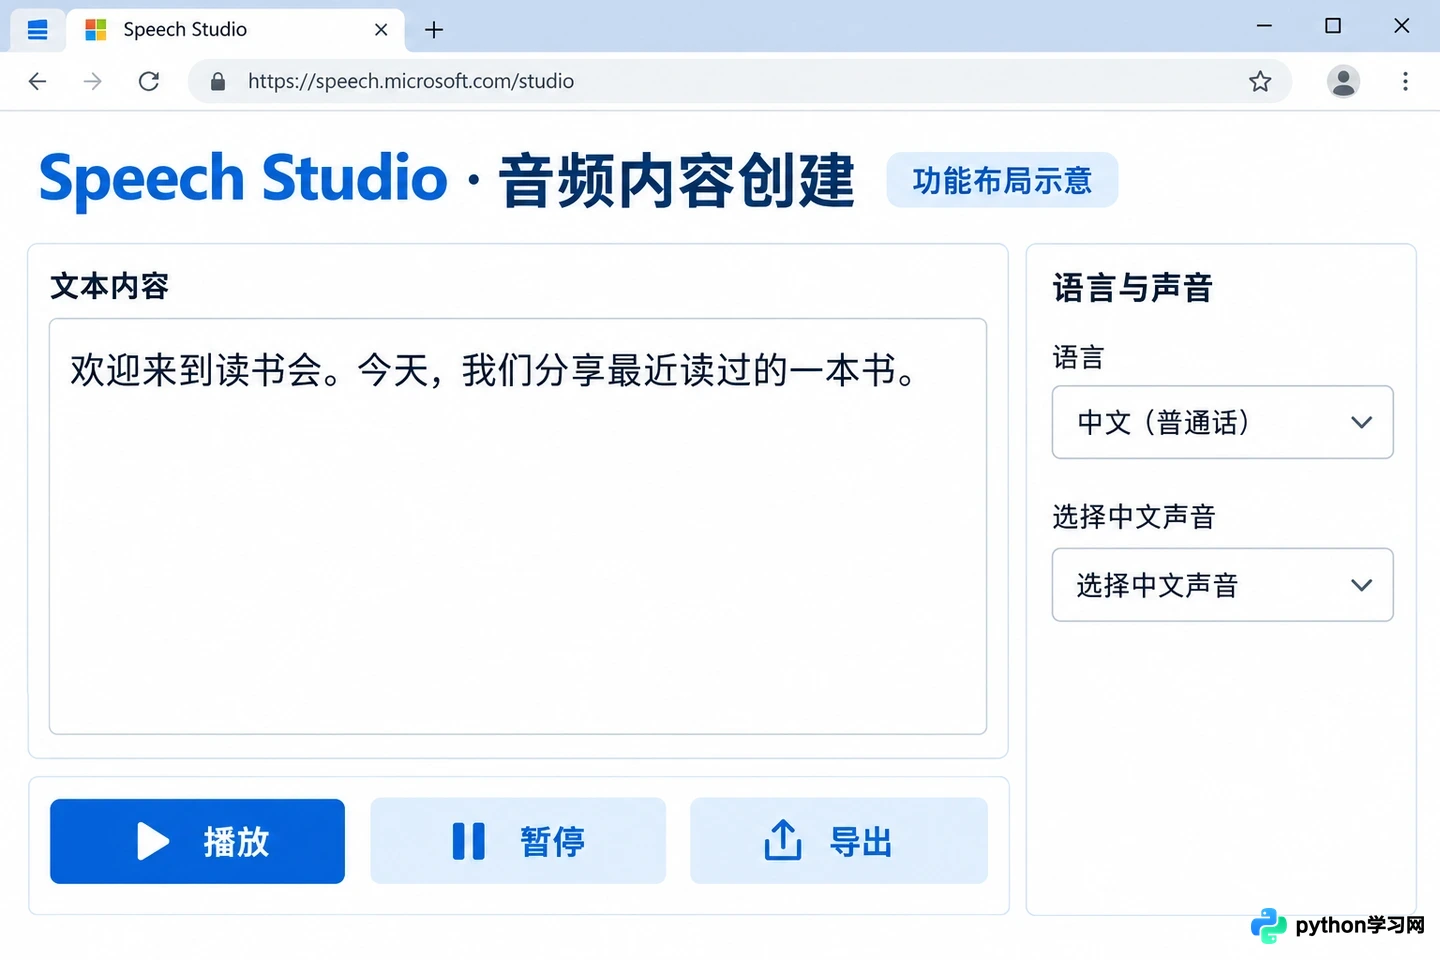
本文以微软Speech Studio音频内容创建工具为例,介绍如何通过优化文字编辑、选择合适声音以及精细调整语速和停顿,提升AI配音的自然度。重点讲解局部参数调整的逻辑,避免常见误区,帮助创作者获得更接近日常表达的旁白效果。
本文详细介绍了在C#项目中如何通过引用DotNetSpeech库调用Windows系统原生SAPI接口实现语音播报功能。重点讲解了SpVoice对象的关键方法,特别是针对网上较少提及的“彻底停止”功能提供了可靠解决方案(SVSFPurgeBeforeSpeak),从而构建包含朗读、暂停、恢复和停止的完整语音控制逻辑。
本文介绍如何利用PHP调用Google翻译的TTS(Text-to-Speech)API,将文本转换为MP3音频文件。通过简单的HTTP请求与文件流处理,开发者可以轻松获取指定语言的发音音频,无需额外上传音频资源。代码示例展示了从构建URL到保存本地文件的完整流程。
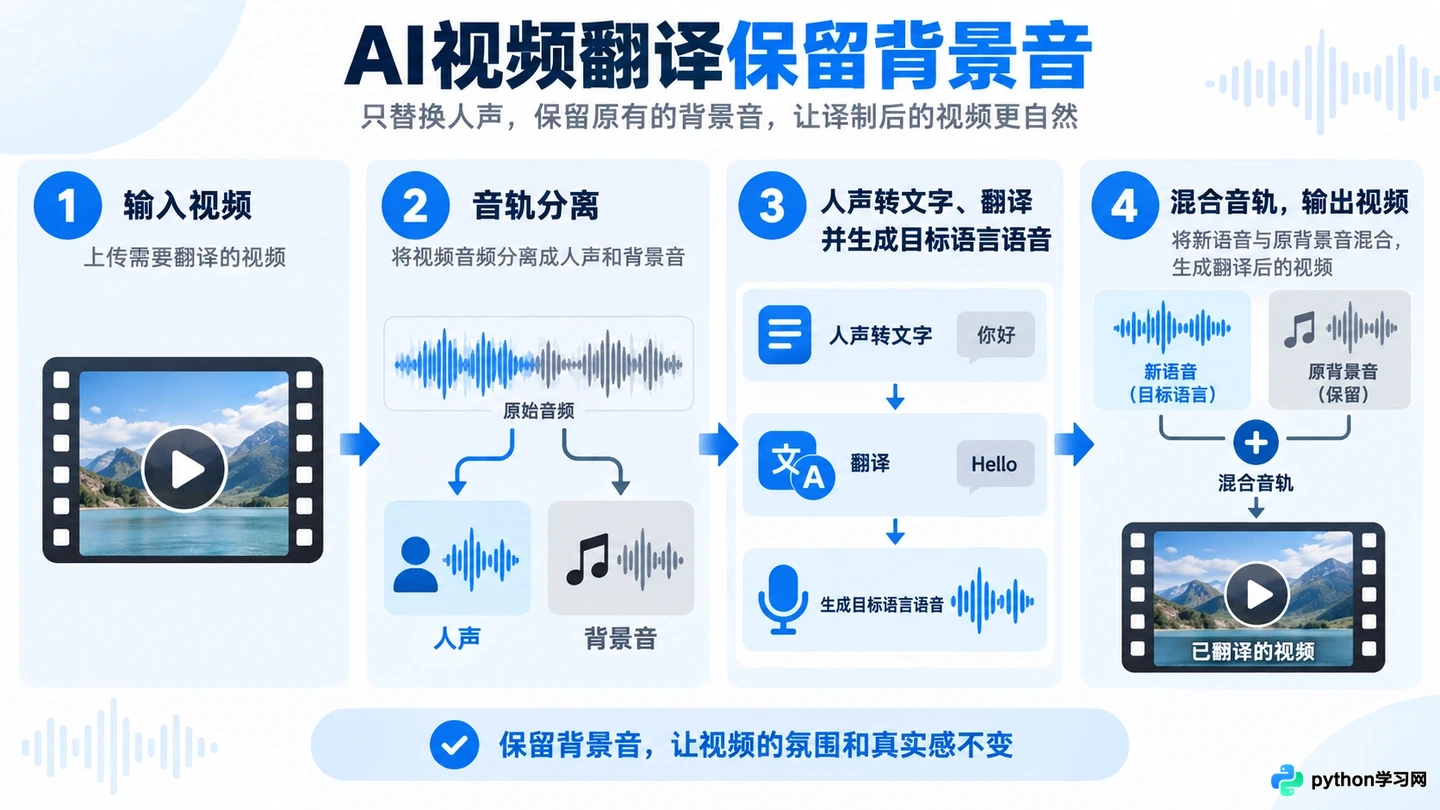
本教程演示如何利用AI工具实现视频多语言翻译,同时通过音轨分离与合成技术保留原始背景音效。重点讲解人声提取、文本翻译、语音合成及最终混音的完整工作流,确保译文自然且环境音不丢失。
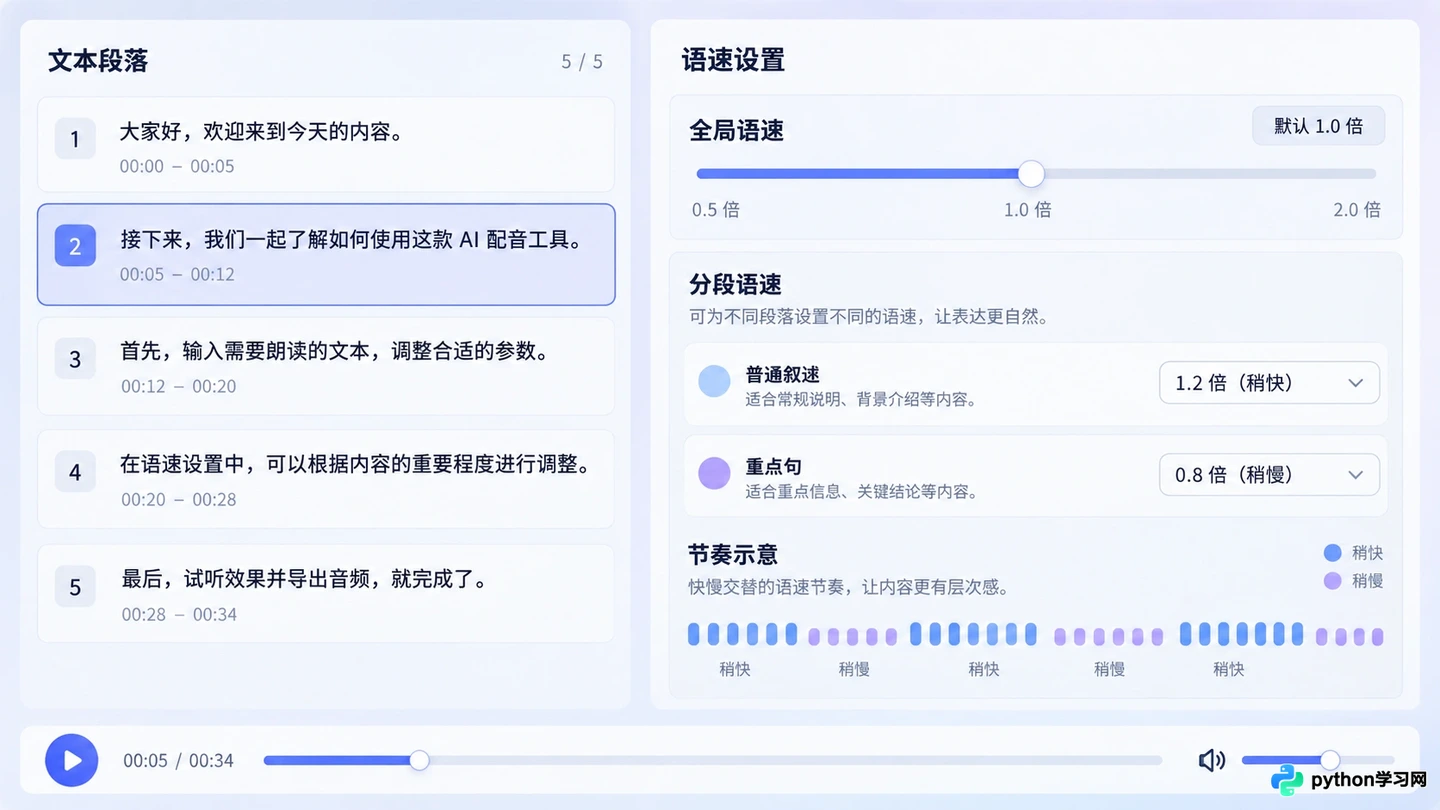
本文针对免费AI配音工具,深入解析语速、停顿、情感强度等核心参数的调节逻辑。通过具体场景演示如何打破机械感,使合成语音在短视频解说、有声书朗读等应用中更接近真人发音,提升听感质量。
针对AI数字人直播中常见的口型不同步和声音机械问题,本文从驱动模型选择、音频预处理、文本情感标注及渲染参数调整四个维度提供优化技巧,帮助提升直播间的真实感与用户转化率。
本文盘点支持免注册、开箱即用的轻量级在线AI配音服务,重点介绍TextToSpeech.im和TTSMP3等工具的操作流程与限制,满足紧急或隐私场景下的快速音频生成需求。