

Python使用re正则表达式分割中英文混合字符串
本文介绍如何利用Python的re模块正则表达式,精准分割包含中英文、数字及标点符号的混合字符串。通过定义特定的Unicode范围匹配中文与英文单词,实现按字或按词拆分,并提供完整代码示例与结果分析。
2026-10-11
6

本文介绍如何利用Python的re模块正则表达式,精准分割包含中英文、数字及标点符号的混合字符串。通过定义特定的Unicode范围匹配中文与英文单词,实现按字或按词拆分,并提供完整代码示例与结果分析。
本文系统梳理了Python中字符串与基础数据结构的常用操作。涵盖字符串翻转、回文判断、大小写转换、拆分合并,以及列表推导、元素频率统计、字典合并与唯一性检查等核心技巧。通过具体代码示例,帮助开发者快速掌握Python基础编程中的高频操作模式。
本文深入解析 Python 中 re.match() 函数的正则匹配机制,重点对比贪婪模式(.*)与懒惰模式(.*?)的行为差异。通过具体代码示例,展示如何控制捕获组提取内容,并探讨特殊字符在正则表达式中的实际作用与潜在报错原因。
在Python字符串查找操作中,index()遇到目标缺失时会直接抛出ValueError导致程序中断,而find()仅静默返回-1。两者参数与底层性能一致,核心差异在于异常处理机制。本文结合标准示例与条件判断逻辑,解析两者的本质区别,协助开发者依据业务容错需求精准选型。
在Python数据处理中,保留指定小数位数通常依赖内置函数与字符串格式化方法。本文对比format与round的核心差异,明确返回类型、进位规则与补零机制,并提供实际代码配置与精度异常排查指南,助力精准控制数值输出。
本文详细解析 Python 中 split() 函数的用法。通过指定分隔符 sep 和最大分割次数 maxsplit,可将字符串切分为列表。默认情况下,sep 为 None 时按空白字符分割并忽略空字符串;maxsplit 控制分割次数。文章包含基础示例、参数解析及手动实现逻辑,帮助理解字符串处理机制。
本文介绍Python中利用round函数保留两位小数的方法,并探讨基于字符串切片和正则表达式(re模块)的替代方案。通过具体代码示例,展示不同场景下的数值处理技巧,帮助开发者根据实际需求选择最合适的实现方式。
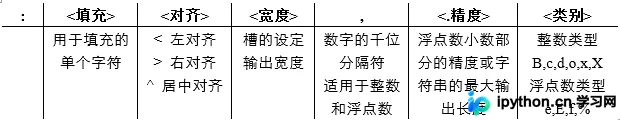
本文详细讲解Python中format()方法的字符串格式化功能。通过掌握槽位占位符的基本替换逻辑,以及宽度、对齐、填充、千位分隔符、精度和小数类型等核心参数的组合规则,可快速实现各类数据的高质量排版与标准化输出。
本文介绍如何在Python3环境中使用FuzzyWuzzy库进行字符串模糊匹配。通过安装fuzzywuzzy及python-Levenshtein依赖,利用fuzz模块计算字符串相似度(如ratio方法),并使用process模块从候选列表中提取最相关的字符串,适用于数据清洗和模糊搜索场景。
本文详解Python中join()函数的核心原理与使用场景。通过指定分隔符将字符串、列表、元组或字典序列合并为新字符串,并介绍os.path.join()在路径组合中的应用。包含具体代码示例与注意事项,帮助开发者高效处理字符串拼接任务。
讲解如何借助Python的theffuzz库解决名称拼写不一、格式混乱带来的字符串匹配难题。涵盖环境配置、fuzz模块四种核心相似度算法的适用场景,以及process模块在列表批量提取与自定义打分器中的应用,附完整可运行代码与性能优化建议。
本文介绍Python操作MySQL数据库的三个实用技巧:如何在commit前获取插入数据的自增主键ID,利用MySQL特性自动维护创建和更新时间字段,以及使用pymysql.escape_string处理含引号的字符串以避免报错。