

Python内置方法isdigit()用法详解与常见误区
本文详解Python内置方法isdigit()的核心用法,涵盖单字符验证与完整字符串检测的实际代码示例,剖析返回值判定逻辑,并对比易混淆的同类方法,助你在数据清洗与业务逻辑判断中避免类型错误。
2026-10-12
6

本文详解Python内置方法isdigit()的核心用法,涵盖单字符验证与完整字符串检测的实际代码示例,剖析返回值判定逻辑,并对比易混淆的同类方法,助你在数据清洗与业务逻辑判断中避免类型错误。
本文详解Python字符编码底层原理与实操方法。涵盖ASCII、UTF-8等主流格式特性,说明源文件编码声明机制,演示跨编码安全读取转换流程,并解决图形界面渲染乱码问题,助力开发者高效处理多语言文本数据。
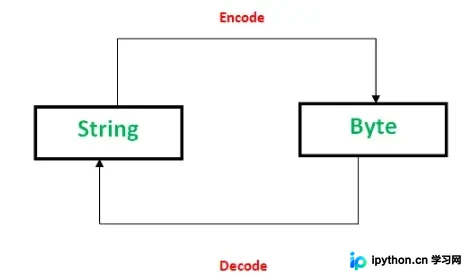
本文详解 Python 中字节对象与字符串的区别,重点讲解 encode() 和 decode() 方法的使用。通过 ASCII 编码示例,展示字符串如何转换为字节序列以及逆向解码过程,帮助开发者掌握数据存储与处理的底层机制。
本文详解Python中字符串的常用处理方法与运算符。重点介绍strip()、lstrip()和rstrip()三种去空格函数的用法差异,并逐一演示+、*、in、not in、is、is not、==及!=等运算符的具体行为与返回值,帮助开发者掌握字符串操作核心技巧。
针对Python中正则表达式如何精准提取和匹配中文汉字的问题,本文提供两种主流实现路径。通过调用内置re模块,分别采用Unicode标准编码范围与直写字面量区间的方式,配合findall函数过滤混合文本中的非中文字符。代码已适配Python 3环境,附带完整示例与参数解析,可直接复制用于爬虫清洗或数据校验场景。

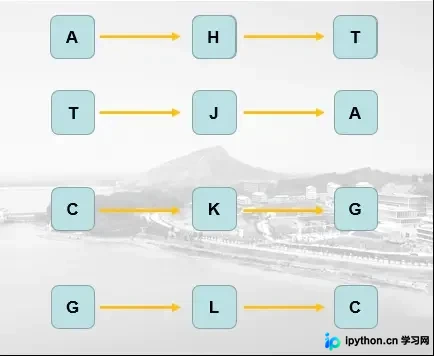
本文详细解析如何在Python中准确计算已知DNA模板的互补序列。针对初学者常见的replace()方法导致的数据覆盖问题,提供一种利用大小写特性与临时占位符的安全替换方案,并附完整可运行代码及结果验证,帮助快速掌握字符串处理技巧。
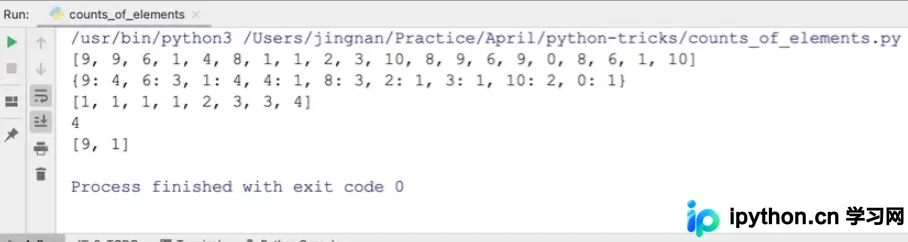
本文详解在 Python 中统计序列元素或文本单词出现频率的核心技巧,涵盖手动构建字典计数并提取最高频元素的传统方法,以及如何借助标准库 collections.Counter 快速完成统计、排序与分词处理。通过正则清洗与多场景代码示例,帮助开发者高效实现频次分析。
本文深入解析Python中format方法的多种用法,涵盖按顺序匹配、索引引用、关键字参数及混合使用规则。详细讲解数值精度控制、进制转换、字符串对齐与填充,以及利用*和**对列表、字典进行拆包的高级技巧,助您掌握高效字符串处理方案。
本文系统梳理Python基础语法的核心规则,涵盖缩进控制、引号与注释用法、标识符命名限制、print输出与字符串格式化、多行语句构建及常用调试方法。通过标准代码示例与参数说明,帮助开发者快速掌握Python编写逻辑,提升代码可读性并规避常见语法错误。
在使用Python进行文本处理时,经常需要定位特定字符串并在其上方插入新行。本文详细对比了三种实现方案:全量读取覆盖、FileInput原地过滤以及二进制流定位重写,并提供耗时测试数据供选择。针对大文件内存限制问题,重点介绍基于文件指针定位的高效写法。文末附带利用正则表达式提取复杂日志字段并按需生成的实战代码,帮助开发者根据实际场景选择最优解。
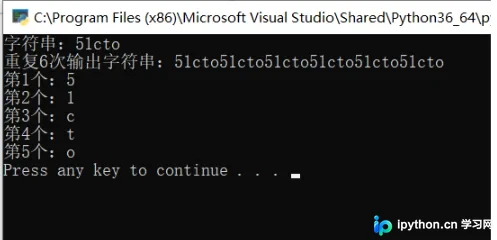
本文详细介绍Python中常用的字符串运算符,包括字符串拼接(+)、重复输出(*)、下标访问([])、切片截取([:])以及成员检测(in和not in)。通过具体代码示例和运行效果,帮助开发者掌握字符串处理的核心技巧,提升数据处理效率。
本文解析Python字符编码底层原理,对比str与unicode的数据结构差异,演示encode与decode的正确调用逻辑,提供codecs模块安全读写多语言文件的方案,并指出MBCS跨平台移植的致命缺陷,帮助开发者彻底规避乱码问题。