

Python 字符串 strip 方法去首尾空白字符详解
Python 提供了 strip() 内置方法用于高效清理字符串首尾多余字符。该方法默认移除空格、制表符与换行符,也可通过参数传入目标字符集进行定向清除。结合文件读取与数据预处理场景,掌握其调用逻辑与参数限制,可避免脏数据干扰后续解析流程。
2026-10-12
6

Python 提供了 strip() 内置方法用于高效清理字符串首尾多余字符。该方法默认移除空格、制表符与换行符,也可通过参数传入目标字符集进行定向清除。结合文件读取与数据预处理场景,掌握其调用逻辑与参数限制,可避免脏数据干扰后续解析流程。
本文详解Python中print函数的核心用法,涵盖基础输出、变量嵌入及多参数传递机制。通过对比f字符串与百分号占位符等格式规范,演示浮点数与整数的精度及宽度控制方法。结合end参数配置、转义字符替换与字符串拼接技巧,提供控制台连续输出的完整方案,附典型代码示例供开发调试参考。
Python 中的 re 模块提供了完整的正则表达式工具链,涵盖模式匹配、文本提取、条件替换及多行处理等核心场景。本文梳理从基础导入到高级断言、分组及编译优化的完整工作流,配合可运行的代码示例,帮助开发者高效解决复杂的字符串解析与数据清洗任务,提升代码健壮性与执行效率。
Python中频繁累积文本片段时,使用+=还是join()更高效?本文通过基准测试与底层原理分析表明:百万字符内两者差异微小,超量后+=因对象不可变性导致频繁内存复制而耗时指数级上升,join()凭借预计算总长一次性分配内存的优势显著提升性能。掌握此区别可有效避免循环拼接引发的性能瓶颈。
Python 3中所有字符串默认以Unicode编码,在实际开发中常需将其转换为原始字节序列进行网络传输或文件读写。本文系统讲解ASCII与非ASCII字符的编码差异,详细说明\xNN、\uNNNN等十六进制转义符的用法,并提供GBK与UTF-8互转及安全解码的标准代码示例,快速解决常见的乱码与类型报错问题。
针对Python脚本运行耗时较长的问题,本文通过实测数据梳理了9项核心优化方案。涵盖字符串与集合的数据结构选型、推导式替代传统循环、利用缓存装饰器消除重复计算、调整作用域以加快局部变量检索,以及延迟加载重型模块。合理应用这些底层机制可显著降低CPU开销并缩短启动时间。
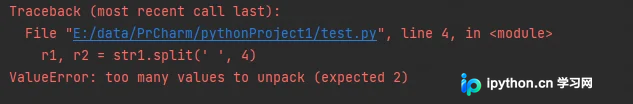
本文详解Python中split()函数的字符串分割用法。涵盖默认空白符处理、自定义分隔符类型限制、通过maxsplit参数精准控制切割次数,以及返回列表的索引访问与多变量解包技巧。结合实际代码示例与异常提示,帮助快速掌握文本解析核心操作。
在Python开发中,判断字符串是否包含列表内的特定子串是高频需求。本文围绕成员资格检查核心逻辑,提供基于any()函数的快速判定、walrus运算符的首次匹配捕获、列表推导式的批量提取以及忽略大小写的对比方案,附带可直接运行的代码片段与执行结果说明。
本文详细讲解 Python re 模块的核心用法,涵盖 re.search()、re.findall()、re.sub() 等常用函数的操作入口与参数配置。通过匹配数字、提取全量结果及文本替换的完整代码示例,说明如何正确编写正则模式与验证执行状态,并介绍 re.compile() 在高频调用场景下的性能优化方案。
本文详细演示如何利用Python内置的字符串方法结合os模块,自动统计TXT文本文件中的英文字母、数字、空格、中文字符及特殊符号数量。通过封装单行校验函数与文件遍历逻辑,提供完整可运行的代码方案,满足日常数据核对与批量处理需求。
本文详解Python使用re模块通过正则表达式提取字符串的方法。涵盖单点匹配与贪婪模式控制、多行匹配标志设置,以及基于命名分组的连续多字段提取。提供Web服务器Access日志解析完整代码,帮助快速定位并结构化截取目标文本。
本文详解如何利用 Python 内置 struct 模块进行结构化二进制数据的打包与解包。涵盖格式化字符串编写、字节序与对齐控制,以及 rb/wb 文件模式的操作细节。提供标准代码示例与常见报错排查方案,帮助开发者高效处理底层数据流,彻底规避文本模式导致的截断与跨平台换行符转换问题。