Python实现将文件内容按行或分隔符存入数组的方法
本文介绍在Python中将文件数据提取为数组的两种常用方法。通过读取文件内容,利用split函数以指定分隔符(如换行符或逗号)进行拆分,或使用splitlines方法直接按行分割,即可将文件内容高效转换为数组元素,适用于不同格式的数据处理场景。
2026-10-13
6

本文介绍在Python中将文件数据提取为数组的两种常用方法。通过读取文件内容,利用split函数以指定分隔符(如换行符或逗号)进行拆分,或使用splitlines方法直接按行分割,即可将文件内容高效转换为数组元素,适用于不同格式的数据处理场景。
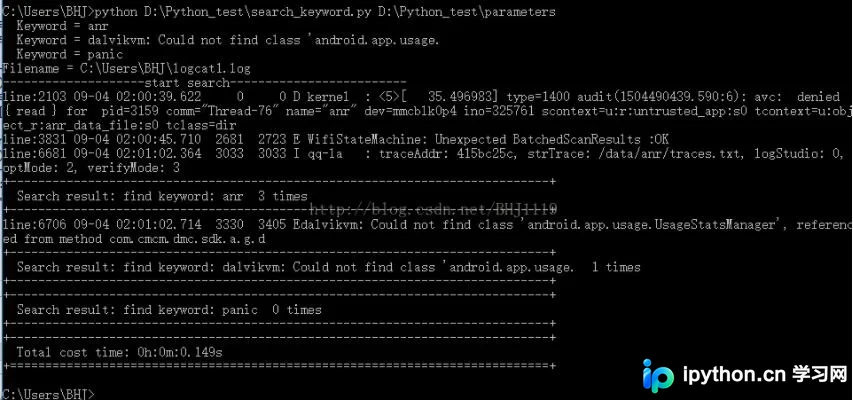
本文介绍如何利用Python脚本在压力测试产生的大量日志中快速定位关键信息。通过读取包含关键字和日志路径的配置文件,程序自动遍历指定文件进行正则匹配,并统计匹配次数与耗时。示例基于Windows 10及Python 2.7.14环境,提供了完整的参数解析、文件检查及时间格式化代码,适用于需要高效日志分析的运维场景。
本文介绍了一种使用Python实现的日志增量抓取方法。通过记录文件最后修改时间和读取位置,结合正则表达式对新增日志进行匹配提取。示例代码展示了如何初始化扫描器、判断文件变化并输出匹配结果,适用于需要高效处理持续更新日志文件的场景。
本文详细总结了Python中实现字符串逆序输出的六种常用方法,包括直接使用字符串切片、利用列表reverse函数、新建列表从后往前添加、借助collections模块的extendleft方法、递归实现以及基于Swap操作的对称交换。每种方法均提供具体代码示例与运行结果,帮助开发者根据场景选择最优方案。
本文介绍了使用Python和C++实现字符串逆序输出的具体代码。Python部分展示了利用列表reverse()函数结合join()方法,以及直接使用切片s[::-1]两种实现方式;C++部分则演示了通过循环从后往前遍历并直接输出字符的方法。内容涵盖核心逻辑与完整代码示例,供开发者参考学习。
本文提供基于Python 2.7的百度贴吧图片爬取完整代码。通过requests获取页面,利用BeautifulSoup解析img标签,结合正则表达式提取最大页码,实现自动遍历所有楼层并批量保存高清原图至本地指定目录。
本文详细介绍如何利用Python语言随机生成符合规范的手机号码,并结合2017年最新正则表达式进行有效性验证。文章提供了完整的代码实现、运行结果展示以及正则测试工具推荐,帮助开发者快速掌握手机号生成与校验的核心技巧。
本文介绍在Python中利用locale模块实现中文按拼音排序的具体方法。通过安装中文语言包并设置LC_COLLATE环境变量,结合strcoll函数与sort排序算法,可完成中文列表的有序排列。文中提供了完整的测试代码及输出示例,并推荐了在线排序工具供参考。
本文详细介绍在Python中去除文件扩展名的几种常用方法。通过os.path模块的splitext函数结合basename,可以精准提取文件名主体。此外,还展示了利用字符串split和rsplit方法进行路径解析的技巧,适用于不同场景下的文件名处理需求。
本文介绍在CentOS7.3.1611_x64系统Python 2.7.5环境下,如何高效批量替换多个源文件中的指定字符串。提供了两种方案:利用sed与grep组合命令快速处理,以及编写Python脚本实现跨平台(含Windows)的目录遍历替换。
本文详细解析Python中raw_input()与input()函数的差异。raw_input()始终返回字符串,需手动转换类型;input()尝试计算输入值,直接返回对应类型(如整数)。文章通过代码示例展示了如何转换为int、list或str,并指出input()处理非数值字符串时的报错机制及向下取整特性。
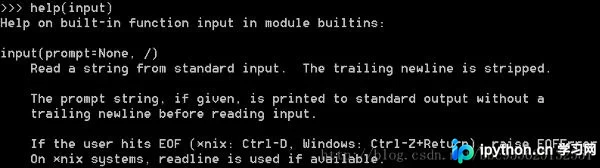
本文详细解析Python3中的input函数,说明其作为内建函数从标准输入读取字符串并忽略换行符的机制。重点对比Python2中input与raw_input的区别,指出Python3整合二者后统一将所有输入视为字符串处理的特性,并介绍类型转换方法。