

Python中DFA算法与普通算法在敏感词过滤上的性能对比分析
本文通过Python代码实测对比了DFA(确定有限状态自动机)算法与普通循环查找算法在敏感词过滤场景下的性能差异。实验结果显示,当敏感词数量较少(如100个)时,普通算法效率更高;而当敏感词库扩大至1000个时,DFA算法的优势显现。文章进一步从理论上推导了两种算法的时间复杂度,指出DFA算法的处理时间与敏感词数量基本无关,主要取决于文本长度和词长,从而明确了DFA算法在大规模敏感词库中的适用场景。
2026-10-13
6

本文通过Python代码实测对比了DFA(确定有限状态自动机)算法与普通循环查找算法在敏感词过滤场景下的性能差异。实验结果显示,当敏感词数量较少(如100个)时,普通算法效率更高;而当敏感词库扩大至1000个时,DFA算法的优势显现。文章进一步从理论上推导了两种算法的时间复杂度,指出DFA算法的处理时间与敏感词数量基本无关,主要取决于文本长度和词长,从而明确了DFA算法在大规模敏感词库中的适用场景。
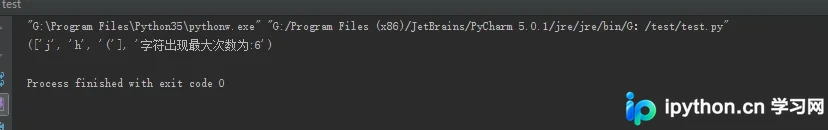
本文介绍在Python中统计字符串出现次数最多字符的两种实现方式。第一种方法通过遍历构建列表,能返回所有并列最高频的字符及次数,逻辑更严谨;第二种方法利用max函数配合count参数,代码极简但仅返回首个匹配字符。文中还附带了在线字数与字符统计工具的链接,供开发者快速参考。
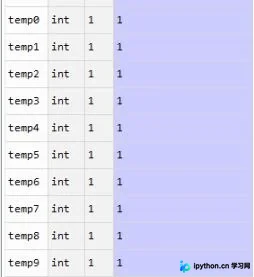
本文详解如何在Python中通过exec函数结合循环动态定义多个变量。利用字符串占位符与exec执行特性,可解决变量名数量不固定的场景。文章提供基础示例及多参数替换方法,帮助开发者掌握这一高级技巧,适用于需要灵活生成变量名的编程需求。
本文介绍在Python中使用格式化字符串输出百分号的方法。由于百分号是格式化操作的特殊字符,直接输出需使用两个连续的百分号%%进行转义,例如print('%s%%'%(5))可正确输出5%。
本文介绍在Python中创建新列表和新字典,并将原有元素及键值对全部转换为小写的方法。通过遍历原列表和字典,利用lower()函数生成包含小写元素的新数据结构,适用于需要统一字符串格式的场景。
本文介绍在 Python 中利用时间生成唯一标识字符串的方法。通过 datetime 模块获取精确到微秒的时间戳,可有效避免重复。为提升安全性,建议在时间字符串后追加随机字符组合。该方法适用于任务标识等场景,代码简洁且易于实现。
本文介绍Python中过滤字母、数字及特殊符号的多种实现方式,涵盖filter内置方法、正则表达式re模块及isnumeric等字符串处理技巧,适用于中文分词前的数据清洗场景。
本文详解Python实现字符串全排列的算法,重点解析如何处理含重复字符的情况及字典序输出。通过对比list的append与+运算区别,结合递归交换策略生成所有排列,并利用sorted函数高效实现字典序排序,最终提供完整的AC代码示例供参考。
本文解析Python2与Python3在字符串处理机制上的核心差异,重点阐述因str类型定义不同导致的乱码问题。通过对比两种版本的代码实现,提供统一的字节与字符串转换函数,帮助开发者在QGIS、arcpy等环境中避免编码错误,确保文本读写稳定性。
本文介绍在 Python 中输出所有大写字母、小写字母及数字的两种常用方法。第一种基于 ASCII 码值,利用 chr() 函数将整数范围转换为对应字符;第二种利用内置 string 模块,直接调用 digits、letters 等属性获取字符集。文章提供了完整的代码示例及输出结果,帮助开发者快速掌握相关技巧。
本文介绍了在 Python 中生成小写字母表的三种常用方法。第一种利用列表推导式结合 chr 函数生成字符列表;第二种通过 join 方法将列表拼接为完整字符串;第三种借助 string 模块获取标准字母表,并进一步演示如何将其初始化为值全为 0 的字典。这些技巧涵盖了基础数据处理与标准库应用的常见场景。
本文介绍如何利用Python将浏览器开发者工具中复制的原始Headers字符串转换为标准的字典格式,并进一步序列化为JSON字符串。通过字符串分割与字典生成式技术,自动处理键值对提取及协议头修正,适用于网络爬虫调试与接口开发场景。