Flask 中实现多对多关系查询:以文章与分类为例
本文详细解析在 Flask 框架下如何处理文章与分类的多对多关系。通过定义中间关联表 post_class,利用 SQLAlchemy 的 secondary 参数建立双向引用,并演示如何通过分类对象直接获取其下的所有文章列表。
2026-10-13
3


本文详细解析在 Flask 框架下如何处理文章与分类的多对多关系。通过定义中间关联表 post_class,利用 SQLAlchemy 的 secondary 参数建立双向引用,并演示如何通过分类对象直接获取其下的所有文章列表。
本文详解如何在Flask应用中集成MySQL数据库。涵盖flask-SQLAlchemy安装与配置、User与Role模型定义、通过flask-script执行数据库操作、解决Python 3.x下的MySQL驱动兼容性问题,以及使用Flask-Migrate进行数据库版本管理。最后演示了将登录功能与数据库关联的完整流程,帮助开发者构建稳健的后端数据层。
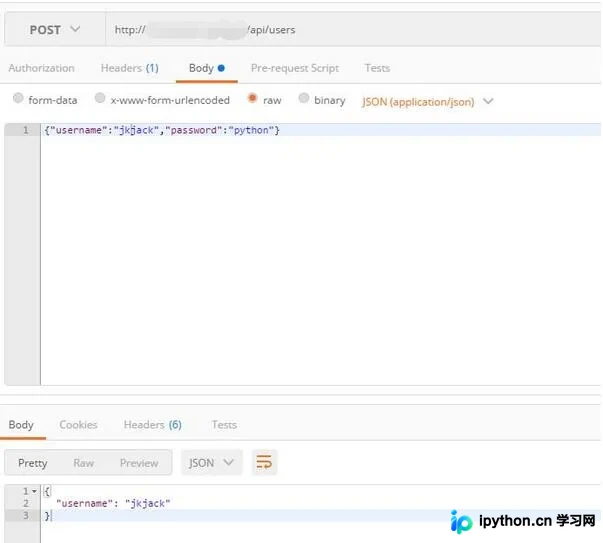
本文详细介绍如何使用Python Flask框架结合Basic Auth机制构建简易的注册登录系统。通过Flask-SQLAlchemy进行数据库建模,利用passlib加密密码,并生成安全Token实现无状态身份验证。文章涵盖初始化配置、用户模型定义、注册与登录接口实现及Token验证逻辑,提供完整代码示例与效果演示。
本文介绍如何在 Flask-SQLAlchemy 中通过重写 get_bind 和 create_session 方法实现自定义读写分离。核心思路是根据 self._flushing 状态区分读写操作,分别路由至主库和从库。通过自定义 RoutingSession 和 RoutingSQLAlchemy 类,开发者可灵活控制数据库连接策略,但需注意自动选择的局限性。
本文详细介绍如何在Django项目中引入SQLAlchemy构建数据库连接池,以解决高负载下频繁创建销毁连接的性能瓶颈。文章提供了两种修改Django源码的方法,重点解析了处理kwargs中字典类型导致的unhashable错误的关键代码修改,并附带了适用于Django 1.7与Python 2.7环境的配置示例。
本文详解如何利用 Python 的 pandas 结合 sqlalchemy 高效读取 MySQL 数据。通过标准连接引擎与参数化查询安全获取数据,自动转换为 DataFrame 结构。涵盖环境安装、连接串配置、读写逻辑及异常处理,助力快速搭建数据分析管道。
在 Python 的 SQLAlchemy ORM 中,有时需要在运行时根据业务逻辑动态调整模型对应的数据库表名。本文详细演示了两种核心方案:通过直接覆写 __table__.name 属性实现快速切换,以及基于抽象基类配合 type() 函数构建独立模型对象。内容包含完整代码示例与适用场景对比,帮助开发者安全灵活地管理数据库映射关系。
本文详解Python SQLAlchemy的安装配置,并通过实例展示SQL工具包的表创建及ORM的类映射与数据操作,适用于初学者快速掌握数据库集成方法。
详解如何使用Python的SQLAlchemy库高效连接与管理MySQL数据库。涵盖环境配置、ORM模型定义、基础增删改查、事务控制及复杂查询等核心流程,提供标准化代码示例,帮助开发者快速掌握关系型数据的规范化操作。
在 Python 开发中,经常需要根据外部输入灵活拼凑数据库检索条件。本文介绍如何通过 SQLAlchemy 框架构建可伸缩的动态查询,涵盖单条件链式过滤、多条件逻辑组合以及原始 SQL 注入方案,提供可直接复用的代码模板与安全规范。
在 Python 的 SQLAlchemy 框架中,使用负号(如 -Model.field)进行降序排序可能导致严重的性能问题。本文深入分析这一常见陷阱,对比使用负号与调用 .desc() 方法的执行效率,并展示如何通过正确的排序方式提升查询速度。此外,文章还提供了一个利用随机数与最大 ID 结合的高效随机数据抽取方案,帮助开发者避免全表扫描,实现高性能的数据处理。
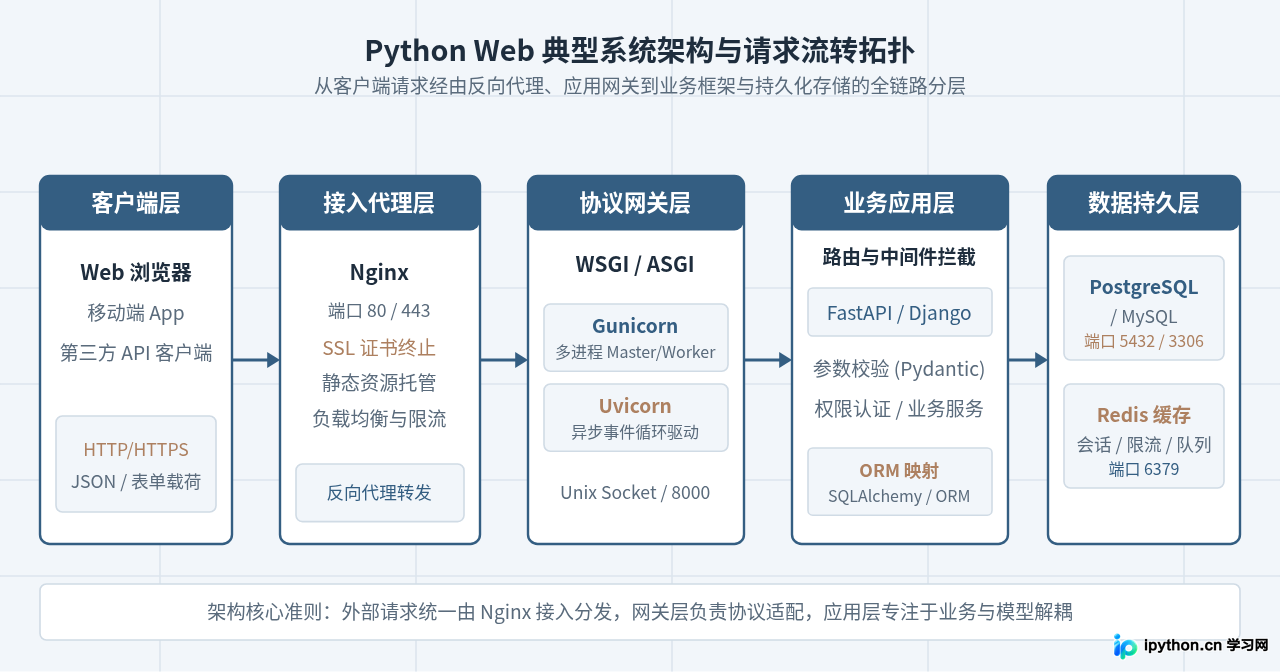
系统梳理Python Web开发方向必须掌握的核心技术栈体系,涵盖语言进阶特性、Web网关与通信协议、主流框架选型、数据库与ORM持久化、异步队列处理以及生产环境容器化部署。