SQL Server中获取去重记录的正确方法:Distinct与Group By详解
在SQL Server中,distinct关键字若作用于多列则针对整体组合去重。若需按某字段去重并保留关联的其他字段值(如ID),单独使用distinct无法实现。推荐通过group by配合聚合函数或窗口函数解决此类复杂去重需求,同时注意语法执行顺序以避免错误。
2026-10-15
3


在SQL Server中,distinct关键字若作用于多列则针对整体组合去重。若需按某字段去重并保留关联的其他字段值(如ID),单独使用distinct无法实现。推荐通过group by配合聚合函数或窗口函数解决此类复杂去重需求,同时注意语法执行顺序以避免错误。
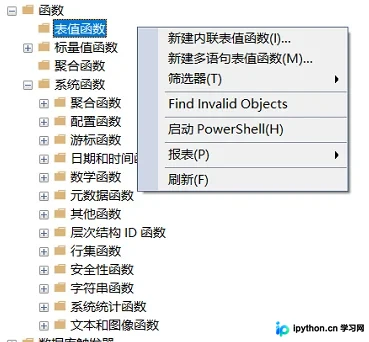
本文详细介绍如何在SQL Server中创建和使用用户定义函数(UDF)。涵盖基本语法结构,分类解析标量值函数、内联表值函数及多语句表值函数的创建方法与实战示例,并深入探讨确定性与非确定性函数的区别及其对索引的影响。
本文详解SQL Server中T-SQL批处理的执行逻辑,重点解析GO语句作为批处理分隔符的特性、非T-SQL命令的本质,以及语法错误与运行时错误的处理差异。通过实际案例说明如何在脚本创建数据库及表时利用GO解决依赖冲突,确保SQL操作按预期顺序独立执行。
本文介绍SQL Server中T-SQL标识符的命名规范,包括常规标识符与带分隔符标识符的规则。同时提供两种在表中无排序生成序号的方法:使用ROW_NUMBER()配合SELECT 0,以及利用IDENTITY函数创建临时表并提取序号。
本文详解SQL Server中的CROSS APPLY与OUTER APPLY操作符。CROSS APPLY仅返回右表有匹配数据的行,类似INNER JOIN;OUTER APPLY则保留左表所有数据,右表无匹配时补NULL,类似LEFT JOIN。通过具体示例展示其在取每组前N名记录及应用表值函数时的实际用法。
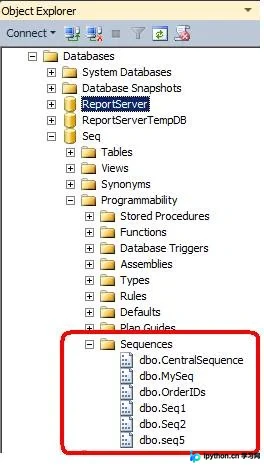
本文介绍 SQL Server 中 SEQUENCE 对象的用法。序列可独立于表生成连续数值,支持循环、缓存和范围获取。通过 CREATE SEQUENCE 定义规则,利用 NEXT VALUE FOR 取值插入数据或排序,并结合 ALTER/DROP 语句进行管理,适用于多表共享编号或需预分配ID的场景。
本文详细介绍如何使用Python的pymssql库连接SQL Server数据库。内容涵盖库的安装方式、数据库连接的创建与关闭、利用cursor对象执行查询语句(包括fetchone、fetchmany、fetchall及迭代器用法),以及通过execute和executemany实现单条或多条数据插入,并强调commit提交的重要性。
在SQL Server中,处理字段NULL值常遇到类型转换错误。本文介绍两种核心方案:使用CASE WHEN语句进行逻辑判断与显式转换,或利用COALESCE函数自动返回第一个非空表达式。掌握这两种方法可有效解决数据导出或展示时的NULL显示问题,确保结果集的格式统一。
本文介绍如何在Python中通过pymssql库连接并操作SQL Server数据库。包含环境准备、模块安装方法,以及建立连接、执行SELECT查询(含字符处理)、INSERT插入、UPDATE更新、DELETE删除和CREATE TABLE建表等关键代码示例。同时解决了TCP/IP端口未开启导致连接失败及中文编码乱码等常见问题。
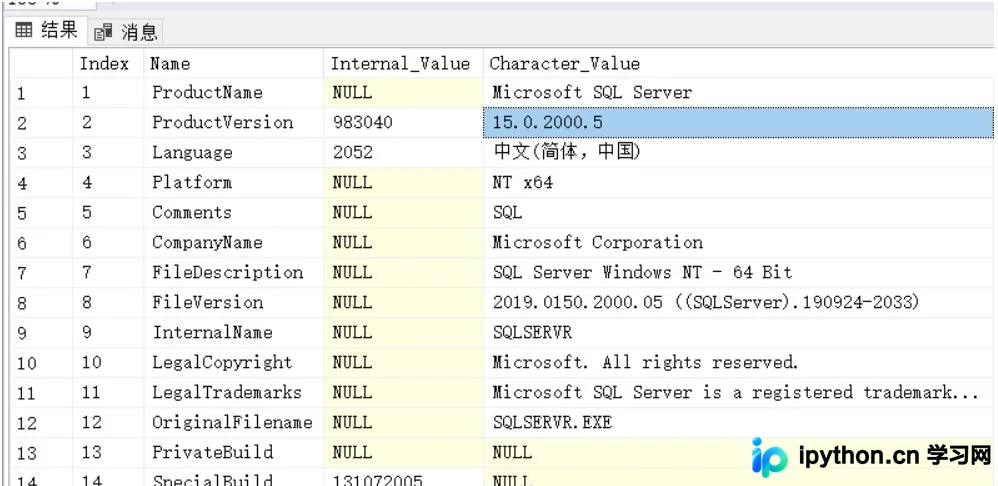
本文介绍在 SQL Server (以 2012 为例) 中清理数据库日志的标准流程。核心方法是将恢复模式切换为简单 (Simple),执行 DBCC SHRINKFILE 释放空间,最后还原为完全 (Full) 恢复模式以保证业务安全。文中包含完整的查询与清理 SQL 语句,适用于日常数据库运维。
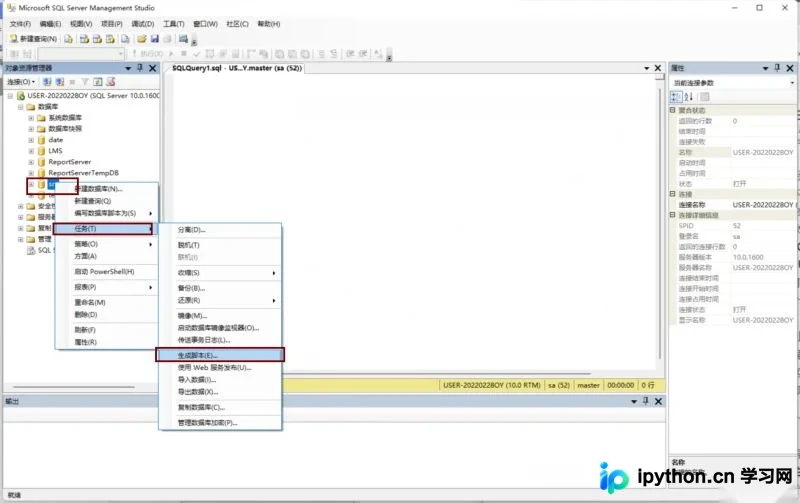
本文详细介绍如何在 SQL Server Management Studio (SSMS) 中生成数据库及数据表的 SQL 脚本,并演示在查询分析器中执行脚本的完整流程。通过“生成脚本”向导,用户可选择目标对象及输出方式,利用查询分析器打开 .sql 文件并按 F5 执行,即可快速完成结构或数据的迁移。
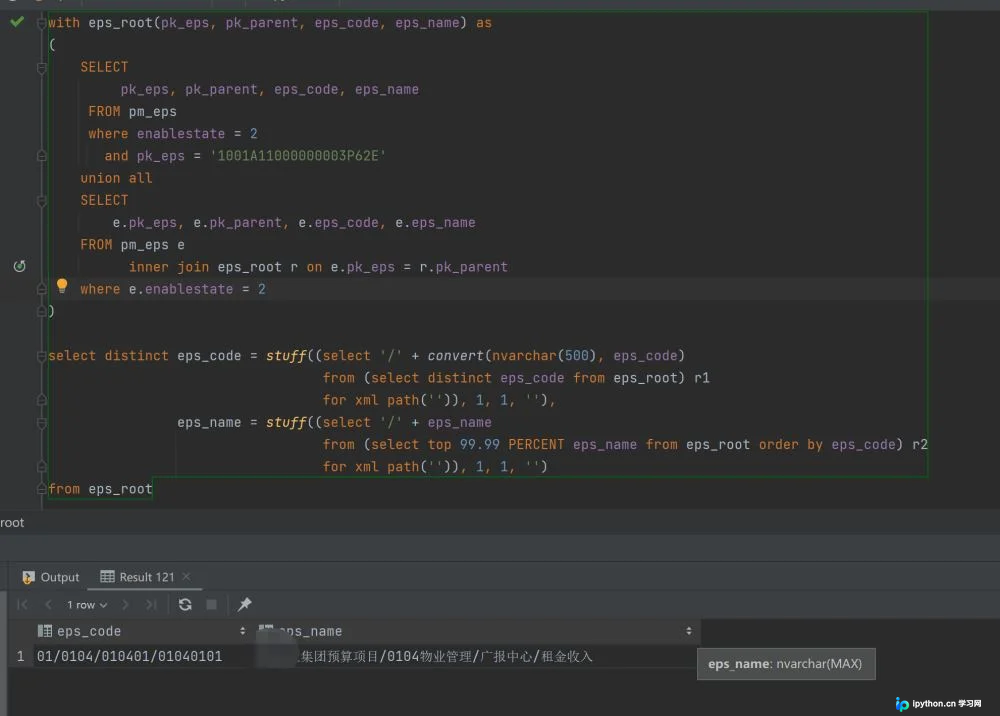
本文介绍如何在 SQL Server 中使用公用表表达式(CTE)进行递归查询,以获取树形结构中某节点的所有上级节点,并利用 STUFF 函数结合 FOR XML PATH 将这些多行数据合并为一行字符串,同时解决中文乱序问题。