
跨机器将SQL Server数据同步至Access数据库
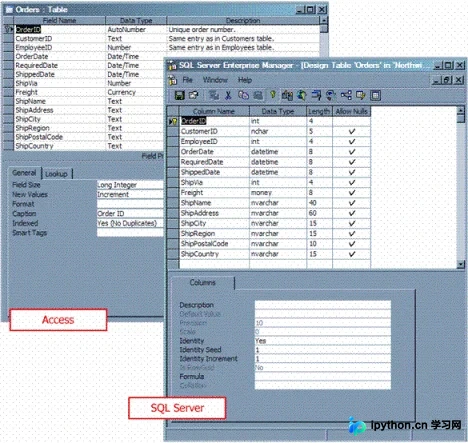
当SQL Server与Access文件位于不同物理机器时,OpenRowset无法直接使用。本文通过ADO技术实现跨机器的数据同步。核心思路是建立两个Recordset对象,分别连接源库和目标库。程序遍历SQL Server记录集,通过字段循环赋值的方式,逐行将数据添加到Access数据库中,有效解决异构、异地数据库间的数据迁移问题。
2026-10-13
5


当SQL Server与Access文件位于不同物理机器时,OpenRowset无法直接使用。本文通过ADO技术实现跨机器的数据同步。核心思路是建立两个Recordset对象,分别连接源库和目标库。程序遍历SQL Server记录集,通过字段循环赋值的方式,逐行将数据添加到Access数据库中,有效解决异构、异地数据库间的数据迁移问题。
本文详细介绍SQL Server中利用GROUP BY子句进行数据汇总的五种实战技巧。涵盖单列与多列分组、结合WHERE预处理过滤、处理NULL值特性、在分组中使用表达式,以及通过HAVING子句对聚合结果进行二次过滤。配合AdventureWorks示例代码,帮助开发者高效完成复杂报表统计需求。
介绍了SQL Server中两种备份数据库存储过程的方法:一是通过SQL Server Management Studio(SSMS)的图形界面任务生成功能,逐步导出存储过程的脚本;二是使用T-SQL编写自定义存储过程,利用动态SQL结合时间戳生成带日期命名的.BAK文件。前者适合手动或脚本化备份流程管理,后者便于实现自动化定时备份策略。
SQL Server Express 默认禁用网络访问。本文介绍如何通过 SQL 配置管理器启用 TCP/IP 协议,将动态端口设为 0、指定端口设为 1433,并重启服务以开启远程连接,适用于一般系统开发需求。
本文介绍 SQL Server 中排查 CPU 占用过高和 SQL 阻塞问题的常用方法与工具。通过查询系统动态视图定位高消耗语句,并使用 sp_who2、sp_lock 及 DBCC INPUTBUFFER 分析会话状态与锁详情,帮助快速诊断并解决数据库性能异常。
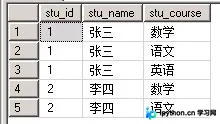
本文介绍在 SQL Server 中将某列的多行数据聚合为单行字符串的方法。通过 GROUP BY 结合 FOR XML PATH('') 生成带分隔符的 XML 序列,再利用 STUFF() 去除首字符分隔符,实现高效的数据行合并。
本文介绍 SQL Server 中局部 (#) 和全局 (##) 临时表的创建、查询及删除方法。对比 SELECT INTO 与 CREATE TABLE + INSERT INTO 的性能差异,提供完整的语法示例与存储过程中的嵌套应用注意事项。
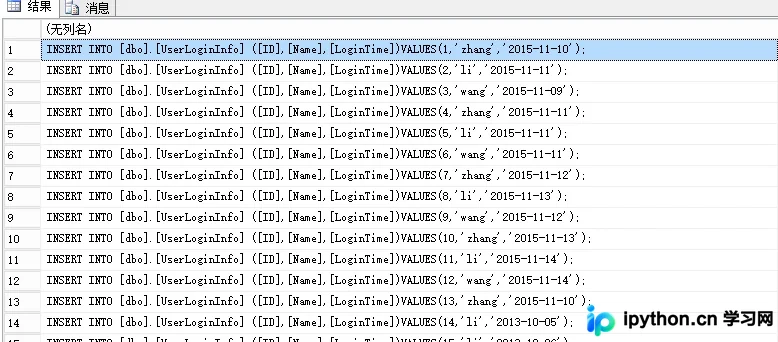
本文介绍如何通过在SQL Server中创建自定义存储过程,将数据库表数据批量转换为高效的INSERT语句。相比单行插入模式,本方案支持多行UNION ALL格式,显著提升大型数据集的脚本性能与加载速度,并自动处理NULL值及特殊字符转义。
通过结合 CHARINDEX 函数与 CASE WHEN 语句,在 SQL Server 中构建单条查询逻辑,解决多参数模糊搜索问题。该方法避免了程序端拼接字符串或生成动态SQL带来的注入风险与逻辑冗余。同时涵盖数据透视(交叉表)及按范围分组统计等常见高级用法。
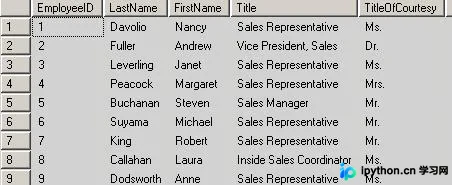
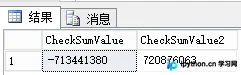
解决 SQL Server 中模拟数据生成的随机数需求,总结 RAND、CHECKSUM 和 NEWID 特性。通过结合 ABS(CHECKSUM(NEWID())) 技巧生成非负随机整数,并进一步封装为函数,利用取模运算实现任意数值区间(最小值 @intMin 到 @intMax)的随机数及日期范围抽取,提供完整的 T-SQL 代码与视图定义方案。
在SQL Server中,默认的事务机制可能因运行时错误导致部分语句提交。本文介绍了通过set xact_abort on、逐行检查@@error以及采用try...catch机制这三种方法,编写安全可靠的数据库事务代码,避免数据不一致问题。
本文演示了如何使用Python将Excel数据高效导入SQL Server数据库。通过结合xlrd读取Excel文件与pymssql建立数据库连接,实现了批量插入操作。示例中处理一万多条数据耗时仅1秒左右,代码逻辑清晰,适合需要快速迁移数据的场景参考。