

Oracle 数据库表空间查询:大小、剩余与使用率 SQL 详解
本文整理了 Oracle 数据库中用于监控表空间状态的实用 SQL 语句。涵盖如何查询表空间的名称及总大小、物理文件路径、剩余空间、已用空间以及详细的百分比使用率,同时提供回滚段、控制文件及日志文件的查询方法,助力数据库管理员快速掌握存储资源使用情况。
2026-10-14
7

本文整理了 Oracle 数据库中用于监控表空间状态的实用 SQL 语句。涵盖如何查询表空间的名称及总大小、物理文件路径、剩余空间、已用空间以及详细的百分比使用率,同时提供回滚段、控制文件及日志文件的查询方法,助力数据库管理员快速掌握存储资源使用情况。
本文通过真实数据对比 SQL Server 中五种常见分页查询方案的执行效率。针对靠后页码,推荐使用 ROW_NUMBER() OVER ()函数生成的方案5,在 2008R2 环境下表现最佳;对于较前页码,方案3、4、5均有良好表现。文末附带基于第4种思路的通用分页存储过程实现。
针对数百万条数据的数据库分页需求,分享一个基于ROW_NUMBER()函数的高效SQL Server分页存储过程。该方案通过动态SQL构建查询,支持自定义表名、字段、排序及过滤条件,并利用OUTPUT参数返回总记录数,显著优于传统OFFSET FETCH或子查询方式,适用于高性能Web应用后端开发。
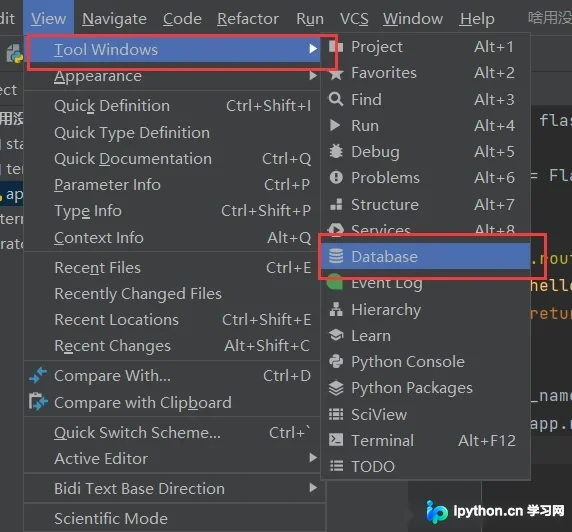
本文详细介绍如何在 PyCharm 中通过内置 Database 工具窗口连接 SQLite 数据库。内容涵盖驱动安装、数据库创建、连接测试及基础代码示例,帮助开发者快速配置本地 SQLite 环境并进行数据操作。
详解MySQL、Oracle和SQL Server三大主流数据库的分页查询语法。MySQL使用LIMIT关键字最为简便;Oracle依赖ROWNUM伪列,需通过嵌套子查询实现区间过滤;SQL Server提供多种方案如TOP结合NOT IN、ID比较或游标存储过程。文章对比了各方案的性能差异与适用场景,帮助开发者选择最高效的分页策略。
在SQL Server数据库中快速查找包含特定字符串的所有表和字段。本文提供基于动态SQL和游标的完整T-SQL脚本,自动遍历用户表及字符串类型列,定位数据位置并统计匹配行数,适用于数据库迁移、审计或故障排查场景。
本文详细介绍如何使用Python的tkinter库构建图形界面,结合pymysql连接MySQL数据库,实现学生信息的增删改查功能。文章包含完整的登录界面、数据查询界面代码示例,并演示如何利用PyInstaller将Python脚本打包为独立可执行文件,适合Python初学者进行实战练习。
本文详解 SQL Server 存储过程中的三大核心流程控制语句:条件判断 IF...ELSE、多重选择 CASE...WHEN 以及循环控制 WHILE。通过计算求和、变量赋值等真实代码示例,展示 declare、set 及 begin...end 块的标准写法,帮助开发者构建结构清晰、逻辑严密的数据库脚本。
在 MySQL 中使用 IN 子句查询时,默认会按主键或索引进行排序,无法保留输入参数的顺序。要强制结果按照 IN 列表中的特定顺序(如 '3,1,5')排列,推荐使用 ORDER BY FIND_IN_SET() 函数或 SUBSTRING_INDEX() 技巧。这两种方法无需额外表结构支持,直接应用于查询语句即可实现精准的自定义排序。
在将 .mdf 数据库文件附加到 SQL Server 时,常因权限不足触发“操作系统错误 5:5(拒绝访问)”及错误代码 5120。核心解决思路是确保运行 SQL Server 的服务账户对目标文件夹拥有完全控制权。本文提供修改文件夹权限的具体操作步骤,助您快速恢复数据库挂载。
本文详细解析SQL中UNION与UNION ALL操作符的核心区别。UNION用于合并结果集并自动去除重复行,而UNION ALL则保留所有数据包括重复值。文章通过Employees_China与Employees_USA表的对比示例,清晰展示两种语法在实际应用中的不同表现及注意事项。
在MySQL中尝试使用子查询从目标表中读取数据并更新该表时,会触发ERROR 1093。这是因为MySQL限制直接在同一语句中修改和选择同一张表。解决方案是将原始查询封装在多层子查询中,强制MySQL创建临时表从而避免冲突,或者通过JOIN重构语句以提升性能。