

Python连接数据库时SQL语句中%s,%d,%f及百分号转义详解
本文详解Python连接MySQL和PostgreSQL数据库时,SQL语句中%s、%d、%f参数的使用规范。重点解析在LIKE查询中处理普通百分号时的转义技巧,通过%%替代%防止格式化错误,确保数据查询准确无误,适用于增删查改操作中的字符串格式化场景。
2026-10-14
7

本文详解Python连接MySQL和PostgreSQL数据库时,SQL语句中%s、%d、%f参数的使用规范。重点解析在LIKE查询中处理普通百分号时的转义技巧,通过%%替代%防止格式化错误,确保数据查询准确无误,适用于增删查改操作中的字符串格式化场景。
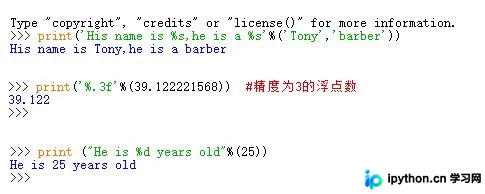
本文介绍了如何使用Python的pymysql库连接MySQL数据库,并通过pandas库将查询结果转换为DataFrame对象。文章提供了完整的代码示例,展示了从建立连接、执行SQL查询到关闭连接的完整流程,以及如何遍历和访问DataFrame中的元素。
本文详解Python中MySQL的IN参数化两种常见写法,指出字符串拼接的风险与.format()方法的便捷性。同时针对读取本地配置文件时常见的类型错误及连接失败问题,提供排查思路与解决方案,帮助开发者避免SQL注入并稳定连接数据库。
本文详解如何在pandas中实现类似SQL的WHERE IN查询。通过演示isin()方法处理列表筛选,对比直接使用时in导致的ValueError错误,并展示多条件组合筛选的正确括号用法,帮助开发者高效进行数据过滤操作。
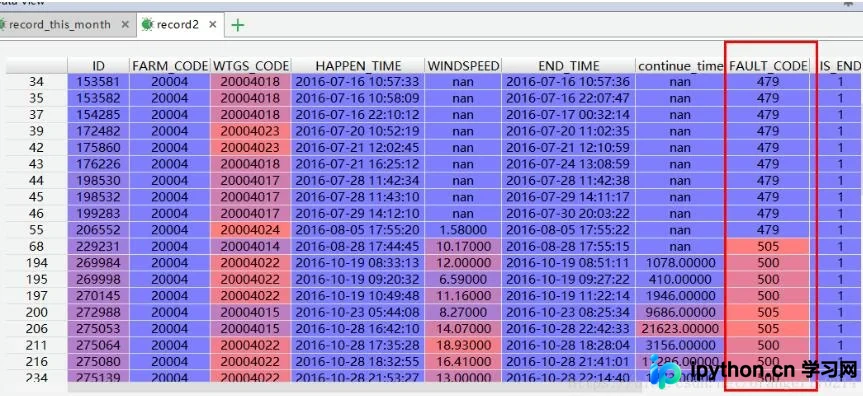
本文详解SQL中三种核心连接方式:LEFT JOIN保留左表全记录,RIGHT JOIN保留右表全记录,INNER JOIN仅返回两表匹配记录。通过设备表与软件表的示例及对比结果,清晰展示各连接类型的数据包含逻辑与适用场景。
SQLite默认对字符串比较大小写敏感,这常导致预期外的查询失败。本文介绍三种解决方法:使用LOWER或UPPER函数、在查询时指定COLLATE NOCASE,以及在建表时设置字段排序规则。分析指出COLLATE方案性能最佳,推荐优先采用,避免使用函数导致索引失效和性能损耗。
本文介绍了在Go语言中使用ODBC驱动连接和查询Microsoft Access数据库的方法。主要涉及使用第三方库进行数据库连接、执行SQL查询以及结果扫描,适用于需要跨平台或特定Windows环境下读写MDB文件的Go应用开发场景。
本文介绍如何使用Python客户端通过impyla库连接Impala数据库。内容涵盖环境配置、HS2服务端口设置、SQL执行、结果遍历及利用Pandas进行数据分析的方法。针对大数据集,建议通过CTAS写入HDFS,并解决了pandas安装中常见的Visual C++依赖问题。
本文深入解析MySQL中B-Tree与Hash索引的核心差异。B-Tree支持范围查询和排序,是InnoDB/MyISAM默认选择;而Hash索引仅支持等值比较,时间复杂度为O(1),但仅限MEMORY和NDB引擎。文章详细说明了各自的查询限制、适用场景及索引失效条件,帮助开发者根据业务需求(如精确查找 vs 范围查询)做出正确选型。
本文详细记录了在Ubuntu系统中将MySQL数据目录从默认路径迁移至挂载的云硬盘(如/media/hdb1/db)的全过程。核心步骤包括:停止服务、复制文件并修正权限、修改AppArmor配置以允许新目录访问、更新my.cnf中的datadir指向,最后重启服务验证。操作前务必备份数据以防丢失。
本文整理了SQL数据库操作中最常用的基础语句,涵盖新建与删除表、数据的增删改查(CRUD)、字段的新增/修改/删除以及表的重命名和约束管理。通过清晰的代码示例,帮助开发者快速掌握SQL核心操作,提升数据库维护效率。
本文详细介绍如何在MySQL终端(命令行)中进行数据库和数据表的全面管理。涵盖从创建、查看到删除数据库,以及利用ALTER命令动态调整表结构(增删改字段),配合INSERT、DELETE、UPDATE、SELECT实现数据的增删改查,最后演示视图的创建与验证方法,帮助开发者摆脱图形界面依赖,深入掌握核心SQL逻辑。