

SQL Server 存储过程实现级联删除与多ID批量处理
本文详解如何在 SQL Server 存储过程中使用事务确保数据一致性,通过 CURSOR 遍历获取关联子级 ID,并拼接为 IN 条件执行级联删除。同时提供利用 CHARINDEX 和 SUBSTRING 手动分割逗号分隔 ID 列表的方法,适用于无需创建临时表或自定义函数的场景。
2026-10-15
7

本文详解如何在 SQL Server 存储过程中使用事务确保数据一致性,通过 CURSOR 遍历获取关联子级 ID,并拼接为 IN 条件执行级联删除。同时提供利用 CHARINDEX 和 SUBSTRING 手动分割逗号分隔 ID 列表的方法,适用于无需创建临时表或自定义函数的场景。
本文详解 MySQL 中清空数据的两种主要方式:DELETE 和 TRUNCATE。TRUNCATE 速度快但无法回滚且重置自增 ID;DELETE 支持 WHERE 条件且可事务回滚,但效率较低。文章通过语法对比和操作示例,帮助用户根据数据安全性和性能需求选择合适的语句。
在MySQL中,使用AFTER触发器处理关联表更新时,因无法拦截原始输入数据,可能导致库存超卖等逻辑漏洞。本文通过订单减库存案例,演示如何将触发器类型改为BEFORE INSERT,在数据写入前对下单数量进行限流判断,从而确保数据库业务逻辑的严谨性。
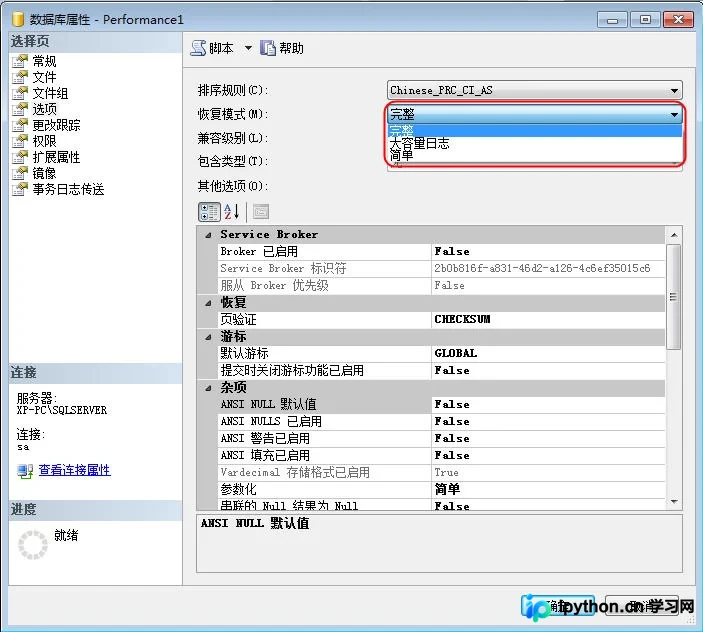
本文详解 SQL Server 数据库备份与还原核心机制,涵盖完整、差异、事务日志三种备份模式的原理、适用场景及还原顺序。深入解析三种恢复模式(完整、大容量日志、简单)对数据保护的影响,演示如何使用 SSMS 进行时间点还原及尾部日志备份操作,并提供不同数据变动频率下的最佳备份方案建议,帮助开发者掌握从基础备份到高级灾难恢复的完整技能。
本文详细解析 SQL Server 中的关键语法特性。对比了表变量、临时表与 TVP 的性能差异,阐述了 datetime 系列类型的区别。重点介绍了 MERGE 语句的同步逻辑、CTE 实现员工层级递归查询的方法,以及使用 GROUPING SETS 进行多维数据汇总的技巧,并提供了 Pivot 行转列与 Unpivot 列转行的具体代码示例。
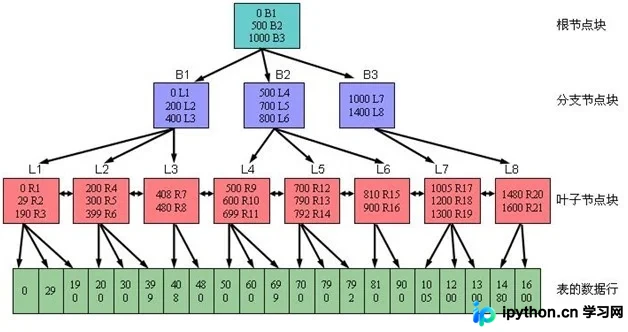
本文深入解析SQL Server基于B-树结构的索引原理,区分聚集索引与非聚集索引在数据存储与检索逻辑上的差异。重点阐述创建索引时的关键原则:确保包含并优化聚集索引、合理设计覆盖索引、控制索引数量以平衡读写性能。同时提供关于选择性、数据密度及复合索引顺序的实战建议,帮助数据库管理员提升查询效率并避免常见陷阱。
本文分析MySQL在执行临时表操作时出现"[Warning] Invalid (old?) table or database name"警告的原因。通过源码追踪,主要线索指向InnoDB引擎对标识符的编码转换过程,可能与数据库或临时表的字符集(如latin1)不一致有关。建议优先检查并统一修改数据库及临时表的字符集为UTF-8以尝试解决问题。
本文详细介绍在 MySQL 中为现有用户或新创建的用户设置、修改及初始化密码的几种常用方法。包括使用 SET PASSWORD 语句、GRANT 授权语句自动加密、直接修改 mysql.user 表以及通过命令行 mysqladmin工具重置 root 密码的操作步骤。所有涉及权限变动的操作后均需执行 FLUSH PRIVILEGES以刷新缓存,确保配置立即生效。
本文提供 SQL Server 中用于索引管理的核心 SQL 语句,包括查询碎片率大于 25% 的索引、发现缺失索引、自动执行索引重新组织或重建操作,以及查看表和指定表的索引使用情况。这些脚本有助于提升数据库性能,但建议在低负载时段运行或谨慎使用自动化维护逻辑。
在 SQL Server 数据库开发中,经常需要处理包含中英文混合的字符串并统计其中汉字的数量。本文介绍一种基于字符字节长度的巧妙算法:利用 DATALENGTH 函数获取数据的字节长度,而 LEN 函数返回字符长度。由于中文在 VARCHAR 中通常占 2 个字节,英文占 1 个字节,两者相减即可直接得出汉字的个数。该方法代码简洁且执行效率优于复杂的正则替换或循环拆分方案。
本文介绍在 SQL Server 中使用 T-SQL 去除字符串中连续重复分隔符的方法。通过计算连续出现的次数,利用循环配合 REPLACE 函数,实现将连续的多个空格(或其他字符)替换为单个分隔符的功能。
mytop 是 Linux 环境下类似 top 命令的 MySQL 实时监控工具,能直观展示当前连接数、查询吞吐量及慢查询信息。文章详细介绍了通过 cpan 安装依赖库并编译部署 mytop 的全过程,说明了基于命令行参数与 ~/.mytop 配置文件两种常用的调用方式,帮助 DBA 快速诊断数据库负载状况。