

Python连接SQLServer报错:未发现数据源名称且未指定默认驱动程序的排查与解决
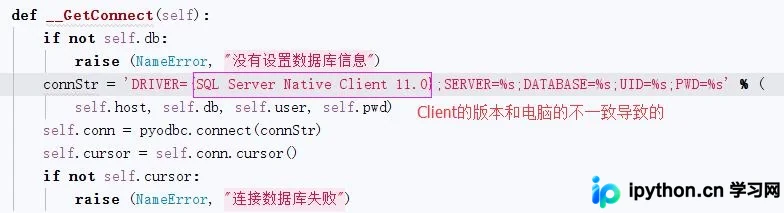
本文解决Python使用pyodbc连接SQL Server时出现的“未发现数据源名称并且未指定默认驱动程序”错误。该问题通常由客户端DRIVER配置与服务端ODBC数据源版本不一致引起。通过将连接字符串中的驱动程序名称调整为与服务器端一致(如从Native Client 11.0改为对应版本),即可恢复正常连接。
2026-10-13
7

本文解决Python使用pyodbc连接SQL Server时出现的“未发现数据源名称并且未指定默认驱动程序”错误。该问题通常由客户端DRIVER配置与服务端ODBC数据源版本不一致引起。通过将连接字符串中的驱动程序名称调整为与服务器端一致(如从Native Client 11.0改为对应版本),即可恢复正常连接。
本文介绍如何使用Python的openpyxl库,自动读取Excel文件中指定列的数据,并批量生成对应的SQL更新语句。通过自动化脚本替代手动复制粘贴,有效简化了从数据库查询结果到SQL脚本生成的流程,提升数据处理效率。
本文详解Python中如何使用Flask-SQLAlchemy连接MySQL数据库。涵盖flask、MySQL-Python驱动及Flask-SQLAlchemy的安装步骤,重点解决Windows下第三方whl文件获取及终端编码导致的警告问题。提供完整的myflask.py与config.py配置代码示例,解析控制台输出的常见FSADeprecationWarning及字符串值警告,帮助开发者快速搭建稳定的数据库连接环境。
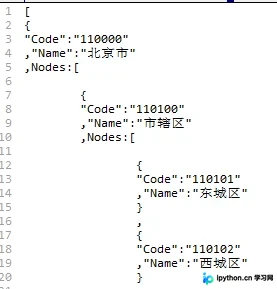
本文详细介绍如何使用Python连接SQL Server数据库,通过mssqlhelper库执行查询,并将省、市、区三级行政区划数据递归写入JSON文件。文章提供完整Python代码示例,展示如何构建嵌套JSON结构并处理文件IO,同时推荐多款实用的在线JSON格式化工具以辅助开发。
本文介绍如何利用Python和pymysql库批量执行SQL文件以修改多个数据库。通过连接数据库、遍历所有库、删除指定表后重新导入SQL脚本,实现自动化批量操作。文章详细解析了代码逻辑,包括处理编码问题、分割SQL语句及异常捕获,旨在提升数据库维护效率,减少重复劳动。
本文介绍了在Python中使用Pandas读取MySQL数据库数据并转换为DataFrame的两种主要方法。第一种方式基于SQLAlchemy引擎,适用于Pandas 1.9及后续版本,通过配置连接参数建立引擎后执行SQL查询;第二种方式利用MySQLdb直接连接数据库进行数据获取。文章提供了具体的代码示例和注意事项,帮助开发者根据项目需求选择合适的技术方案。
本文介绍在Python中处理超长SQL语句的实用方法。通过将SQL字符串用括号包裹实现自动多行拼接,并在每行末尾添加%s占位符,最后使用元组依次传入变量值。该方法有效解决了长SQL编写困难、易出错及参数传递复杂的问题,提升代码可读性与维护性。
本文详细解析如何在Flask框架中集成sqlite3数据库。通过新建models.py定义数据模型,利用flask_script扩展创建manage.py管理脚本,实现数据库初始化、数据保存及查询功能。文中提供了完整的代码示例与终端运行命令,帮助开发者快速掌握Flask与SQLite3的连接与操作方法。
本文介绍如何使用Python将CSV文件中的数据读取并导入MySQL数据库。通过示例代码展示连接数据库、解析CSV文件及执行插入语句的具体步骤,帮助开发者快速实现数据迁移功能。
本文介绍在Ubuntu系统中使用pip安装mysql-python时,因缺少mysql_config命令导致EnvironmentError的解决方法。通过执行sudo apt-get install libmysqlclient-dev安装相关依赖即可修复该问题,适用于Debian系Linux发行版。
本文介绍一种使用Python将MySQL数据同步至Elasticsearch的轻量级方案。针对Logstash-input-jdbc同步频率低的问题,该方案通过读取MySQL更新字段的时间戳进行增量查询,并设定10秒同步间隔。通过对比上次同步时间与当前时间解决服务器时间差,利用MySQL ID作为ES ID避免重复,确保数据同步的实时性与完整性。
本文介绍在Django中查看SQL执行语句及耗时的两种方法。第一种通过Queryset的query属性仅适用于SELECT语句;第二种利用connection.queries可打印所有SQL及耗时。支持多数据库场景,通过connections指定特定数据库连接进行监控,帮助开发者优化数据库性能。