MySQL分组查询详解:GROUP BY实战与聚合技巧
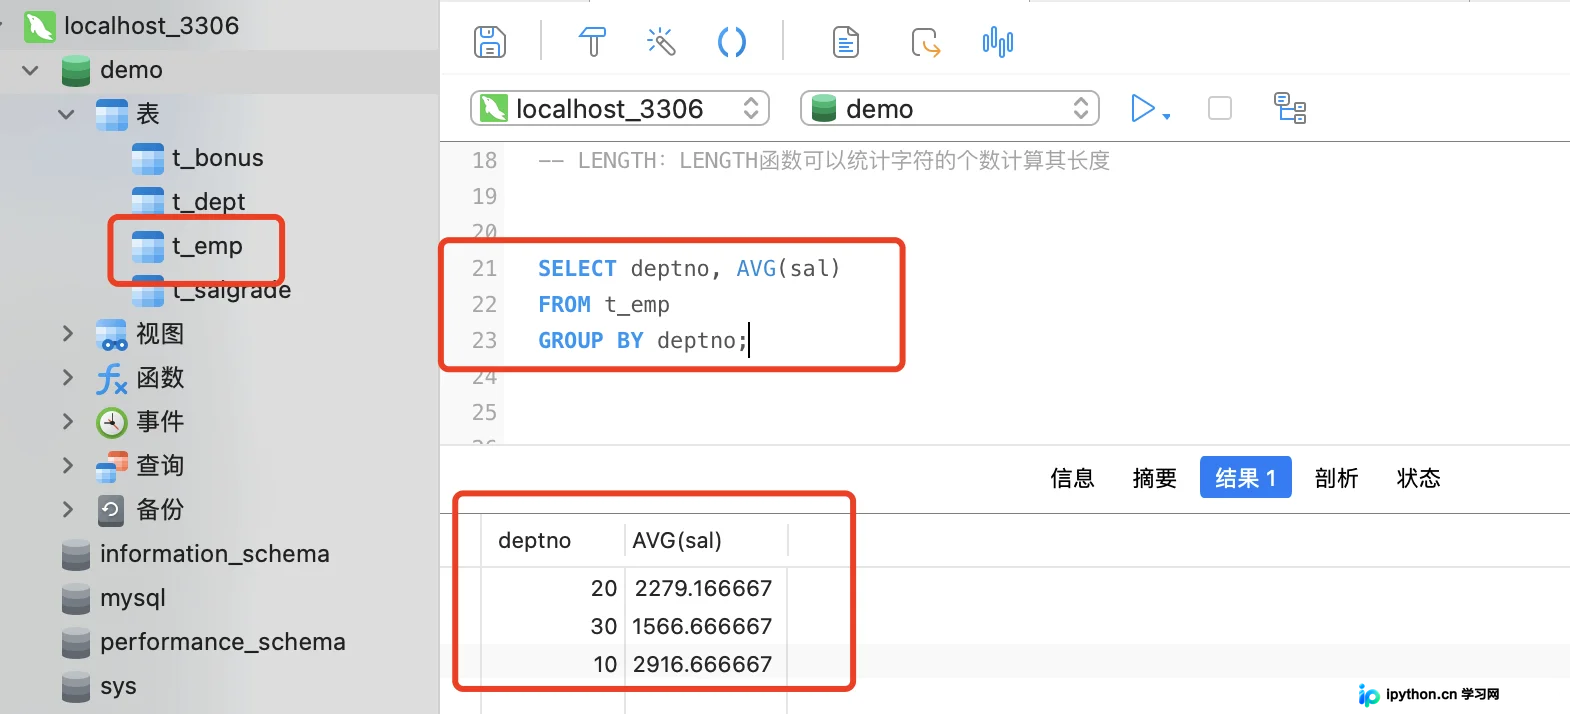
本文详解MySQL中GROUP BY分组查询的核心用法,涵盖逐级分组、SELECT子句规范、WITH ROLLUP汇总及GROUP_CONCAT函数。通过具体示例展示如何高效处理多字段分组统计,并解析SQL执行顺序,帮助开发者掌握复杂数据汇总技巧。
2026-10-13
7

本文详解MySQL中GROUP BY分组查询的核心用法,涵盖逐级分组、SELECT子句规范、WITH ROLLUP汇总及GROUP_CONCAT函数。通过具体示例展示如何高效处理多字段分组统计,并解析SQL执行顺序,帮助开发者掌握复杂数据汇总技巧。
针对需从多个不关联表中获取统计数据的场景,传统笛卡尔积或多次查询会导致性能下降。本文介绍使用 UNION ALL 将不同表的查询结果纵向合并,再通过外层 SUM 聚合求和的方法,实现单次请求完成多表统计,显著降低数据库压力并提升执行效率。
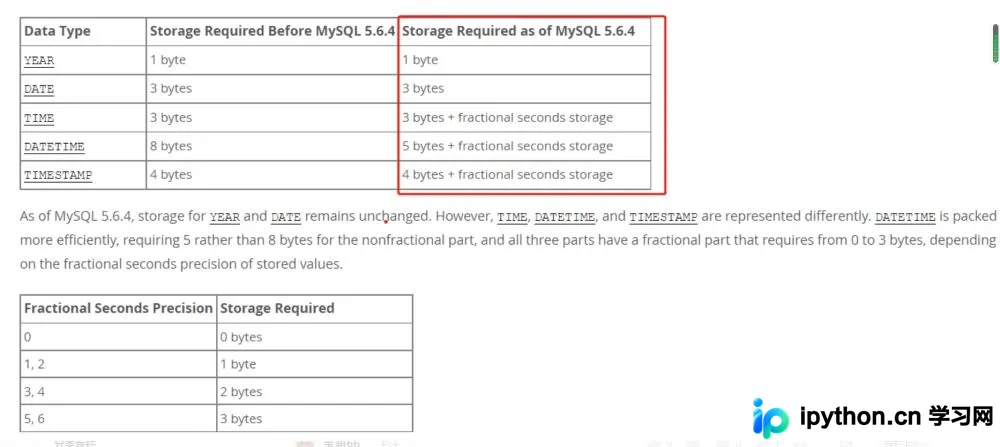
本文深入解析MySQL中datetime与timestamp在存储空间、取值范围及时区处理上的核心差异,详解如何通过参数定义毫秒精度。同时揭示Java应用连接MySQL时因serverTimeZone配置不当导致的时间偏差原理,并提供TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP的最佳实践。
本文系统梳理 MySQL 结构化查询语言的核心分类,涵盖数据定义语言(DDL)的库表结构管理、数据操作语言(DML)的数据增删改及聚合函数计算,以及数据查询语言(DQL)的条件过滤、模糊匹配与分组统计。通过标准语法解析与代码实例演示,帮助开发者快速掌握关系型数据库的基础操作与逻辑规范。
本文介绍如何在MySQL中通过修改my.ini配置文件中的lower_case_table_names参数来设置表名是否区分大小写。该参数仅在数据库初始化前生效,运行中修改无效且可能导致数据丢失。不同操作系统下的默认值与行为存在显著差异,使用前务必做好数据备份并谨慎操作。
在SQL Server中,处理字段NULL值常遇到类型转换错误。本文介绍两种核心方案:使用CASE WHEN语句进行逻辑判断与显式转换,或利用COALESCE函数自动返回第一个非空表达式。掌握这两种方法可有效解决数据导出或展示时的NULL显示问题,确保结果集的格式统一。
本文详细对比了如何在MySQL和MSSQL中使用While循环语句来生成和插入测试数据。在MSSQL中可以直接通过脚本执行,而MySQL通常需要将其封装为存储过程再调用。文章提供了两种数据库的具体代码实现,帮助开发者快速构建用于功能验证的模拟数据表结构。
本文详细介绍在Windows和Linux环境下通过命令行将SQL备份文件导入MySQL数据库的多种方法。涵盖mysql client交互模式、重定向符导入以及Linux系统命令等多种途径,特别针对中文乱码问题给出set names utf8等关键参数建议,帮助用户快速完成数据迁移与恢复。
本文详细介绍 MySQL 中数据的排序操作与常用的单行处理函数。通过实际案例演示如何使用 ORDER BY 实现单字段、多字段的升序与降序排列,以及结合 WHERE 子句的复合筛选。同时深入解析 LOWER/UPPER、SUBSTR、CONCAT、LENGTH、TRIM、ROUND 和 NVL 等字符串及数值函数的具体用法与场景,帮助开发者高效完成数据清洗与格式化任务。
本文详细介绍如何利用 XtraBackup工具实现 MySQL主库到从库的无缝数据迁移,配合binlog日志配置完成主从同步环境的快速搭建。通过修改my.cnf参数、创建同步用户及执行增量备份导入,确保生产环境下的数据一致性与服务连续性。
本文详解 MySQL 数据插入的高效优化方案。针对 MyISAM引擎,重点讲解 concurrent_insert、bulk_insert_buffer_size及 load data infile 等配置与操作;针对 InnoDB 引擎,提供关闭 unique_checks、foreign_key_checks及 autocommit 的具体步骤。通过合理调整锁优先级和批量提交机制,可显著提升大数据量写入速度并降低锁竞争。
本文深入剖析 MySQL 中导致索引失效的常见场景,涵盖模糊查询 `%` 前缀、隐式类型转换、非索引列 OR 连接、违背最左前缀匹配、字段运算与函数处理等。结合 B+ 树原理、逻辑架构及执行计划(Explain)指标,提供针对性的 SQL 写法优化建议,帮助开发者避免全表扫描,提升数据库查询性能。