

MySQL 5.7在Windows下配置区分大小写及设置默认编码utf8mb4
本文介绍如何在Windows环境下配置MySQL 5.7。通过修改my.ini文件,设置default-character-set为utf8mb以支持完整Unicode;配置lower_case_table_names=2实现表名区分大小写。同时详解从utf8迁移到utf8mb4的“伪”转换风险、在线DDL限制及索引键超长(Error 1071)问题的解决方法。
2026-10-15
6

本文介绍如何在Windows环境下配置MySQL 5.7。通过修改my.ini文件,设置default-character-set为utf8mb以支持完整Unicode;配置lower_case_table_names=2实现表名区分大小写。同时详解从utf8迁移到utf8mb4的“伪”转换风险、在线DDL限制及索引键超长(Error 1071)问题的解决方法。
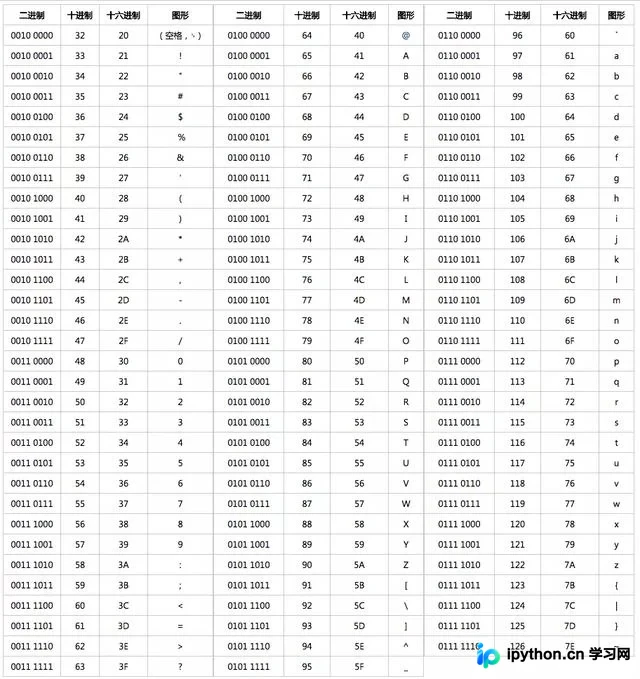
本文解释 MySQL 中 utf8 仅支持最大3字节字符,无法存储4字节的 Emoji;而 utf8mb4 是完整的 UTF-8 实现。通过建表示例演示使用 utf8 导致插入含 Emoji 数据报错的原因及解决方案。
本文系统梳理MySQL数据库的核心操作:涵盖日期、字符串、数字及聚合函数的语法与应用;解析Union合并数据的原理与实践;详解虚拟表视图的创建逻辑与优缺点;介绍各类索引(主键、唯一、普通)的作用及增删改维护语句,并总结常见报错代码如1064和1075的快速排查方法。
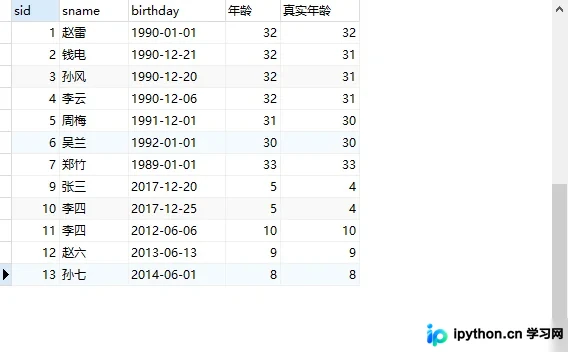
本文详解SQL Server中获取字符串长度的两个核心函数LEN()与DATALENGTH()的区别。LEN()返回指定字符串表达式中的字符数,自动忽略尾部空格;而DATALENGTH()返回占用数据的实际字节数,包括尾部空格且NULL值为NULL。掌握两者差异有助于在数据存储、校验及截断操作中做出准确选择,避免数据处理的潜在错误。
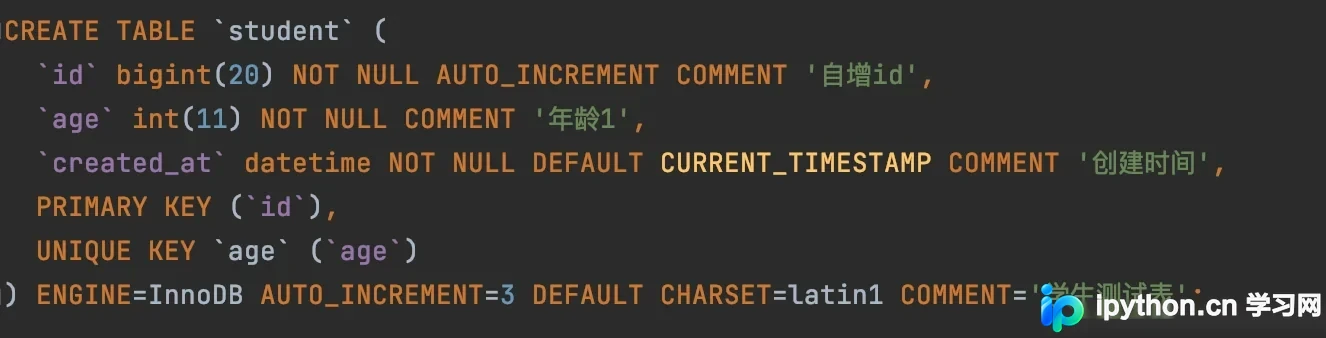
本文详解在MySQL中处理批量插入重复数据的三种核心策略:INSERT IGNORE、REPLACE INTO 以及 INSERT ... ON DUPLICATE KEY UPDATE。通过对比它们对主键和唯一键的响应机制,剖析执行逻辑差异及潜在风险(如自增ID不连续、数据丢失),并针对主从复制场景给出避坑建议,帮助开发者选择最适合的业务场景。
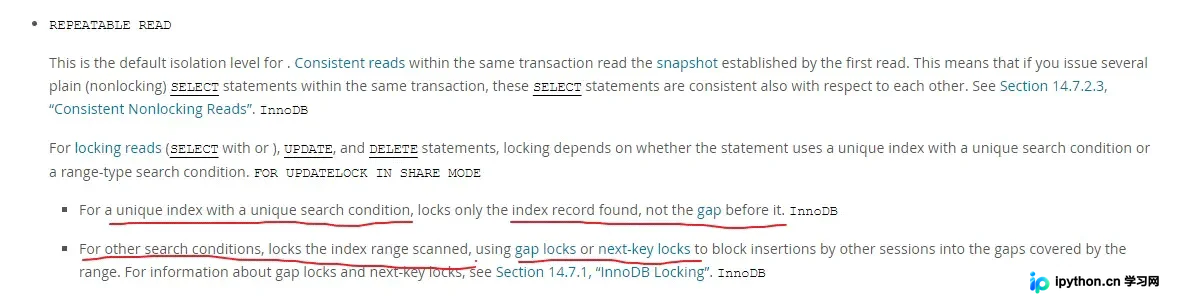
当在 MySQL REPEATABLE READ 隔离级别下,使用 UPDATE 且 WHERE 条件未命中索引时,InnoDB 会对全表添加 next-key locks(记录锁+间隙锁)。若此时另一事务插入数据占用了该间隙范围,便极易引发死锁。本文通过真实日志拆解加锁逻辑,并提供基于 dead_lock 表的完整复现代码,帮助开发者避免此类因索引缺失导致的并发阻塞问题。
本文详细讲解如何使用Node.js内建http模块搭建本地HTTP服务器,并通过第三方mysql包连接MySQL数据库。涵盖从环境配置、代码编写到服务启动及数据查询的全过程,帮助开发者快速掌握Node.js服务端基础操作。
在MySQL数据库中,若字段内容包含首尾回车或换行符导致比对失败,可使用 `REPLACE` 配合 `TRIM` 函数处理。推荐写法为 `TRIM(REPLACE(field, '\r\n', ' '))` 以清理全部空白,或使用 `TRIM(BOTH '\r\n' FROM field)` 仅修剪两端字符,确保数据精确匹配。
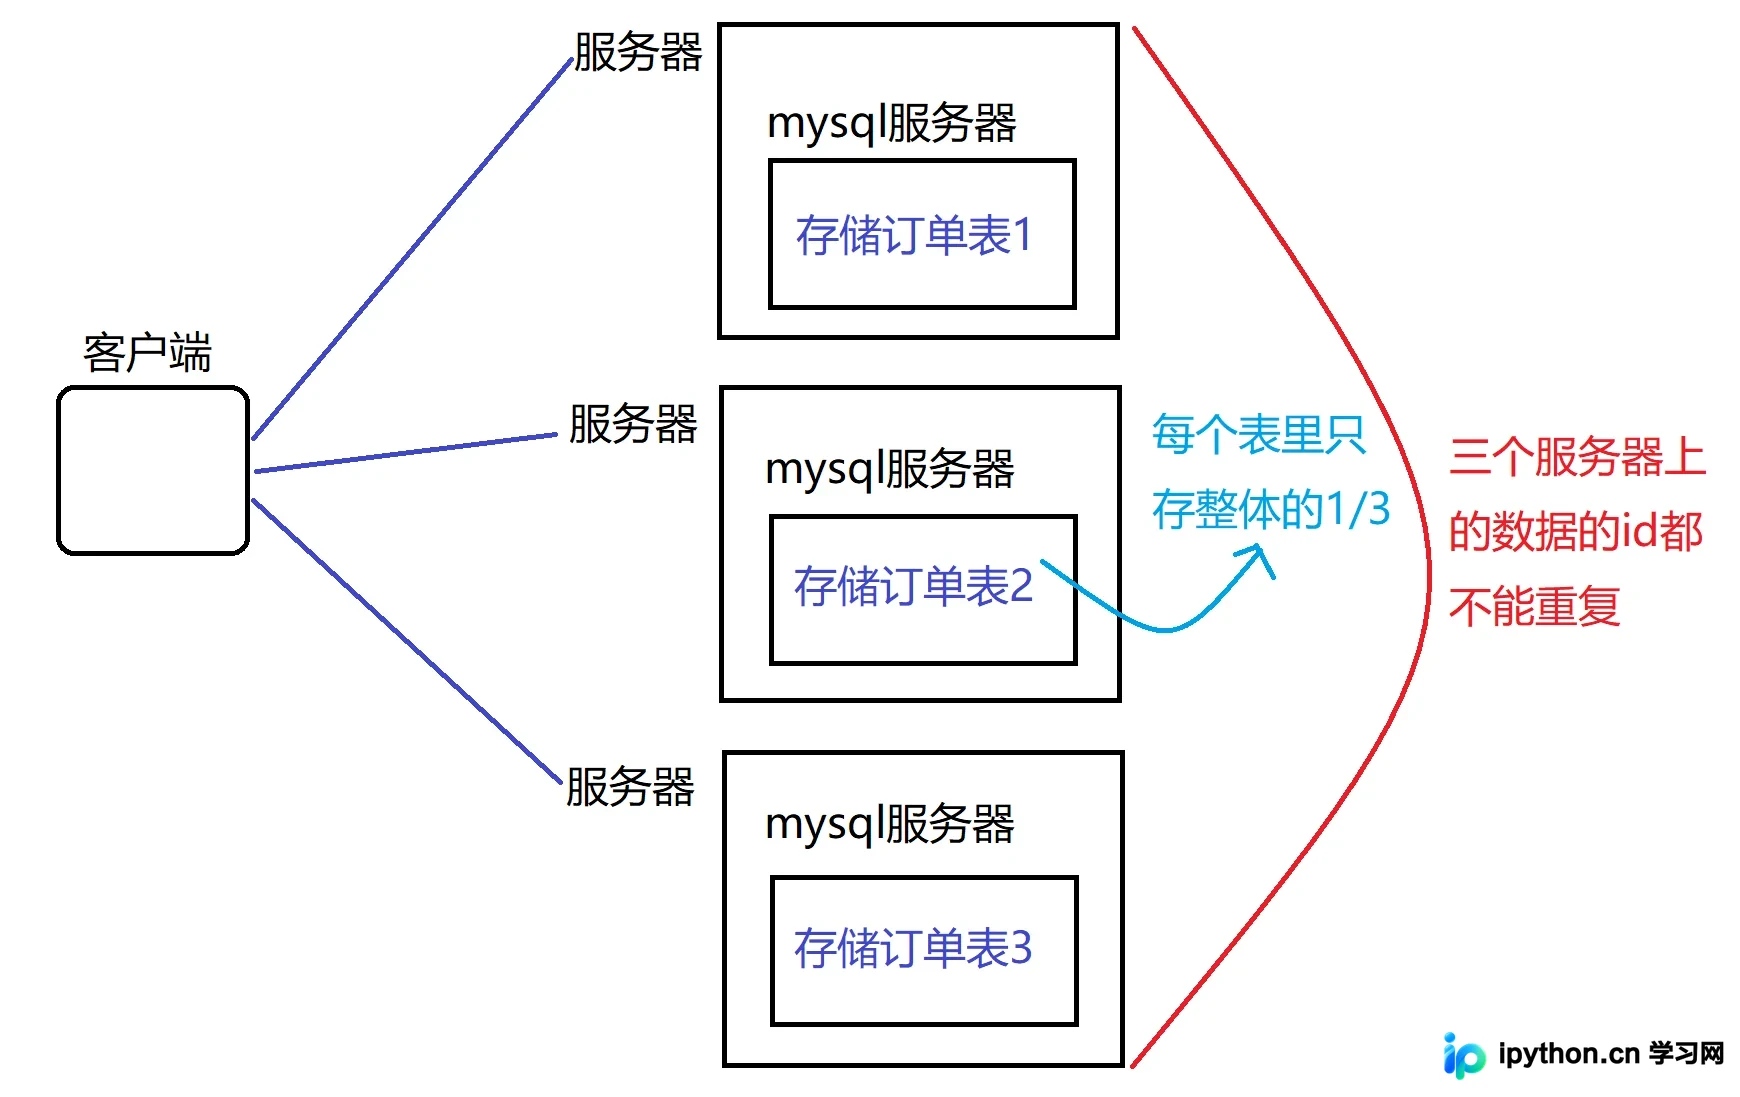
本文详细解析 MySQL 中的六种核心约束,涵盖 NOT NULL、UNIQUE、PRIMARY KEY(含自增与联合主键)、FOREIGN KEY 及分布式 ID 生成方案。同时深入讲解表的三种关系设计,并通过大量 SQL 代码示例演示聚合统计、内/外连接、子查询及 UNION 等复杂查询操作,帮助开发者掌握数据完整性校验与高效检索技巧。
在使用MySQL进行数据查询时,若未妥善设置排序条件、注意字段唯一性或正确使用LIMIT,容易导致结果集顺序不稳定、分页数据重复以及聚合计算错误。本文通过具体案例深入分析这三个典型问题,并提供正确的处理方案。
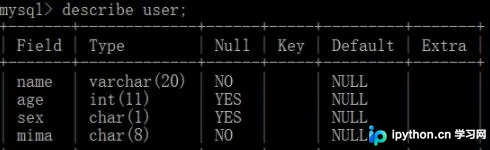
本文介绍如何使用Python连接MySQL数据库,构建一个基础的图书借阅系统。内容涵盖用户表、图书表和借阅表的结构设计,以及主程序、图书管理和数据库操作模块的代码实现,帮助开发者理解Python与数据库交互的基本流程。
在SQL Server中,若需让某字段允许存在多个NULL值,但非NULL值必须唯一,标准唯一索引会因NULL不参与比较而失效。针对SQL Server 2008及以上版本,可使用筛选索引(Filtered Index)配合WHERE Caption IS NOT NULL谓词优雅解决;低版本则需通过自定义函数结合CHECK约束进行逻辑校验。本文详解三种方案的代码实现与适用场景。