Python 正则表达式匹配任意字符(含换行符)的正确写法
在 Python 中使用正则表达式时,默认的 . 点符号无法匹配换行符,导致跨行文本获取失败。本文指出该限制并提供正确解决方案:使用 [\s\S]*、[\d\D]* 或 [\w\W]* 等字符类组合来匹配包括换行符在内的任意字符,确保能完整提取多行文本内容。
2026-10-14
4

在 Python 中使用正则表达式时,默认的 . 点符号无法匹配换行符,导致跨行文本获取失败。本文指出该限制并提供正确解决方案:使用 [\s\S]*、[\d\D]* 或 [\w\W]* 等字符类组合来匹配包括换行符在内的任意字符,确保能完整提取多行文本内容。
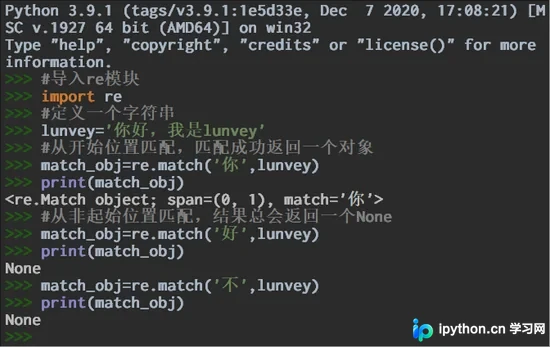
本文详细解析Python3.9.1中re模块的match方法。介绍其语法结构、flags标志位用法,并深入讲解匹配成功后返回的Match对象属性,包括group、span、pos及endpos的使用,帮助开发者准确提取字符串匹配结果。
在C#开发中,若需精确统计字符串内的中文汉字数量,可结合正则表达式与遍历逻辑实现。核心利用Unicode范围\u4E00-\u9FA5识别汉字,通过逐字符匹配计数。本文提供完整代码示例及关键参数说明,帮助开发者快速集成该功能。
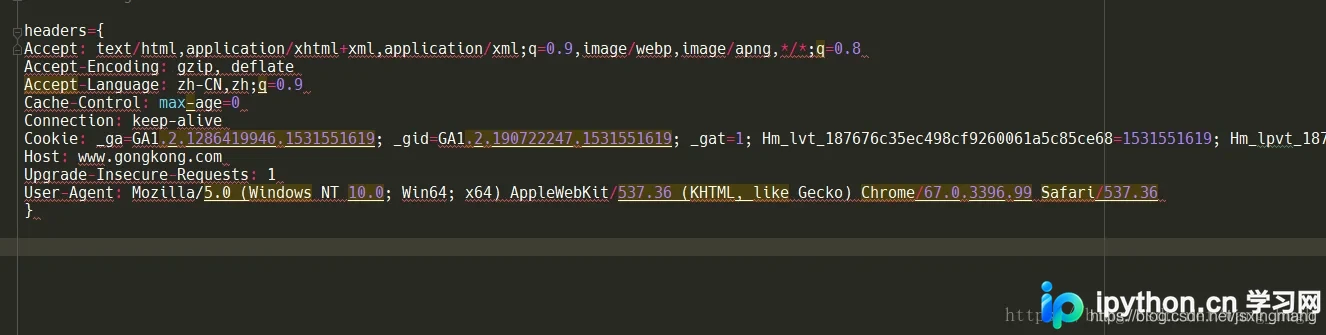
本文介绍如何在 PyCharm 中利用正则替换功能,快速将浏览器复制的 Request Headers 文本转换为标准的 Python 字典键值对格式。通过 Ctrl+R 调用正则工具,配合特定正则表达式与替换规则,可一键完成引号添加与格式整理,大幅提升爬虫开发效率。
本文详细介绍 PHP 中处理正则表达式的核心函数,包括用于匹配的 preg_match() 及其数组捕获特性,已废弃的 POSIX ereg/ereg_replace 系列与 Perl 兼容的正则函数 preg_replace() 的区别。通过日期匹配和字符串替换等实例,帮助开发者掌握高效文本处理的方法。
本文详细解析在C#中使用正则表达式匹配中文字符串的四种常见场景。通过Unicode编码范围[\u4e00-\u9fa5],分别演示了如何判断字符串是否纯中文、包含中文、以中文开头或结尾,并提供了对应的正则模式及关键字符含义说明,适用于常见的文本校验需求。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详解如何使用Python脚本批量处理10000份产品Log文件,自动提取SN、IMEI和ICCID信息并生成Excel表格。通过遍历目录、读取文件内容并结合正则表达式匹配关键字,实现高效的数据自动化采集,适用于大规模日志数据分析场景。
本文详细解析Python中regex库的常见用法,涵盖直接调用、编译及匹配操作。通过具体代码实例展示如何对字符串和字符进行正则搜索与匹配,帮助开发者掌握regex在项目中的实际应用技巧。
在PHP开发中,当后端返回的JSON字符串Key缺失双引号时,json_decode会解析失败。本文介绍一种通过正则表达式自动补全双引号的兼容方案,确保能正确将此类非标准JSON转换为数组或对象,提升接口处理的鲁棒性。
本文详解如何利用Python正则表达式从文本中精准提取版本号。通过解析正则模式r'\d+\.(?:\d+\.)*\d+',结合re模块的findall与group方法,实现从源文件读取并写入目标文件的全流程。文章还深入对比了捕获组与非捕获组的区别,帮助开发者避免常见陷阱,提升文本解析效率。
本文通过Python代码示例,演示如何利用正则表达式提取包含特定关键词(如pass)的文本行,并进一步展示如何清洗数据,去除行号、特定前缀及文件扩展名。同时补充了\d、\w、\s等常用正则元字符的匹配规则,适用于日志分析与文本清洗场景。