

Python urllib提交Web表单完整实现
本文介绍如何使用Python的urllib库提交Web表单。通过定义EntryDemo类继承Frame,设置表单字段如用户名、密码、操作和范围,并使用urllib.urlencode编码数据。接着利用urllib2.Request创建POST请求,通过urllib2.urlopen发送请求并读取返回内容,实现完整的表单提交流程。
2026-10-11
6

本文介绍如何使用Python的urllib库提交Web表单。通过定义EntryDemo类继承Frame,设置表单字段如用户名、密码、操作和范围,并使用urllib.urlencode编码数据。接着利用urllib2.Request创建POST请求,通过urllib2.urlopen发送请求并读取返回内容,实现完整的表单提交流程。
本文介绍如何利用Python3.6结合urllib和BeautifulSoup库,根据电影或电视剧名称自动获取下载链接。通过构建搜索URL、解析HTML页面、提取详情链接及最终下载地址,实现自动化抓取。代码包含处理编码、过滤特定类型内容及模拟浏览器请求等关键步骤,适用于学习网络爬虫基础及数据提取技术。
本文介绍使用Python3通过urllib库抓取微信网页版账单数据的方法。重点解析如何从Fiddler抓包获取exportkey、userroll_encryption及pass_ticket参数,解决SSL证书验证问题,并实现分页数据解析与数据库存储。
本文介绍如何利用 Python 3 和 PyQt5 模块开发一个简单的 IP 查看器小程序。通过 urllib 模块获取网页数据,并处理 User-Agent 伪装以绕过反爬限制。文章详细解析了函数定义、字符串处理及 QSS 样式表在界面美化中的应用,帮助开发者掌握网络请求与 GUI 编程的基础技巧。
本文详解Python3中Cookie的创建、保存与读取方法。通过CookieJar、LWPCookieJar等类,结合urllib.request实现HTTP请求中的Cookie管理。涵盖Cookie的生成、持久化到文件(如LWPCookieJar)以及从文件读取并复用Cookie进行后续请求的完整流程,适用于需要模拟登录或保持会话状态的爬虫开发场景。
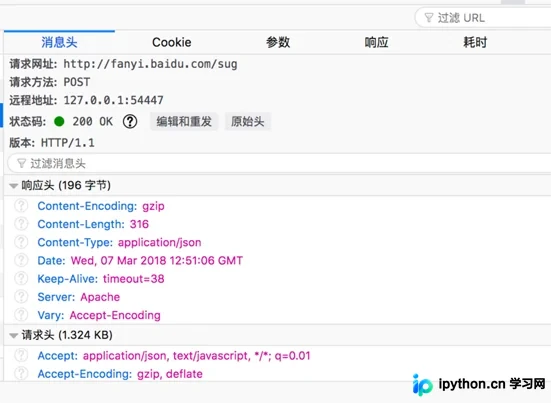
本文介绍如何使用Python标准库urllib和json模块调用百度翻译API。通过构造POST请求,设置User-Agent及kw参数,解析返回的JSON数据,实现简单的文本翻译功能。
本文介绍Python爬虫的基本概念与核心原理,重点讲解如何使用urllib和urllib2库发起HTTP请求。通过对比GET与POST两种数据提交方式,演示URL编码、参数传递及登录模拟的具体代码实现,并包含基于try-except的异常处理机制,帮助初学者掌握网络数据抓取的基础操作。