Python3实现贴吧图片批量抓取与本地保存
本文提供Python3环境下抓取百度贴吧图片的完整代码示例。通过urllib获取页面源码,利用re正则表达式匹配图片URL,并结合urlretrieve实现图片的批量下载与本地存储。代码包含异常处理机制,适合初学者学习网络爬虫基础操作。
2026-10-12
6

本文提供Python3环境下抓取百度贴吧图片的完整代码示例。通过urllib获取页面源码,利用re正则表达式匹配图片URL,并结合urlretrieve实现图片的批量下载与本地存储。代码包含异常处理机制,适合初学者学习网络爬虫基础操作。
本文详解Python3中Cookie的创建、保存与读取方法。通过CookieJar、LWPCookieJar等类,结合urllib.request实现HTTP请求中的Cookie管理。涵盖Cookie的生成、持久化到文件(如LWPCookieJar)以及从文件读取并复用Cookie进行后续请求的完整流程,适用于需要模拟登录或保持会话状态的爬虫开发场景。
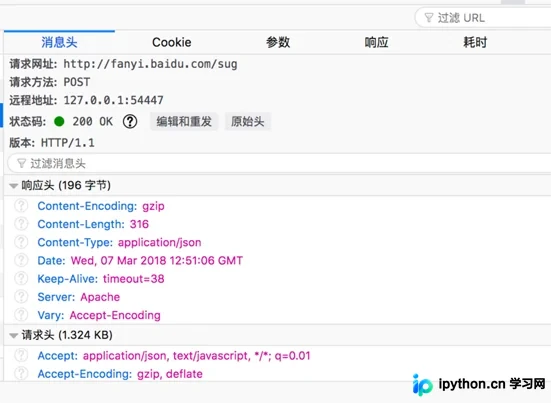
本文介绍如何使用Python标准库urllib和json模块调用百度翻译API。通过构造POST请求,设置User-Agent及kw参数,解析返回的JSON数据,实现简单的文本翻译功能。
本文介绍Python爬虫的基本概念与核心原理,重点讲解如何使用urllib和urllib2库发起HTTP请求。通过对比GET与POST两种数据提交方式,演示URL编码、参数传递及登录模拟的具体代码实现,并包含基于try-except的异常处理机制,帮助初学者掌握网络数据抓取的基础操作。
针对Python内置网络库的调用场景,提供网页抓取的标准实现方案。涵盖基础响应获取、自定义Request参数、全局代理注入、Cookie状态维持以及重定向追踪等核心操作。通过结构化的函数封装与错误捕获机制,解决常规HTTP交互中的断连、封禁与会话丢失问题,助力自动化数据采集流程的稳定运行。
本文介绍了在Python中利用urllib模块根据URL地址下载小文件的具体实现方法。通过示例代码展示了如何建立连接、读取内容并写入本地文件,适用于简单的文件下载场景。
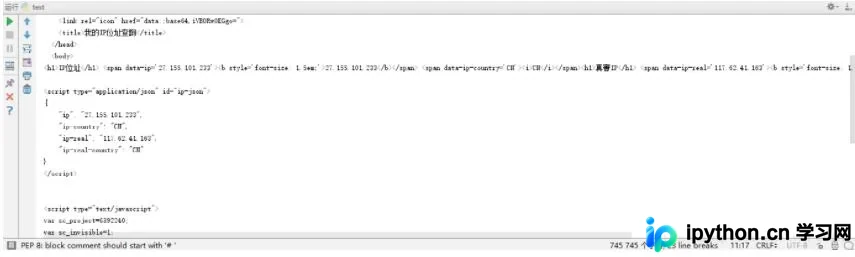
本文介绍了使用Python的urllib库通过指定代理IP访问whatismyip.com.tw网站的完整代码实例。文中演示了如何配置ProxyHandler和Opener,并分析了该代理IP(27.155.101.233:3128)的匿名程度。结果显示该代理为透明代理,真实IP被网站识别,虽不满足高匿需求,但仍适用于部分对匿名性要求不高的场景如投票等。