

Python正则表达式爬虫实战:从基础语法到个人博客数据抓取
本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
2026-10-13
2

本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
本文深入解析Python中正则表达式的组嵌套机制,通过具体代码实例展示如何构建复杂的正则模式。详细说明了利用嵌套组匹配多重字符序列的方法,并附带完整的测试代码及输出结果分析,帮助开发者掌握高级正则技巧。
本文详细介绍Python中正则表达式的fullmatch()函数,该函数用于实现字符串与模式的全匹配。通过对比search()和match()函数,展示fullmatch()的具体用法及示例,帮助读者理解全匹配的概念与应用场景。
本文介绍如何在Python中使用正则表达式排除指定字符。通过在前向字符集前添加^符号,可实现反向匹配,即匹配不包含指定字符(如横线、句号、空格)的序列。结合具体代码示例,展示test_patterns函数的用法及匹配结果分析,帮助开发者掌握正则表达式的排除技巧。
本文介绍在Python中使用re模块时,通过compile函数将正则表达式预编译为RegexObject对象的方法。相比每次调用模块级函数,预编译能复用编译结果,避免重复解析开销,从而显著提升多次匹配场景下的搜索效率。
本文介绍如何在Python中利用内嵌的re模块进行正则匹配。通过编译字节码由C引擎执行,展示从文本中查找单词的具体代码示例,并解析start()与end()方法获取匹配位置的用法,帮助开发者掌握基础的正则搜索技巧。
本文详解Python中正则表达式模块re的search方法。重点解析group()与groups()函数的用法差异:group()默认返回完整匹配字符串,支持指定分组索引;groups()以元组形式返回所有括号分组内容。通过具体示例帮助开发者准确掌握正则匹配结果的提取技巧。
本文系统讲解Python中正则表达式(Regular Expression)的基础用法。内容涵盖re模块中findall、search、match、split、sub等核心函数的功能与参数,详细解析元字符如点号、星号、加号、问号、方括号及圆括号的具体作用与贪婪/非贪婪匹配差异,帮助读者掌握文本处理与爬虫数据提取的关键技能。
本文深入解析Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、分组及贪婪与非贪婪模式。结合爬虫场景,详细演示如何利用re模块提取邮箱、处理相对路径及批量替换,助力开发者高效进行文本处理与数据抓取。
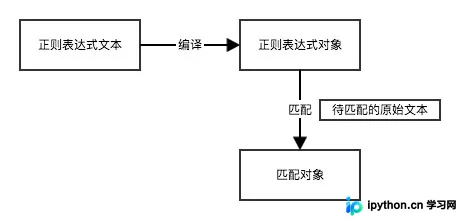
本文系统讲解Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、逻辑分支及分组技巧。重点解析贪婪与非贪婪模式,并结合爬虫场景演示如何利用sub函数与正则表达式进行HTML标签处理与路径替换,帮助开发者高效处理文本提取与验证任务。
本文系统介绍了Python中正则表达式的基本用法。详细解析了re模块中的核心函数,包括match与search的区别、sub与subn的替换操作、findall与finditer的提取方式,以及split和escape辅助函数的应用。通过具体代码示例,帮助开发者掌握文本处理、日志分析及数据清洗中的正则技巧。
本文深入解析Python中正则表达式的应用,涵盖re模块的核心功能。从基础字符匹配、字符串切分到分组提取与贪婪匹配机制,结合具体代码示例,详细讲解如何高效处理文本验证、数据提取及复杂模式匹配,帮助开发者掌握正则表达式的强大能力。