

Python切片语法(Slice Notation)详解与进阶用法
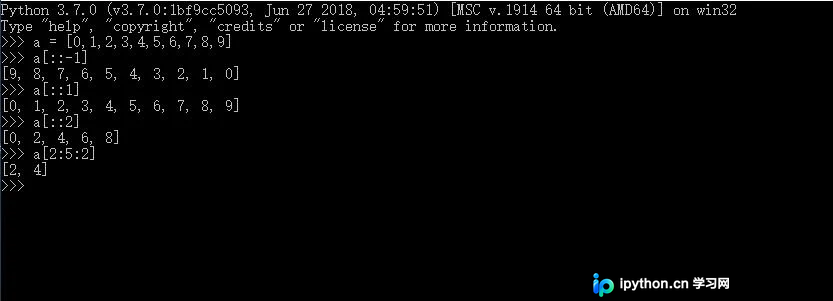
本文详细解析Python中列表切片(Slice Notation)的多种用法。涵盖基础切片a[i:j]的边界规则,省略索引时的默认行为,以及引入步进参数s后的进阶操作。重点讲解当步进s为负数时,起始与结束索引的默认值变化,并通过a[::-1]示例演示如何实现列表倒序,帮助开发者掌握高效的数据截取技巧。
2026-10-13
14

本文详细解析Python中列表切片(Slice Notation)的多种用法。涵盖基础切片a[i:j]的边界规则,省略索引时的默认行为,以及引入步进参数s后的进阶操作。重点讲解当步进s为负数时,起始与结束索引的默认值变化,并通过a[::-1]示例演示如何实现列表倒序,帮助开发者掌握高效的数据截取技巧。
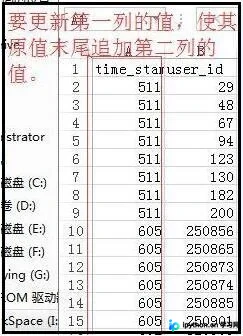
本文介绍在 Pandas 中调整 DataFrame 列顺序的两种常用方法。通过操作列名列表或使用 insert 函数,可以将特定列(如 Mid)移动至第一列。示例展示了从读取 CSV 文件到重新排列列并保存结果的完整流程,适用于数据预处理和特征工程场景。
本文介绍pandas中DataFrameGroupBy对象的agg方法,演示如何对分组数据执行聚合操作。涵盖对每一行使用agg、多列应用多个聚合函数以及单列指定聚合函数的具体代码示例,帮助开发者掌握灵活的数据聚合技巧。
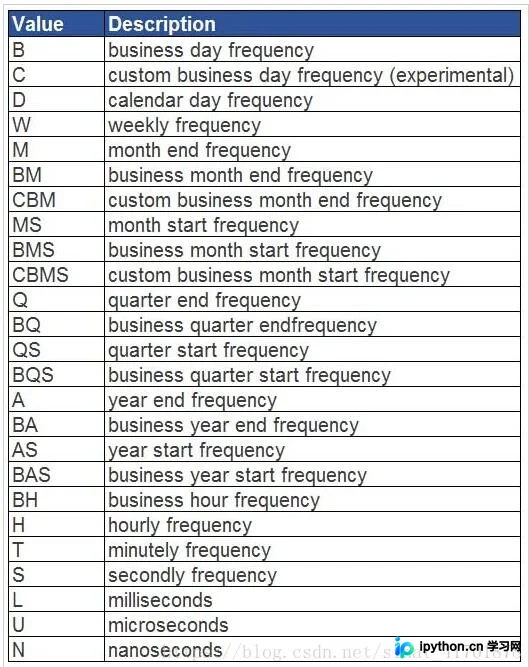
本文介绍如何利用 pandas 的 resample 方法对时间序列数据进行聚合处理。通过设置 datetime 索引,演示按年、月、日及自定义频率(如周、季度)提取数据,并结合 sum 与 fillna 实现具体列的汇总与缺失值填充,提供完整的代码示例供参考。
本文介绍如何在Python中将try-except捕获的异常详细信息输出到日志文件。通过结合traceback.format_exc()获取完整堆栈字符串,并利用logging模块配置日志文件路径,可实现错误信息的持久化记录,便于后续排查问题。
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵以标识缺失位置。进一步结合any()和sum()方法,展示如何快速判断哪些列包含缺失值并统计每列缺失值的数量,帮助开发者高效处理数据清洗工作。
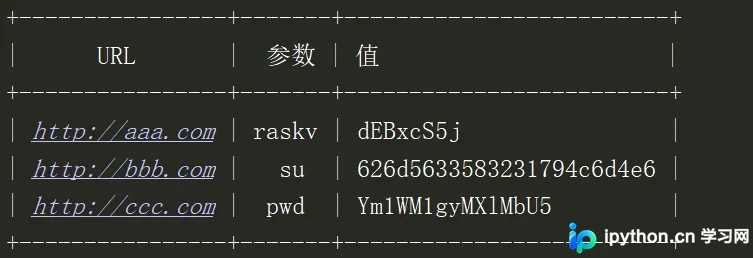
本文介绍如何在Python中使用prettytable库美化表格输出。通过add_row方法按行添加数据,或按add_column方法按列添加数据,并演示如何自定义表头、设置列对齐方式(如左对齐、右对齐),帮助开发者生成清晰易读的终端表格。
本文提供三种基于Shell脚本在Linux环境下自动安装Python3的完整方案,涵盖Python 3.6.1、3.6.6及3.7.0版本。脚本自动处理依赖包安装、源码下载编译、路径配置及软链接创建,适用于CentOS等主流发行版,帮助开发者快速搭建Python运行环境。
本文介绍在Python Pandas中处理DataFrame NaN值的方法。通过示例展示如何合并数据产生NaN,并使用where方法结合notnull()将NaN替换为None或其他指定值,帮助开发者进行数据清洗。
本文深入解析Python中h5py库的应用,对比numpy、scipy及pickle等存储方式。通过具体代码示例展示如何创建、读写HDF5文件,重点介绍dataset与group的使用方法及h5py在速度与压缩效率上的优势,适用于大规模科学数据存储场景。
本文介绍如何利用Python调用百度AI接口实现图片识别与翻译功能。通过监听快捷键截取屏幕图像,利用百度OCR接口提取文字,并结合有道词典进行翻译。文章提供了完整的代码示例,涵盖截图、图片保存、API调用及结果解析等关键步骤,帮助开发者快速实现自动化图文处理流程。
本文详细解析Python中深拷贝与浅拷贝的核心区别。通过对比直接赋值、list.copy()、copy.copy()及copy.deepcopy()四种方式,结合内存地址与子对象变化示例,阐明父对象与子对象的拷贝行为差异,帮助开发者避免可变对象引用的潜在Bug。