Python OpenCV图像形态学操作详解:腐蚀、膨胀与高级运算
本文详细解析Python OpenCV中的图像形态学操作。从基础的腐蚀与膨胀入手,讲解卷积核与迭代次数的影响;深入介绍开运算、闭运算、梯度运算及礼帽黑帽的原理与代码实现,帮助开发者掌握图像去噪、边缘提取及细节增强技巧。
2026-10-16
8

本文详细解析Python OpenCV中的图像形态学操作。从基础的腐蚀与膨胀入手,讲解卷积核与迭代次数的影响;深入介绍开运算、闭运算、梯度运算及礼帽黑帽的原理与代码实现,帮助开发者掌握图像去噪、边缘提取及细节增强技巧。
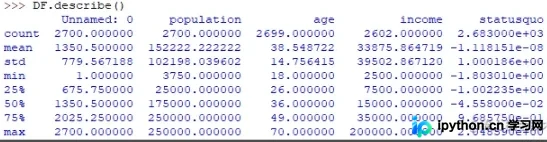
本文详解 Python 中的探索性数据分析(EDA)流程。通过 Pandas 的 describe() 和 value_counts() 快速获取数据分布与分类计数,利用 matplotlib 绘制箱线图识别异常值。进一步使用 groupby 进行分组统计,结合 scipy 的 f_oneway() 执行 ANOVA 方差分析,并通过 Pearson 相关系数评估变量间的相关性,帮助数据分析师深入理解数据特征与变量关系。
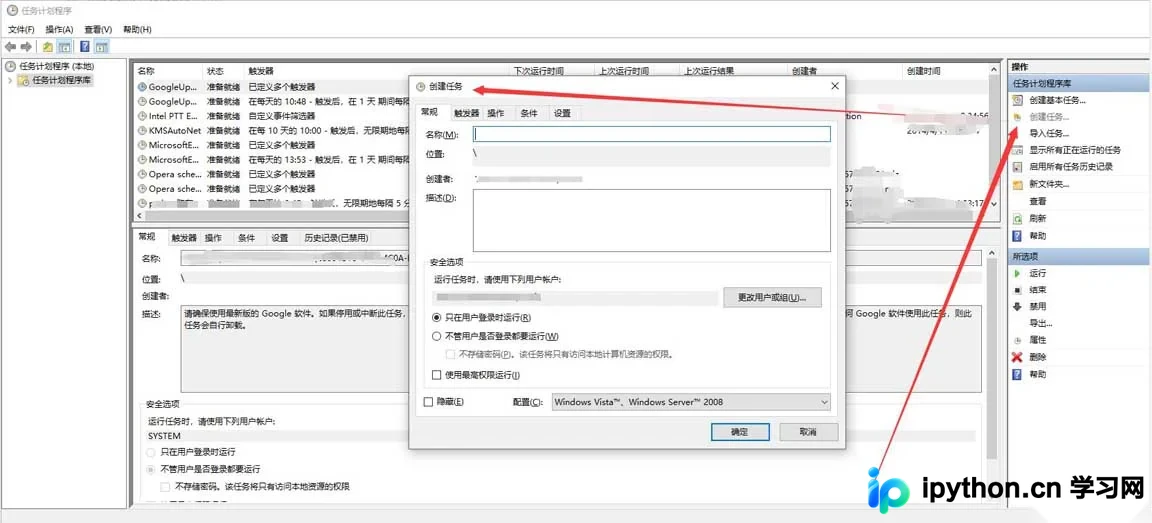
本文详细介绍在Windows系统中利用Python脚本结合Selenium库实现自动化数据采集与更新的方法。内容涵盖通过psutil监控Chrome进程状态、处理长时间未生成数据的异常退出机制,以及利用Windows计划任务实现脚本的周期性自动执行。此外,还包含基于日志的企业微信错误报警集成方案,确保自动化流程的稳定运行。
本文详细介绍Python中YAML文件的读写方法,对比PyYAML与ruamel.yaml模块的使用场景。涵盖YAML基础语法、数据类型、文件规则,以及load、dump等核心函数的具体操作与代码示例,帮助开发者高效处理YAML数据。
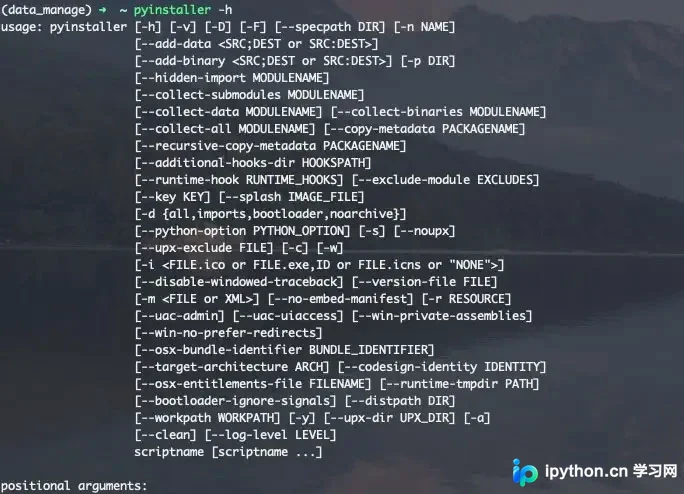
本文详细介绍如何使用 PyInstaller 将 Python 脚本打包为独立的可执行文件,无需目标机器安装 Python 环境。文章涵盖安装步骤、常用命令参数(如 -F 和 -D)的区别,以及生成文件结构的解析。特别强调 PyInstaller 非交叉编译特性,需在同一操作系统下进行打包操作。
本文详细介绍pandas库中DataFrame.set_index方法的具体使用。涵盖key、drop、append、inplace及verify_integrity等核心参数的含义与配置,通过实例演示如何指定单列或多列作为索引,以及如何构建多级索引和原地修改数据框,帮助开发者高效处理数据索引。
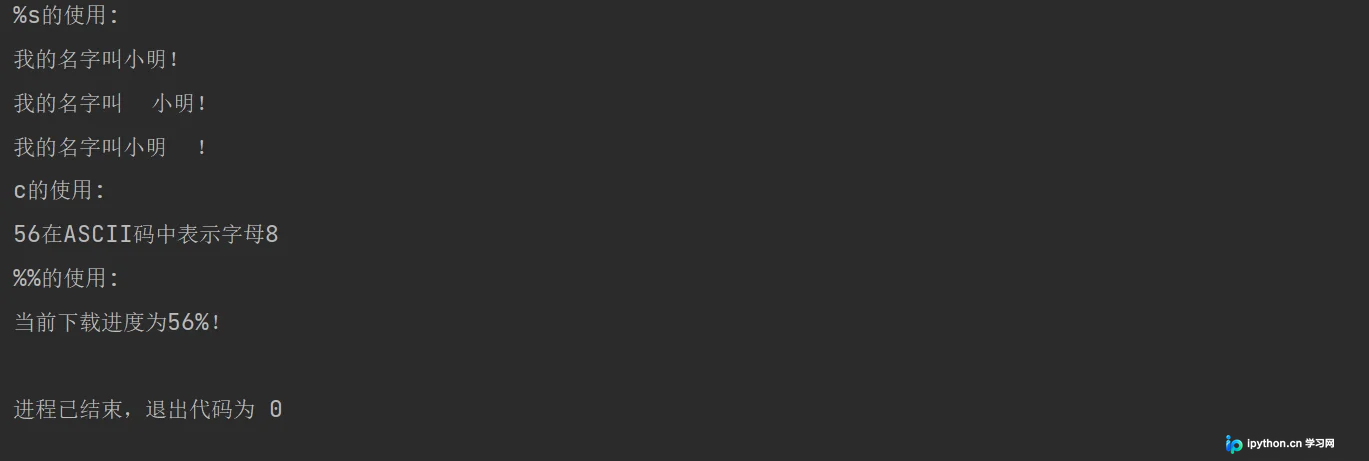
本文详细介绍Python中两种主要的字符串格式化方式:传统的%占位符和更灵活的format方法。内容涵盖%占位符对整数、浮点数、字符及特殊符号的处理,包括对齐方式、精度控制及进制前缀显示;同时解析format方法的三种用法:无位置指定、命名参数及索引指定,帮助开发者掌握高效、规范的字符串输出技巧。
本文详细介绍pandas中DataFrame.fillna()函数的具体用法。涵盖value、method、axis、inplace及limit等核心参数的配置,通过标量、字典填充及ffill/bfill前后向填充的实例,演示如何处理数据中的NaN值,帮助开发者高效完成数据清洗任务。
本文详解Python中try...except的嵌套使用机制。通过示例展示raise抛出异常后代码执行流程,以及外层try如何捕获内层异常。同时介绍自定义异常类的继承方式,并对比Exception万能捕获、traceback模块和sys模块三种异常查看方法,帮助开发者掌握Python异常处理的核心技巧。
本文介绍pandas中round方法的使用,包括如何对数据框进行四舍五入保留指定小数位数。通过传入整数统一所有列精度,或传入字典对指定列分别设置精度,实现灵活的数据处理。
本文详细介绍Python pandas中处理缺失值的三种核心方法:删除含缺失值的样本或特征列,以及使用具体数值或前后值进行填充。通过dropna、drop和fillna函数的参数详解与代码示例,帮助开发者快速掌握数据清洗技巧。
本文详细介绍Python内置time标准库的核心功能,涵盖时间戳获取、本地时间解析、自定义时间格式字符串转换(strftime/strptime)、程序休眠及高精度性能计时方法。通过具体代码示例解析各函数返回值类型与应用场景,帮助开发者高效处理时间相关逻辑。