

Python默认参数调用机制与可变对象陷阱解析
本文深入解析Python中默认参数的调用方式,通过示例展示三种常见调用形式。重点阐述默认值仅在函数定义时赋值一次的机制,特别是当默认参数为列表等可变对象时可能引发的累积错误。文章提供了使用None作为默认值的标准解决方案,帮助开发者避免潜在bug,提升代码健壮性。
2026-10-13
8

本文深入解析Python中默认参数的调用方式,通过示例展示三种常见调用形式。重点阐述默认值仅在函数定义时赋值一次的机制,特别是当默认参数为列表等可变对象时可能引发的累积错误。文章提供了使用None作为默认值的标准解决方案,帮助开发者避免潜在bug,提升代码健壮性。
本文深入解析Python中字典、列表等可变对象的赋值、浅拷贝与深拷贝机制,通过内存地址变化直观展示区别。同时对比了字典的两种常见循环方式,指出直接遍历Key与items()方法的性能差异,为大数据量场景下的代码优化提供实践建议。
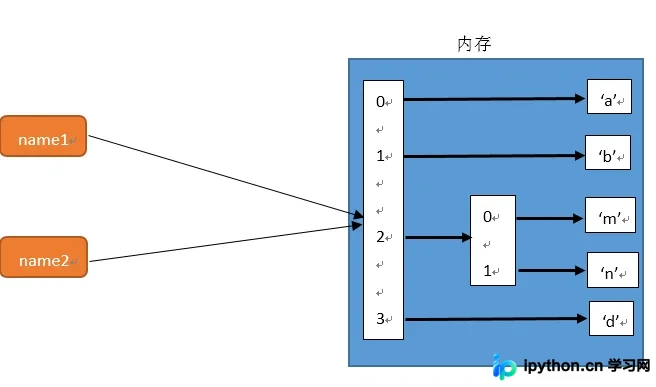
本文详细解析TensorFlow中卷积操作的梯度反向传播机制,涵盖Valid和Same两种填充模式。通过具体示例展示如何对未知输入张量和未知卷积核分别求导,并介绍tf.nn.conv2d_backprop_input与tf.nn.conv2d_backprop_filter函数的使用方法及代码实现,帮助开发者深入理解卷积层训练过程中的梯度计算逻辑。
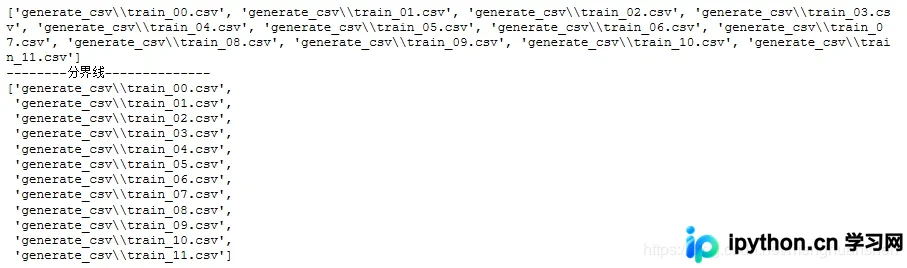
本文对比Python中print()与pprint()模块的输出差异。pprint(Data pretty printer)专为复杂长数据结构设计,通过分行缩进提升可读性。文章提供代码示例展示两者在列表打印时的不同表现,并介绍pprint模块的pformat、isreadable等扩展方法,帮助开发者优化调试体验。
本文深入解析Python函数的定义与调用过程。重点阐述函数调用时局部符号表的创建机制、变量查找顺序(局部-嵌套-全局-内置)以及实参的传值调用特性。同时澄清无return语句的函数默认返回None的概念,并通过fib数列示例展示函数别名赋值及实际执行效果,帮助开发者理解Python函数底层工作原理。
本文介绍如何利用Python的Selenium库定位网页元素,结合Pillow库对动态生成的验证码图片进行截图和精准裁剪,并通过调用图鉴等第三方商业接口实现自动化识别。该方法适用于解决Web端图片验证码登录或注册场景,包含完整的代码实现与错误处理建议。
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。
本文详细介绍在Windows系统中使用Python调用打印机打印文件的几种主流方法。包括通过os.system执行print命令、利用win32api和win32print库直接控制打印机、使用Selenium结合win32gui模拟浏览器打印操作,以及借助Ghostscript静默打印PDF文件的完整代码示例与参数解析。
本文详细解析Python中random模块的核心函数,包括从序列中随机选取元素的choice、指定范围内按步长选取的randrange、生成[0,1)浮点数的random、打乱列表顺序的shuffle以及生成指定范围实数的uniform。通过具体代码实例展示各函数的参数设置与返回值特征,帮助开发者快速掌握Python随机数生成的标准用法。
本文详解Python中访问字符串值的三种核心方法:通过索引下标获取指定字符、利用[start:stop:step]语法进行切片截取,以及使用for循环遍历字符串。内容涵盖索引规则、切片参数含义及负数步长处理,并附带完整代码示例,帮助开发者快速掌握字符串操作技巧。
本文详解Python模块的定义与核心优势,包括提升代码可维护性、复用性及避免命名冲突。通过nnlog模块实现便捷的日志记录,涵盖参数配置与级别调用;同时解析urllib.parse模块在URL分段、拼接及编码解码中的具体应用,助力开发者高效处理网络资源。
本文分析Tensorflow训练过程中因重复加载图结构导致速度变慢的原因,并提供两种解决方案:将模型结构载入全局或置于会话外部。通过对比测试数据,展示优化后训练时间的均衡性,帮助开发者避免图爆炸问题,提升训练效率。