Flask异常捕获:abort与errorhandler的使用及调试模式
本文详解Flask框架中的异常捕获机制,重点介绍abort方法抛出指定HTTP状态码及errorhandler装饰器注册自定义错误处理函数的用法。同时阐述开启调试模式(debug=True)在开发阶段显示详细错误信息的重要性,以提升用户体验并简化常见错误的反馈处理。
2026-10-16
15

本文详解Flask框架中的异常捕获机制,重点介绍abort方法抛出指定HTTP状态码及errorhandler装饰器注册自定义错误处理函数的用法。同时阐述开启调试模式(debug=True)在开发阶段显示详细错误信息的重要性,以提升用户体验并简化常见错误的反馈处理。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详细解析Python中try-except结构内pass语句的三种核心用法:在for循环中跳过单次错误执行、忽略异常继续后续代码以及中断整个循环流程。通过对比continue与pass的行为差异,结合socket绑定示例说明异常传播机制,帮助开发者掌握异常处理中的流程控制技巧。
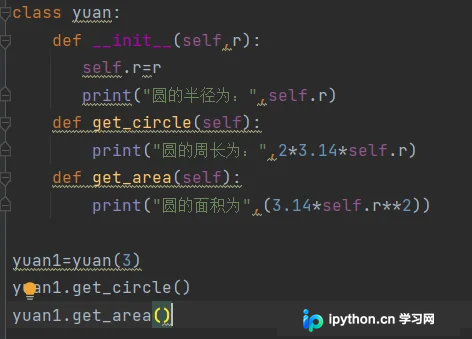
本文介绍如何使用Python编写程序,通过输入圆的半径来计算其周长和面积。文章提供了两种实现方式:一种是基于基础数学库math的直接计算,另一种是面向对象的方法。通过具体代码示例和运行结果展示,帮助读者理解Python在几何计算中的应用。
本文详细介绍如何使用Python的Paramiko库建立SSH连接,远程执行服务器脚本并获取实时输出结果。涵盖密码与密钥两种认证方式、批量操作、文件传输及封装类实现,提供完整代码示例与注意事项。
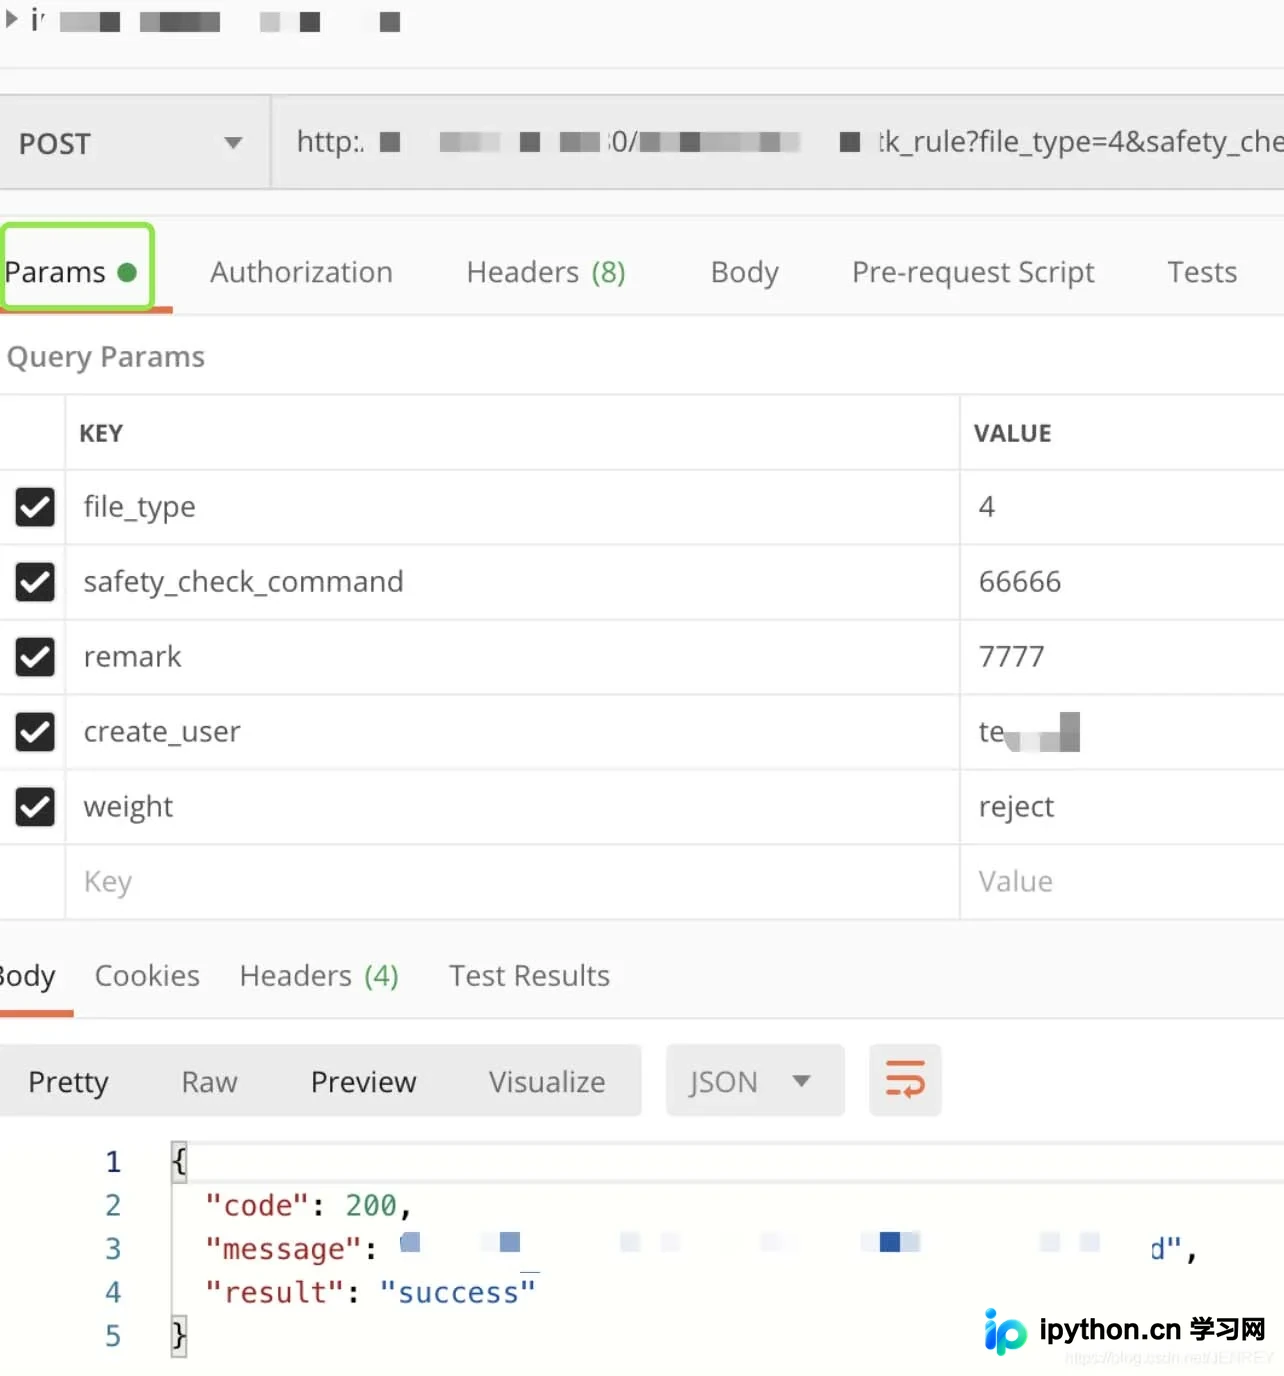
本文总结 Flask 接收前端 POST 请求参数的三种主要方式:通过 URL 参数(params)、带附件的 form-data 以及 JSON 格式数据。文章提供了基于 request 模块的具体代码示例,解析了如何提取文件、表单字段及 JSON 对象,并指出前端使用 Express+pm2 时不带附件可能存在的兼容性问题,帮助开发者快速实现后端数据接收。
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
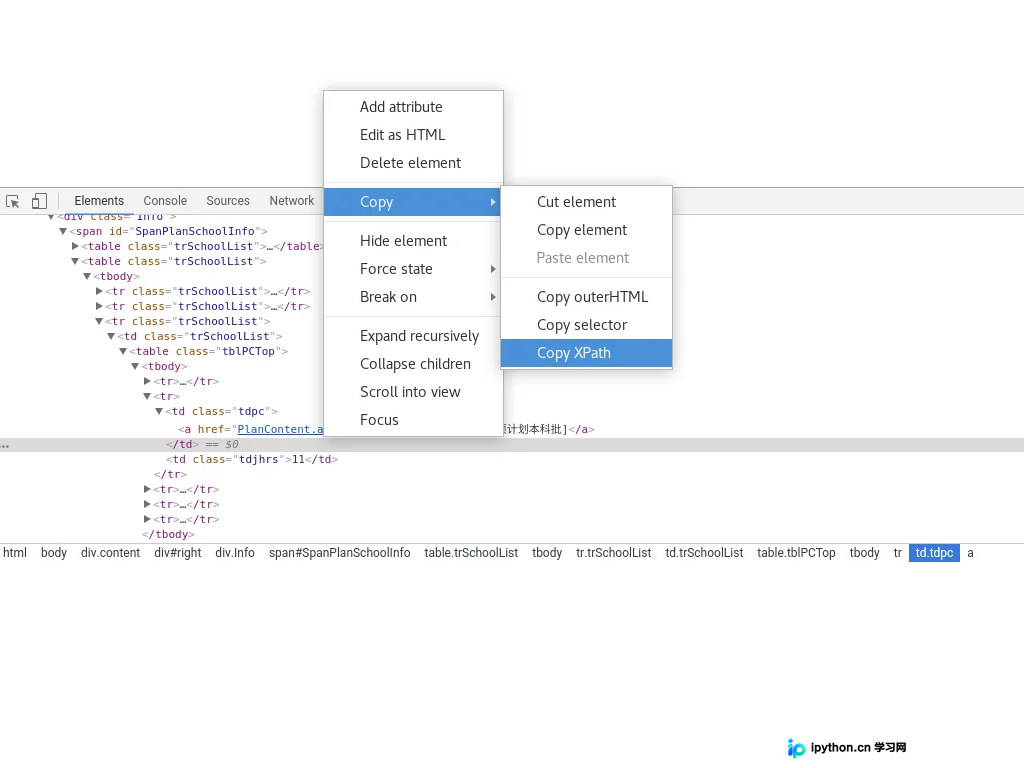
本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。
本文深入解析Python函数参数体系,涵盖形参与实参的定义与区别,详细阐述不可变与可变类型在参数传递中的行为差异。重点讲解位置实参与关键字实参的传值规则、形参的六种分类及声明顺序,并深入剖析*与**打散机制在处理单列与双列容器时的具体应用。
本文深入解析Python装饰器的底层原理,说明其本质为高阶函数的嵌套调用。重点探讨使用装饰器后函数元数据(如名称、文档)丢失的问题,并演示如何利用functools模块中的@wraps装饰器保留原始函数信息,确保代码的可维护性与规范性。
本文深入解析Python中五种常见的爬虫框架,包括成熟的Scrapy、高效的Crawley、可视化的Portia、轻量级的Newspaper以及文章提取工具Python-goose。详细对比各框架的功能特点、适用场景及技术优势,帮助开发者根据需求选择合适的爬虫解决方案。
本文深入解析OpenCV中Filter2D函数的边界填充机制。通过C++与Python实例验证,指出该函数并非采用补零或简单边缘扩展,而是使用沿边缘镜像填充。文章详细说明了anchor参数对计算结果的影响,帮助开发者准确理解卷积运算中的边界处理逻辑。