

Python中判断字符串或集合是否为空的正确方式
本文介绍Python中判断字符串、列表、元组及字典是否为空的推荐方法。依据《Effective Python》建议,应避免使用len()检查长度,而应利用空值隐式转换为False的特性,直接使用not关键字进行判断,代码更简洁且符合Pythonic风格。
2026-10-14
7

本文介绍Python中判断字符串、列表、元组及字典是否为空的推荐方法。依据《Effective Python》建议,应避免使用len()检查长度,而应利用空值隐式转换为False的特性,直接使用not关键字进行判断,代码更简洁且符合Pythonic风格。
Python标准json库默认解析重复Key时会覆盖旧值,导致数据丢失。本文介绍通过json.loads的object_pairs_hook参数,自定义回调函数将相同Key的值聚合成数组,从而完整保留所有键值对信息。
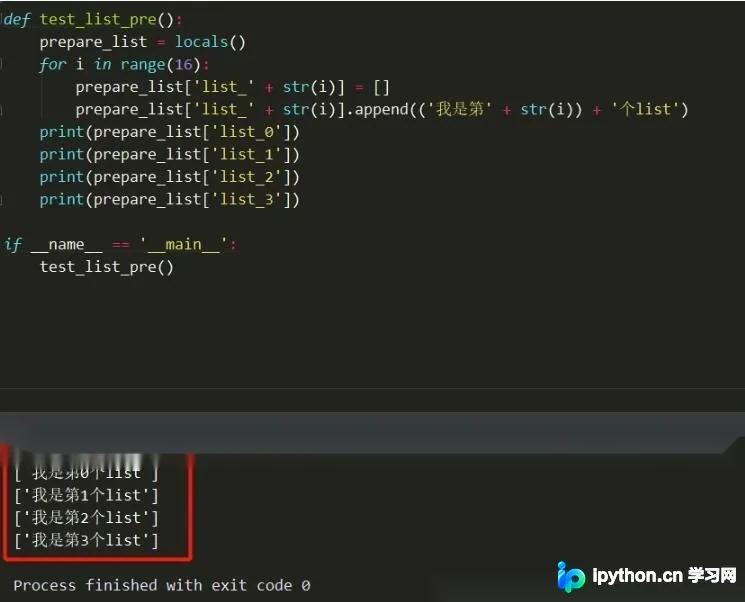
本文介绍在Python中动态生成变量名及反向获取变量名的两种实用方法。通过locals()函数结合字典操作,可实现批量创建命名列表;利用inspect库的currentframe机制,可反向追踪变量对应的字符串名称。适用于需要灵活处理大量动态对象的场景,代码示例清晰,便于直接复用。
本文介绍Python中利用string模块的Template类进行字符串格式化的方法。通过导入Template类并实例化,可以使用substitute方法替换占位符。默认定界符为$,也可通过继承Template类并重写delimiter属性来自定义定界符,实现更灵活的字符串替换操作。
本文深入解析Python中列表和字典直接赋值的浅拷贝机制及其潜在风险。通过对比直接赋值与使用copy.deepcopy进行深拷贝的行为差异,展示修改原变量时对新变量的影响。文章提供具体的字典和列表实验代码,帮助开发者避免在LeetCode等编程场景中因引用同一内存地址而导致的逻辑错误,确保数据独立性。
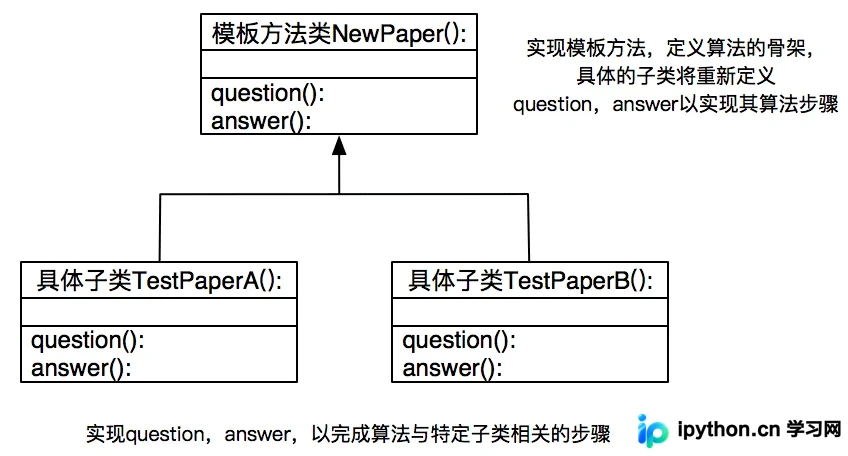
本文深入解析Python中的模板方法模式,通过试卷生成示例展示如何定义算法骨架并将具体步骤延迟至子类。该模式有效解决了不变行为在子类中重复出现的问题,帮助开发者实现代码复用与结构优化,适用于需要固定流程但部分步骤可变的场景。
在使用nohup后台启动Python脚本时,常因Python输出缓冲机制导致日志文件nohup.out无法实时显示内容。本文介绍通过添加-u参数禁用缓冲,确保日志即时写入,解决log不刷新的问题。
本文介绍Python中查找最小K个数的两种解法。解法1利用Partition函数,平均时间复杂度为O(N),但会改变原数组顺序。解法2采用最大堆维护K个元素,时间复杂度为N*O(logK),适合处理海量数据且保持原数组不变。通过代码示例对比了两种方法的运行时间与内存占用,解法2在性能上更优。
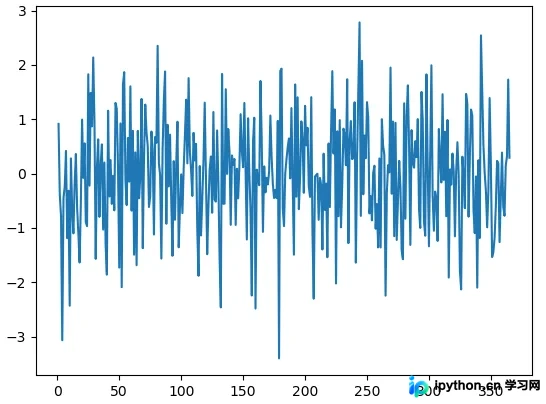
本文详细介绍Python中pandas库的安装方法及核心数据结构。通过pip命令快速安装pandas后,深入解析Series和DataFrame两种主要数据对象的创建方式。内容涵盖从列表、字典生成Series,利用Matplotlib进行可视化,以及DataFrame的行列索引、数据读取与切片操作,帮助初学者掌握数据处理基础。
本文详细讲解如何利用Django提供的ModelForm功能实现数据的增删改操作。通过创建继承ModelForm的表单类,自动绑定模型字段,简化视图逻辑。教程涵盖模型定义、迁移生成、表单配置、视图函数编写及URL路由设置,帮助开发者快速掌握基于模型的表单处理核心方法。
本文详细介绍如何在Appium+Python自动化测试中生成直观的HTML测试报告。通过引入HTMLTestRunner_PY3库,替代默认的文本格式报告,实现包含时间戳、测试套件管理及详细执行结果的可视化展示。文章涵盖库文件配置、代码示例解析及verbosity参数设置,帮助开发者快速掌握测试报告的高级应用。
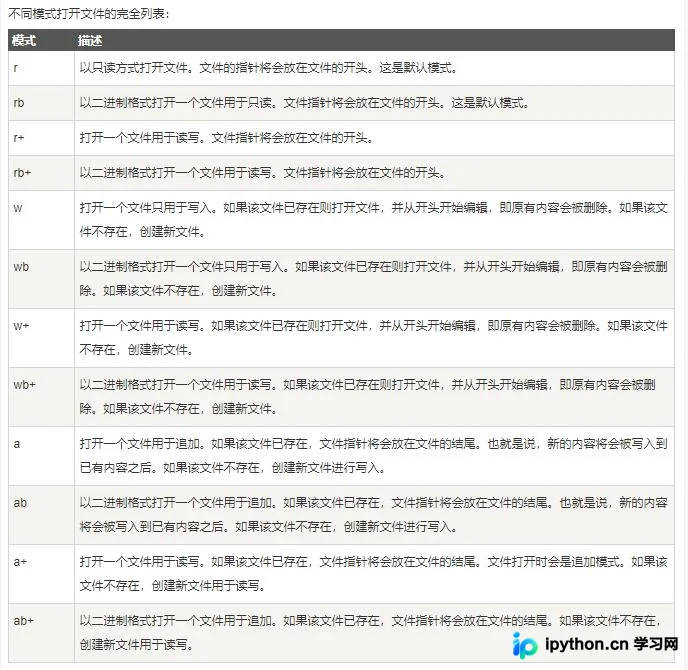
本文详细解析Python中文件指定行的读写操作。首先介绍open函数的多种打开模式(如w, r+, rb等)及文件对象常用方法(read, write, seek, truncate等)。随后通过三种具体代码示例,演示如何读取、修改并写回指定行内容,包括列表插入、字符串拼接及文件写入的完整流程,帮助开发者掌握灵活的文件处理技巧。