Python实现静态Web服务器:HTTP协议解析与代码实战
本文深入解析HTTP协议的工作机制,详细拆解GET与POST请求及响应的Header与Body结构,并结合Python Socket编程实现一个完整的静态Web服务器。通过代码示例展示如何解析HTTP请求、处理文件资源返回及错误处理,帮助开发者理解Web服务底层原理。
2026-10-14
7

本文深入解析HTTP协议的工作机制,详细拆解GET与POST请求及响应的Header与Body结构,并结合Python Socket编程实现一个完整的静态Web服务器。通过代码示例展示如何解析HTTP请求、处理文件资源返回及错误处理,帮助开发者理解Web服务底层原理。
本文详解如何使用Python抓取猫眼电影TOP100榜单及电影天堂数据,涵盖静态页面分析、正则表达式提取、User-Agent随机切换及编码处理技巧。重点演示将爬取数据持久化存储至本地CSV文件、MySQL数据库(使用pymysql及executemany批量插入)及MongoDB的具体实现,并提供完整的代码框架与SQL查询示例。
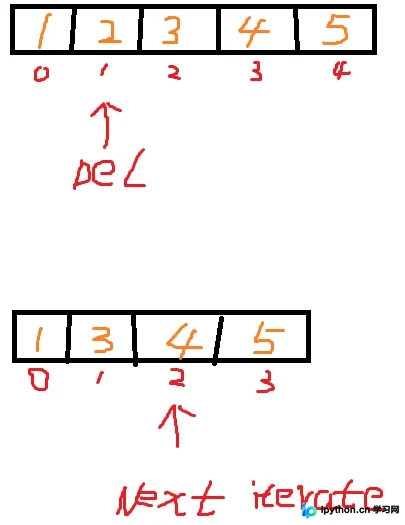
本文分析Python在遍历list时直接删除元素导致的IndexError及漏删问题,深入解释索引偏移原理。提供三种正确做法:使用while循环手动调整索引、倒序遍历避免索引冲突,以及遍历副本操作原列表,并对比各方案优劣。
本文介绍Python3中字典的基本操作,重点演示如何使用sorted()函数对字典的Key进行排序输出。同时涵盖字典的添加、修改(通过赋值实现)及删除(使用del语句)方法,并通过IDLE交互环境中的具体代码示例展示数据变化过程。
针对系统自带复制功能处理2000G海量数据耗时过长的问题,本文提供基于Python 2.7的两种自定义脚本方案。CopyFiles1实现目录结构的完整镜像复制,保持文件层级美观;CopyFiles2则支持按格式筛选文件并扁平化存放至目标目录,虽结构混乱但速度极快。通过对比两种方法,帮助用户根据实际需求选择高效的批量复制策略。
本文介绍如何在Python中利用内置的sqlite3模块连接和操作SQLite数据库。通过具体代码示例,演示了如何创建数据库连接、建立数据表、插入单条及多条记录,以及执行查询并获取结果。SQLite作为嵌入式数据库,无需独立进程,直接通过API调用即可实现高效的数据管理。
本文介绍如何使用Python的requests库递归下载网站根目录下的所有文件及文件夹。针对PHP下载限制,通过二级域名站实现自动化备份。代码包含判断链接类型、自动创建文件夹及递归处理逻辑,帮助开发者快速还原网站本地结构。
本文深入解析Python中paramiko模块的核心用法,涵盖基于密码和公钥密钥两种SSH连接方式。通过具体代码示例,演示如何建立远程连接、执行Linux命令并获取结果,为开发堡垒机等自动化运维工具提供技术基础。
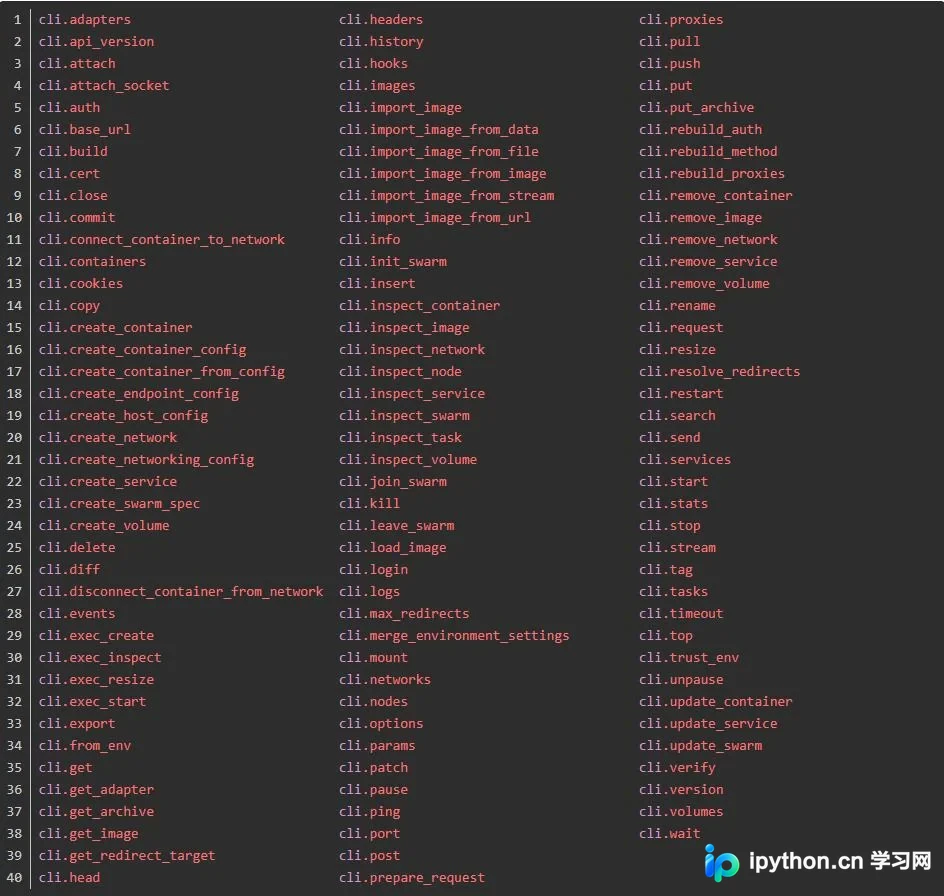
本文介绍如何使用Python的docker-py模块调用Docker API。通过pip安装依赖后,可实例化Client对象,配置base_url、version等参数。文章列举了version、images、containers、info、start/stop及login等常用方法,并推荐利用ipython查看完整方法列表与文档,实现高效的Docker资源管理。
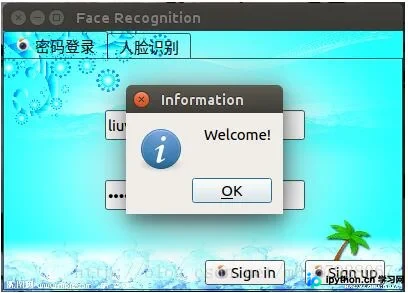
本文介绍如何使用PyQt5、Caffe和OpenCV搭建一个人脸识别登录系统。系统利用OpenCV进行人脸检测,通过微调后的VGG Face网络提取特征,并计算余弦相似度完成身份验证。文章涵盖界面设计、用户注册、密码登录及人脸识别流程,并分析了模型加载耗时、数据存储安全性及实时性等方面的不足与优化建议。
本文详细解析Python中获取屏幕截图的四种常用方法:PIL的ImageGrab模块、Windows API、PyQt以及pyautogui。通过对比各方法的代码复杂度、执行速度及功能特性(如指定窗口、处理遮挡等),帮助开发者根据实际需求选择最高效的截屏方案。
本文详细解析Python中文件处理的三个核心函数:list、read和seek。list用于将文件内容按行转换为列表;read支持指定字符数或全量读取文件内容;seek则用于移动文件指针,支持从文件头、当前位置或末尾进行字节级偏移。文章结合代码示例,帮助开发者掌握文件读写与定位技巧。