解决Python使用openpyxl读写大文件的坑
本文针对Python使用openpyxl处理60MB以上Excel文件时遇到的写入报错及内存占用过高问题,提供了两种核心解决方案:手动释放内存与安装lxml依赖以启用流式处理。同时深入探讨了遍历大范围单元格导致的内存瓶颈,通过限制遍历范围至ZZ5000、切换X64环境及定时重新读取文件等策略,将内存占用控制在2G以内,实现了高效的数据对比与处理。
2026-10-14
7

本文针对Python使用openpyxl处理60MB以上Excel文件时遇到的写入报错及内存占用过高问题,提供了两种核心解决方案:手动释放内存与安装lxml依赖以启用流式处理。同时深入探讨了遍历大范围单元格导致的内存瓶颈,通过限制遍历范围至ZZ5000、切换X64环境及定时重新读取文件等策略,将内存占用控制在2G以内,实现了高效的数据对比与处理。

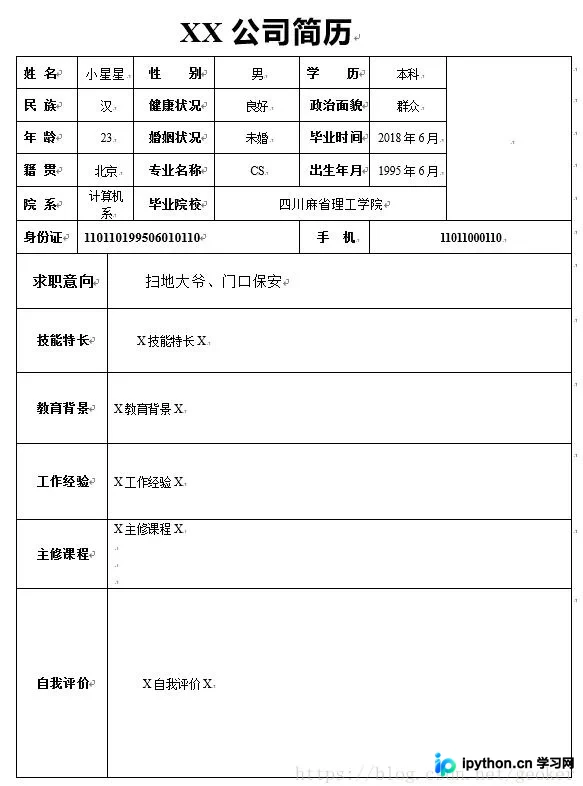
本文介绍如何利用Python自动处理大量Word表格简历。通过解析docx文件内部的zip结构和document.xml,结合正则表达式提取姓名、学历等关键字段,并批量写入txt或Excel文件。文章提供完整代码示例及常见权限错误解决方案,帮助开发者高效完成数据整理任务。
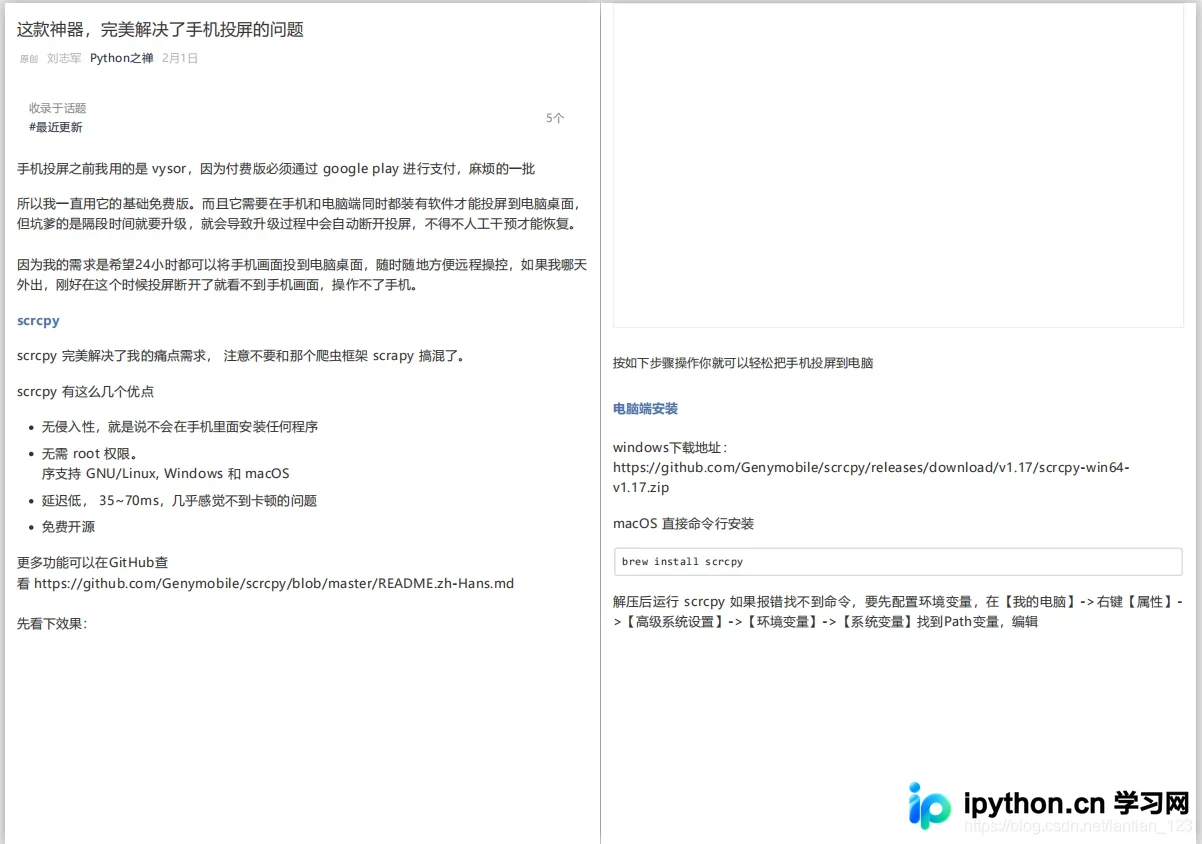
本文介绍如何使用Python库Pyppeteer将网页批量转换为PDF文件。通过对比截图与PDF导出功能,重点解析微信公众号文章因懒加载导致图片丢失的问题,并提供通过JavaScript模拟滚动页面以触发图片加载的完整解决方案与代码示例。
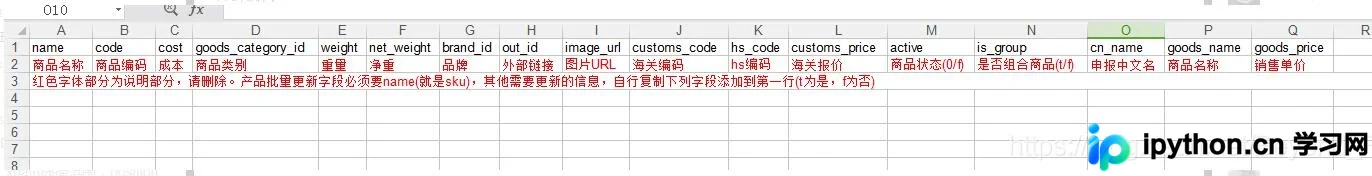
本文介绍如何使用Python的xlwt库写入Excel文件,包括设置字体颜色、合并单元格及写入数据的具体步骤。同时补充了使用xlsxwriter和python-docx库实现富文本颜色和样式的控制方法,提供相关代码示例与参数说明。
本文详细介绍如何在Django框架中实现基于Session的用户登录功能,并演示如何从Session中读取用户数据。通过具体的views.py代码示例,展示登录视图的逻辑处理、首页渲染以及模板中获取Session值的方法,帮助开发者快速掌握Django Session的核心用法。
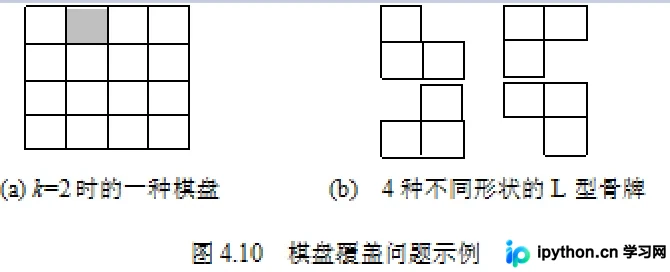
本文介绍如何使用Python和分治算法解决棋盘覆盖问题,并通过numpy和matplotlib实现可视化。文章详细讲解了将2^k×2^k棋盘划分为四个子棋盘,利用L型骨牌处理特殊方格的递归策略,并提供了完整的面向对象代码实现及效果展示。
本文介绍如何使用Python openpyxl库筛选Excel中符合条件的列并处理合并单元格。通过正则表达式解析单元格范围,利用column_index_from_string判断列索引是否大于15以决定是否保留,并将筛选后的单元格在新表单中重新合并。
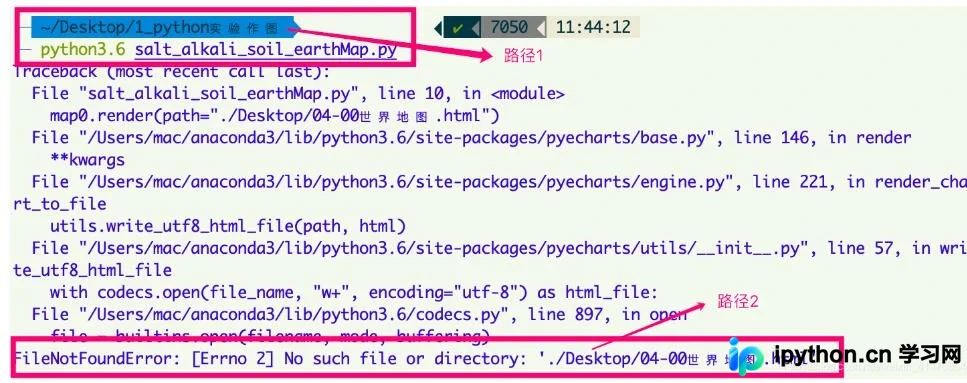
本文详细解析在Python中运行.py文件时常见的路径错误原因。通过对比执行路径与代码内路径的差异,指出相对路径解析失败的问题,并提供修正路径字符串的具体方法。同时介绍了通过修改sys.path来动态添加工程根目录及子目录,从而确保脚本能正确加载所需资源文件的完整解决方案。
本文介绍Python读取含中文文件路径时常见的编码错误及两种解决方案:拆分路径单独编码和对完整路径使用Unicode格式。此外,还记录了在使用pywin32将Word文档转换为Docx时遇到的RPC服务器不可用报错,通过os.path.abspath获取绝对路径成功解决该问题。
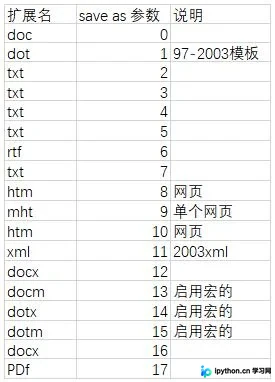
本文介绍如何利用Python的win32com库实现Word文档格式的相互转换。通过调用Microsoft Word应用程序接口,演示了单个doc与docx文件的互转方法,包括关键SaveAs参数说明。此外,提供了递归遍历文件夹并批量将.doc转换为.docx的完整源码,适用于需要处理大量历史文档的场景。
本文详解NumPy中sum函数的axis与keepdim参数。axis指定求和维度,keepdim控制输出维度是否保留。通过三维数组示例说明axis对不同层级的影响,并结合代码展示keepdim=True如何保持结果维度与原始数组一致,帮助开发者精准控制数组计算结果。
本文介绍在PyCharm中安装python-docx后无法导入模块的常见原因及解决方案。主要问题在于PyCharm解释器与系统Python环境不一致。通过PyCharm内置的包管理工具重新安装或配置项目解释器路径,可解决“找不到模块”及下载失败的问题,确保代码正常运行。