

Python中用Memcached减少数据库查询次数的实战指南
针对Web应用因高频数据库查询导致的响应缓慢问题,本文演示如何通过内存缓存策略拦截冗余读取。详细记录了Memcached服务配置步骤,以及在Python项目中基于SQL哈希键实现“先查缓存、未命中回源查库并定时失效”的核心代码。实测表明该方法可将首屏生成时间从0.2秒降至0.006秒左右,有效解除磁盘I/O瓶颈。
2026-10-12
23

针对Web应用因高频数据库查询导致的响应缓慢问题,本文演示如何通过内存缓存策略拦截冗余读取。详细记录了Memcached服务配置步骤,以及在Python项目中基于SQL哈希键实现“先查缓存、未命中回源查库并定时失效”的核心代码。实测表明该方法可将首屏生成时间从0.2秒降至0.006秒左右,有效解除磁盘I/O瓶颈。
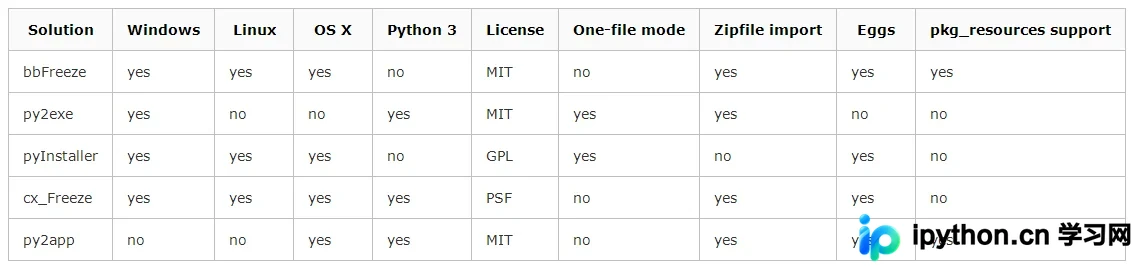
本文详细解析了将Python脚本打包为可执行文件的过程。重点介绍了使用PyInstaller工具进行打包的方法,包括安装、常用命令参数(如-F单文件模式、-d调试模式)以及.spec文件的生成与使用。同时对比了.py、.pyc与可执行文件的发布差异,强调了打包后文件的平台依赖性及自我包含特性。
本文提供基于Python标准库开发的轻量级TCP文件传输服务器与客户端方案。服务端利用SocketServer实现多线程并发处理,内置姓名与密码校验逻辑,并通过分块读取与EOF标志确保文件稳定传输;客户端负责交互式认证、进度等待及本地文件落盘。适用于局域网内快速部署测试或学习网络通信基础原理。
在Windows环境下使用Python读取并打印zip压缩包内的文件名时,常因系统控制台默认编码(如cp936)与压缩包内部编码不一致,导致终端输出中文乱码。本文提供显式解码转换的核心方法与标准代码模板,通过明确指定原始编码流,确保文件名遍历输出的准确性。
本文系统梳理 Python 处理文本的核心方案,涵盖字符串不可变特性、高效分片技巧、文件读取策略,以及 string 常量与 re 模块的正则基础。通过清晰示例演示如何快速完成字符提取、格式转换、内存模拟写入及模式匹配,辅助开发者建立规范的文本处理流程。
本文汇总了Python处理文本与文件系统时的核心工具函数。内容涵盖集合成员关系判定、字符串过滤与固定缩进调整、占位符替换、安全文件读写、自定义规则目录扫描及压缩包信息提取。所有示例均已适配Python 3环境,附带关键参数说明与运行状态提示,可直接嵌入日常数据清洗与自动化脚本中。
在Python中处理字符串匹配时,避免手动遍历能显著提升代码可读性与执行效率。本文详解如何利用in关键字快速判断子串存在性,并演示如何通过列表推导式批量提取多个目标子串及其首次出现位置,提供生产环境可直接复用的简洁方案。
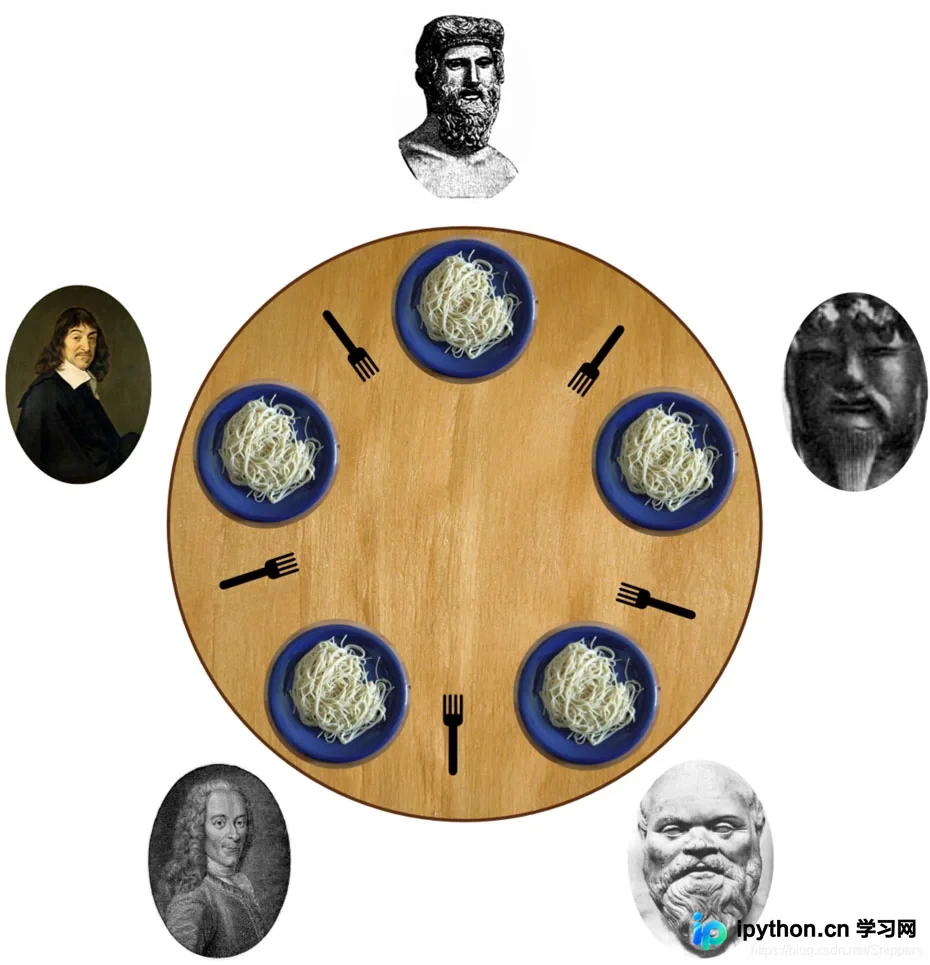
本文介绍如何使用Python多线程解决经典的哲学家就餐问题。通过定义CountDownLatch和DiningPhilosophers类,利用Lock实现叉子资源的互斥访问,并采用非阻塞获取策略避免死锁。代码完整展示了哲学家思考、拿取、进食及释放叉子的全过程,并输出符合格式的行为记录列表。
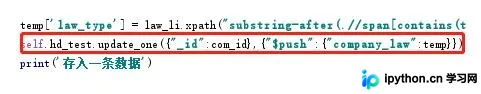
本文介绍如何使用 Python 的 pymongo 库向 MongoDB 文档中的数组类型字段追加新数据。重点讲解 $push 操作符的用法,包括向现有数组添加元素、使用 $each 批量添加以及使用 $slice 限制数组大小。同时对比 $addToSet 避免重复值,并提供完整的代码示例和注意事项。
本文详细介绍Python内置random模块的核心功能,涵盖生成指定范围浮点数与整数、随机选取列表元素以及原地打乱序列等操作。通过完整的代码示例与运行结果对照,帮助开发者快速掌握随机数生成的标准写法与注意事项,适用于数据分析初始化、游戏逻辑或日常脚本编写。
Python 模块与包是代码复用的基础单元。本文详解模块文件的组织方式、多种导入语句的语法差异、名称空间的映射机制,以及标准包的目录结构与调用方法,帮助开发者规范工程结构并避免命名冲突。
本文详解如何在Python中实现代码重用与精简。通过函数封装业务逻辑、合理设置参数与返回值,结合模块导入机制规范作用域,最后利用Shebang指令构建独立脚本。掌握这些核心技法可大幅降低重复编码成本,提升程序可读性与维护效率。