

Python字典数据计算技巧:利用zip反转键值对
本文介绍如何在Python字典中执行最小值、最大值及排序等计算。核心方案是利用zip函数将键值对反转为值键对序列。需注意zip生成的是单次消费的迭代器,且当值相同时,键将作为比较依据。文章通过代码示例展示了正确用法及常见参数顺序错误。
2026-10-13
26

本文介绍如何在Python字典中执行最小值、最大值及排序等计算。核心方案是利用zip函数将键值对反转为值键对序列。需注意zip生成的是单次消费的迭代器,且当值相同时,键将作为比较依据。文章通过代码示例展示了正确用法及常见参数顺序错误。
本文介绍如何使用Python标准库heapq模块构建优先级队列。通过元组(-priority, index, item)结构解决同优先级元素排序问题,确保先进先出。代码示例展示Push和Pop操作,并探讨线程安全扩展方案,适合需要高效排序队列的开发者参考。
本文介绍Python中实现字典一键多值映射的两种主要方法。通过collections模块的defaultdict类可自动初始化列表或集合,简化代码;也可使用普通字典配合setdefault()方法手动处理。文章包含具体代码示例,对比两种方式的实现细节与适用场景,帮助开发者高效构建多值字典结构。
本文详细介绍Python中hashlib、hmac和uuid三个内置模块的用法。hashlib支持MD5、SHA系列等不可逆消息摘要算法,可通过加盐增强安全性;hmac基于密钥和内容的加密机制,适用于挑战应答场景;uuid提供五种生成策略(uuid1至uuid5),其中uuid2未实现,其余方法基于时间戳、随机数或散列值确保全局唯一性。
本文介绍如何利用Python内置模块快速搭建临时Web服务器,适用于本地开发与测试场景。通过执行一行命令即可启动服务,支持自定义端口及防火墙设置。文章详细说明了访问方式、目录列表功能以及底层包含的HTTP处理类,无需额外安装即可实现文件共享。
本文整理了20个常用的Python运维库和模块,涵盖系统监控、网络通信、文件处理及自动化部署等领域。重点解析psutil、paramiko、Fabric、Ansible及SaltStack等核心工具的功能特性与适用场景,助力提升运维效率与系统管理能力。
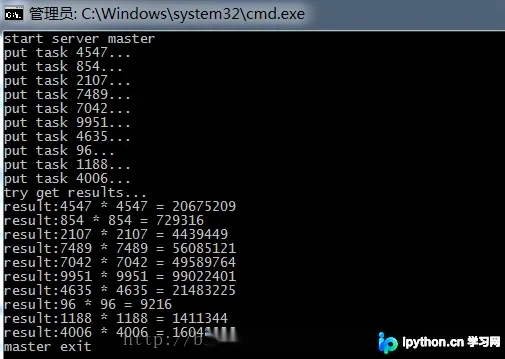
本文介绍利用Python的multiprocessing模块中的managers子模块,实现多进程分布到多台机器上的分布式计算。通过Master服务端暴露Queue,Worker端连接获取任务并返回结果,封装了网络细节,便于编写分布式多进程程序。
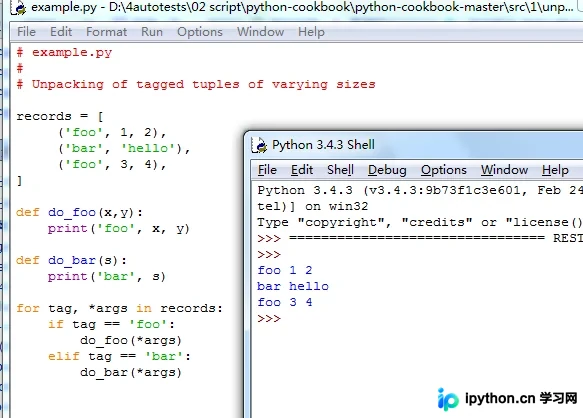
本文介绍Python中从任意长度可迭代对象分解元素的方法。当元素数量超过目标变量时,使用*表达式可避免“分解值过多”异常。通过*修饰变量置于首、尾或中间位置,可灵活提取头部、尾部或中间数据,并支持丢弃不需要的值。
本文深入解析Python字符串的核心特性,包括其不可变性、与C/Java的差异、序列操作支持。详细讲解字符串切片语法、内存管理机制、类型转换(int/float/ord/chr)及常用字符串方法(replace/find/split等)。同时对比介绍%格式化、字典格式化及str.format()三种字符串格式化技术,帮助开发者高效处理文本数据。
本文介绍Python中将序列分解为单独变量的方法。只要对象可迭代,如元组、列表或字符串,即可通过赋值操作分解。核心要求是变量数量必须与序列元素一致。文章通过示例展示了如何处理嵌套序列及丢弃不需要的值,并强调了避免变量名冲突的注意事项。
本文详细介绍Python内置logging模块的多种用法,包括将日志直接输出至屏幕、通过basicConfig函数配置日志格式与级别、同时向多个Handler输出日志以及基于配置文件进行高级设置。内容涵盖StreamHandler、FileHandler、RotatingFileHandler等常见处理器的使用场景,帮助开发者掌握灵活的日志管理方案。
本文详细介绍Python内置ConfigParser模块的使用方法。涵盖从文件读取sections、options及键值对,到动态添加、修改、删除section和option的完整操作流程。通过具体代码示例,展示如何在Python中高效管理配置文件,适用于各类需要外部配置的应用场景。