

Python遍历指定文件夹获取文件列表并写入文件的实现方法
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
2026-10-13
25

本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
本文介绍如何使用Python和numpy库读取文本文件并将其转换为矩阵。详细解析了字符串处理、类型转换及矩阵构造过程,并针对大规模数据场景提供了稀疏矩阵的替代方案与内存优化建议,帮助开发者避免MemoryError。
本文基于 Python 3.6 环境,演示了三种常见的文件操作场景:保持格式复制文件、读取内容并返回列表(适用于加载本地词典库),以及直接读取文件字符串。代码示例展示了如何处理 UTF-8 编码及去除 BOM 字符,为开发者提供实用的文件处理工具模块参考。
本文介绍在CentOS7.3.1611_x64系统Python 2.7.5环境下,如何高效批量替换多个源文件中的指定字符串。提供了两种方案:利用sed与grep组合命令快速处理,以及编写Python脚本实现跨平台(含Windows)的目录遍历替换。
本文详细介绍使用Python解决八皇后问题的回溯算法。通过定义冲突检测函数判断皇后位置是否合法,并利用递归生成所有可能的摆放方案。文章包含完整代码示例及运行结果分析,帮助开发者理解递归调用与状态更新机制,适用于Python数据结构与算法学习。
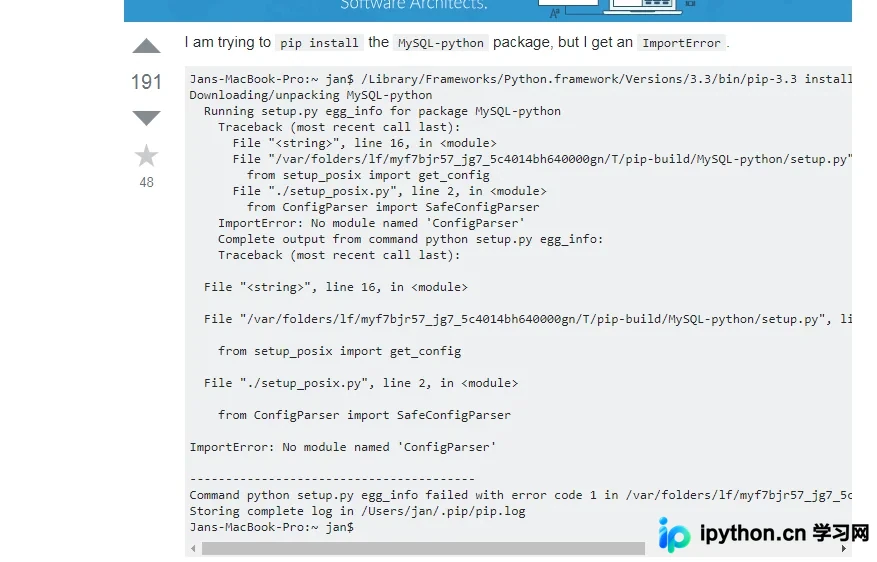
本文解决Django在重装MySQL后启动报错No module named 'MySQLdb'的问题。由于MySQL-python不支持Python3,推荐安装mysqlclient替代。通过pip安装mysqlclient并配置依赖环境,可快速修复模块缺失错误,确保Django正常运行。
本文详细解析Python中raw_input()与input()函数的差异。raw_input()始终返回字符串,需手动转换类型;input()尝试计算输入值,直接返回对应类型(如整数)。文章通过代码示例展示了如何转换为int、list或str,并指出input()处理非数值字符串时的报错机制及向下取整特性。
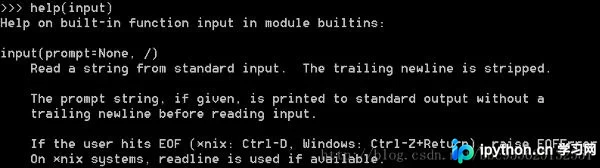
本文详细解析Python3中的input函数,说明其作为内建函数从标准输入读取字符串并忽略换行符的机制。重点对比Python2中input与raw_input的区别,指出Python3整合二者后统一将所有输入视为字符串处理的特性,并介绍类型转换方法。
本文详细介绍如何使用Python编写基于UDP协议的Ping程序。通过服务器端模拟网络丢包环境,结合客户端发送报文并计算往返时间,展示了完整的Socket通信流程。包含服务器与客户端的核心代码实现,适用于网络协议学习与调试参考。
本文介绍如何使用Python3结合urllib库实现百度贴吧指定页面的数据爬取。通过解析URL中pn参数的分页规律,编写脚本批量获取HTML源码,并将结果保存为本地文本文件。教程包含完整的代码示例、URL规则分析及控制台运行效果,适合Python初学者进行网络爬虫入门实践。
本文介绍如何使用Python3结合正则表达式从内涵段子网站抓取内容。通过构造请求获取HTML源码,利用re模块匹配特定标签内的文本,清洗后保存至本地文件。代码包含分页处理、请求头设置及文件写入逻辑,适合初学者理解爬虫基础流程。
本文通过三个经典案例详解Python中的贪心算法应用。首先解决硬币找零问题,通过优先使用大面值硬币实现数量最小化;其次探讨最大子数组和问题,利用动态更新策略寻找连续子数组的最大和;最后分析汽车加油站问题,通过贪心策略计算最少加油次数。每个案例均提供完整Python代码实现及逻辑解析,适合算法初学者参考学习。