

Python标准库collections详解:namedtuple、defaultdict、Counter与deque实战
本文深入解析Python标准库collections中的核心容器类型。通过namedtuple实现可读性更强的元组,利用defaultdict避免KeyError并简化字典操作,借助Counter高效统计元素频次,以及使用deque实现高性能的双端队列操作。涵盖各类型的创建、常用方法及实际应用场景,帮助开发者减少重复代码,提升编程效率。
2026-10-12
13

本文深入解析Python标准库collections中的核心容器类型。通过namedtuple实现可读性更强的元组,利用defaultdict避免KeyError并简化字典操作,借助Counter高效统计元素频次,以及使用deque实现高性能的双端队列操作。涵盖各类型的创建、常用方法及实际应用场景,帮助开发者减少重复代码,提升编程效率。
本文整理了10个Python开发中的实用技巧,涵盖字符串重复打印、生成器使用、变量解包、内存占用检查、列表反转与交换、字符串拼接、嵌套列表扁平化、矩阵转置及集合运算。通过具体代码示例,帮助开发者提升编码效率与代码简洁性。
本文介绍如何使用 Python 的 multiprocessing 库实现简单的远程过程调用 (RPC)。通过 pickle 序列化函数名与参数,利用 Listener 和 Client 建立连接,配合 RPCHandler 和 RPCProxy 类完成远程函数注册与调用。文章同时深入分析了 pickle 的安全风险,并提供了基于 JSON 的替代方案,确保在内部网络环境中安全使用 RPC 服务。
本文深入解析Python中的多进程概念,通过对比单线程顺序执行与多进程并行执行的耗时差异,演示如何使用os.fork()及multiprocessing.Process实现任务并行化。文章涵盖进程创建、父进程与子进程返回值的区别,以及通过join等待子进程完成的具体代码示例,帮助开发者理解如何利用多核CPU提升程序执行效率。
本文介绍如何使用Python的xml.etree.ElementTree库将字典转换为XML格式。通过dict_to_xml函数构建Element对象,利用tostring()生成字节串,并演示如何添加属性。重点讨论了手动拼接字符串与Element对象的区别,强调Element能自动处理特殊字符转义,推荐使用OrderedDict保持顺序,并提供了xml.sax.saxutils进行手动转义的备选方案。
本文详细解析了C++调用Python时出现中文乱码的原因,并提供完整的解决方案。通过设置执行字符集和实现GBK到UTF-8的转换函数,确保中文字符在跨语言调用中正确传递。
本文解析了Python中return不返回值的问题。主要原因为未将返回的值取出来。解决方法是调用函数并将返回值赋给变量,然后输出该变量即可查看函数的返回值。
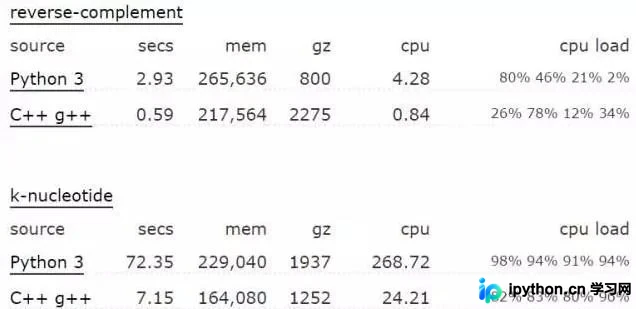
Python侧重编码效率而非运行效率,其动态类型、解释执行、GIL限制及GC机制导致性能瓶颈。本文深入解析Python运行慢的底层原因,并通过对比字典填充时的异常处理与键检查策略,提供具体的性能优化代码示例。
本文深入解析Python标准库collections模块中的四大核心容器:defaultdict解决字典键缺失问题,Counter高效统计元素频次,deque实现线程安全的双端队列,以及namedtuple构建轻量级不可变对象。通过对比原生dict与list的局限,展示各工具类的具体用法、参数配置及性能优势,帮助开发者编写更简洁高效的Python代码。
本文深入解析Python装饰器与递归函数的结合原理。通过自定义memoize装饰器,利用闭包和字典实现递归调用的结果缓存。文章详细拆解了装饰器在函数加载时的预处理过程、递归执行时的参数传递机制,以及通过functools.wraps保持函数元数据的技巧,帮助开发者理解装饰器如何优化递归性能。
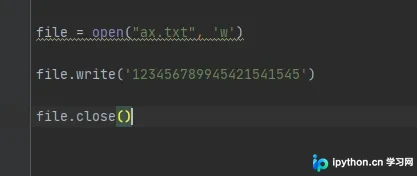
本文详细介绍Python中保存文本文件的标准流程,重点讲解内置open()类、write()函数及close()函数的配合使用。通过具体代码示例,演示如何创建文件、写入字符串数据并正确关闭文件以保存内容,同时涵盖追加模式'a'与普通写入模式'w'的区别及应用场景。
本文深入解析Python中的参数传递机制,详细阐述位置参数与关键字参数的定义、顺序要求及混合使用规则。重点讲解通过单星号'*'收集多余位置参数形成元组,以及双星号'**'收集多余关键字参数形成字典的原理。结合代码示例说明混合调用时的注意事项及常见错误,帮助开发者掌握Python函数参数的灵活用法。
