Python 实现英文单词列表中最长单词链的两种方法
本文介绍如何在 Python 中处理英文单词列表,找出前一个单词尾字母与后一个单词首字母相同的最大长度单词链。通过递归回溯和 NetworkX 图论库两种方案,实现不重复使用单词的最长路径查找,并附带完整代码示例与结果分析。
2026-10-14
8

本文介绍如何在 Python 中处理英文单词列表,找出前一个单词尾字母与后一个单词首字母相同的最大长度单词链。通过递归回溯和 NetworkX 图论库两种方案,实现不重复使用单词的最长路径查找,并附带完整代码示例与结果分析。
本文详细讲解利用pandas库将DataFrame数据导出为CSV、Excel、SQL数据库表及JSON文本文件的四种常用方式。通过具体代码示例,演示了to_csv、to_excel、to_sql及to_json函数的参数配置,包括编码处理、Sheet名指定及数据库连接等关键步骤,帮助开发者快速掌握数据持久化技巧。
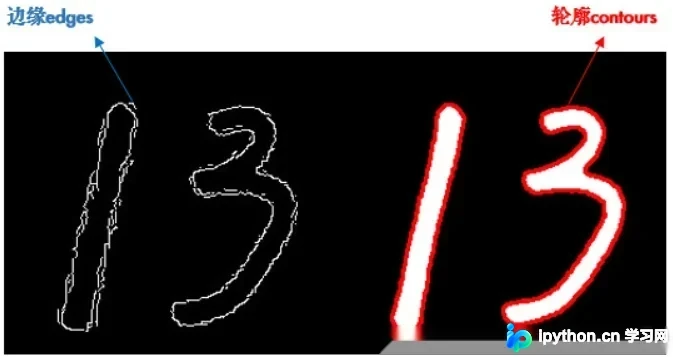
本文详解如何使用Python和OpenCV库查找并绘制图像轮廓。内容涵盖从二值化预处理、使用cv.findContours提取轮廓参数,到利用cv.drawContours进行可视化的完整流程,并包含代码示例与注意事项。
本文深入解析Python中使用remove函数在遍历列表时删除元素的常见陷阱。由于索引前移导致元素被跳过,直接遍历删除往往无法达到预期。文章详细剖析了浅拷贝与深拷贝的区别,并提供了三种有效解决方案:手动构建新列表、使用copy模块的deepcopy方法以及遍历原列表副本,帮助开发者避免此类逻辑错误。
本文介绍如何使用Python绘制逻辑斯蒂映射(Logistic Map)的分叉图,展示混沌现象如何从简单的非线性方程中产生。通过Matplotlib和NumPy库,代码遍历不同参数mu下的迭代结果,直观呈现系统收敛值的分布特征,适合对混沌数学和Python可视化感兴趣的读者参考。
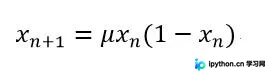
本文详细介绍使用Python和OpenCV实现图像高斯金字塔的方法。通过自定义灰度转换与双线性插值函数,代码展示了从原图生成多级下采样图像的过程。包含完整的Python源码、关键算法解析及可视化输出示例,帮助开发者理解图像金字塔的构建原理与代码实现细节。
本文介绍了一个使用 Python 实现的 IP 存活扫描脚本。该脚本支持从文件读取 IP 或子域名列表,通过多线程并发请求检测目标是否存活,并自动处理协议前缀和去重。脚本包含详细的使用参数说明及完整源代码,适用于安全测试和资产发现场景。
本文详解如何利用Python正则表达式从文本中精准提取版本号。通过解析正则模式r'\d+\.(?:\d+\.)*\d+',结合re模块的findall与group方法,实现从源文件读取并写入目标文件的全流程。文章还深入对比了捕获组与非捕获组的区别,帮助开发者避免常见陷阱,提升文本解析效率。
本文详细介绍Python中字符串遍历的四种常用方式:下标法、for-in循环、enumerate内置函数以及iter内置函数。通过对比分析,指出下标法和enumerate适用于需要访问后续字符的场景(如括号匹配),而for-in和iter更适合直接处理字符。文章强调enumerate在需要索引时比单纯下标法性能更优,并基于Python3.x环境提供具体代码示例与适用场景建议。
本文详解Selenium中driver.close()与driver.quit()的区别,指出close仅关闭当前标签页而quit关闭所有窗口并退出驱动。针对Windows下ChromeDriver进程残留问题,介绍了Java中通过ChromeDriverService管理进程以及Python中使用Service库或os模块强制结束进程的方法,确保测试环境整洁。

本文介绍当Selenium的.text方法无法直接获取Script标签内的JSON数据时,如何结合BeautifulSoup提取源码,并通过json模块将字符串转换为字典对象,从而精准获取嵌套数据。
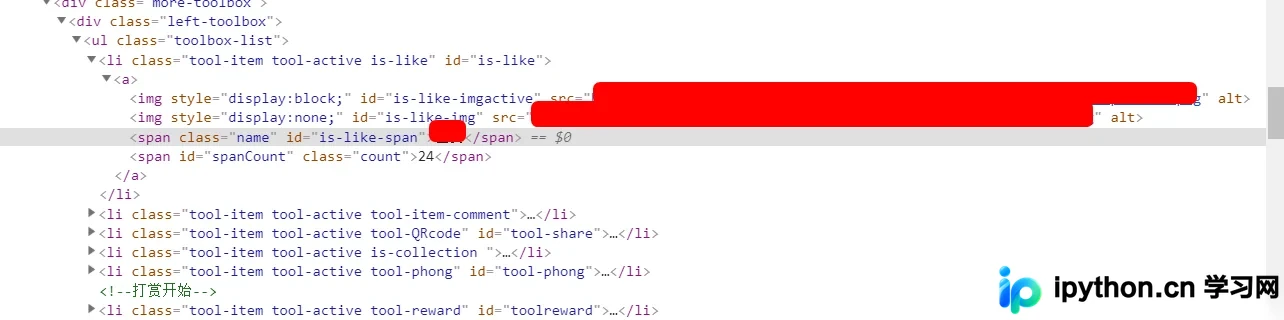
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。