

PyCharm搭建Spark开发环境的实现步骤
本文详细介绍在Windows系统下使用PyCharm搭建Spark开发环境的完整步骤。内容涵盖JDK安装与变量配置、Hadoop及winutils组件部署、Spark环境变量设置,以及Anaconda集成。重点讲解如何在PyCharm中通过Edit Configurations和Project Structure配置SPARK_HOME与PYTHONPATH,并附带测试代码验证环境是否成功运行,解决常见版本兼容警告。
2026-10-13
9

本文详细介绍在Windows系统下使用PyCharm搭建Spark开发环境的完整步骤。内容涵盖JDK安装与变量配置、Hadoop及winutils组件部署、Spark环境变量设置,以及Anaconda集成。重点讲解如何在PyCharm中通过Edit Configurations和Project Structure配置SPARK_HOME与PYTHONPATH,并附带测试代码验证环境是否成功运行,解决常见版本兼容警告。
本文介绍如何在Matplotlib中根据未直接绘制的变量(如B列)动态更改折线图的背景颜色。通过引入计数器列并遍历特定条件,利用axvline为不同状态的时间段添加半透明背景色,实现数据状态与视觉背景的关联展示。
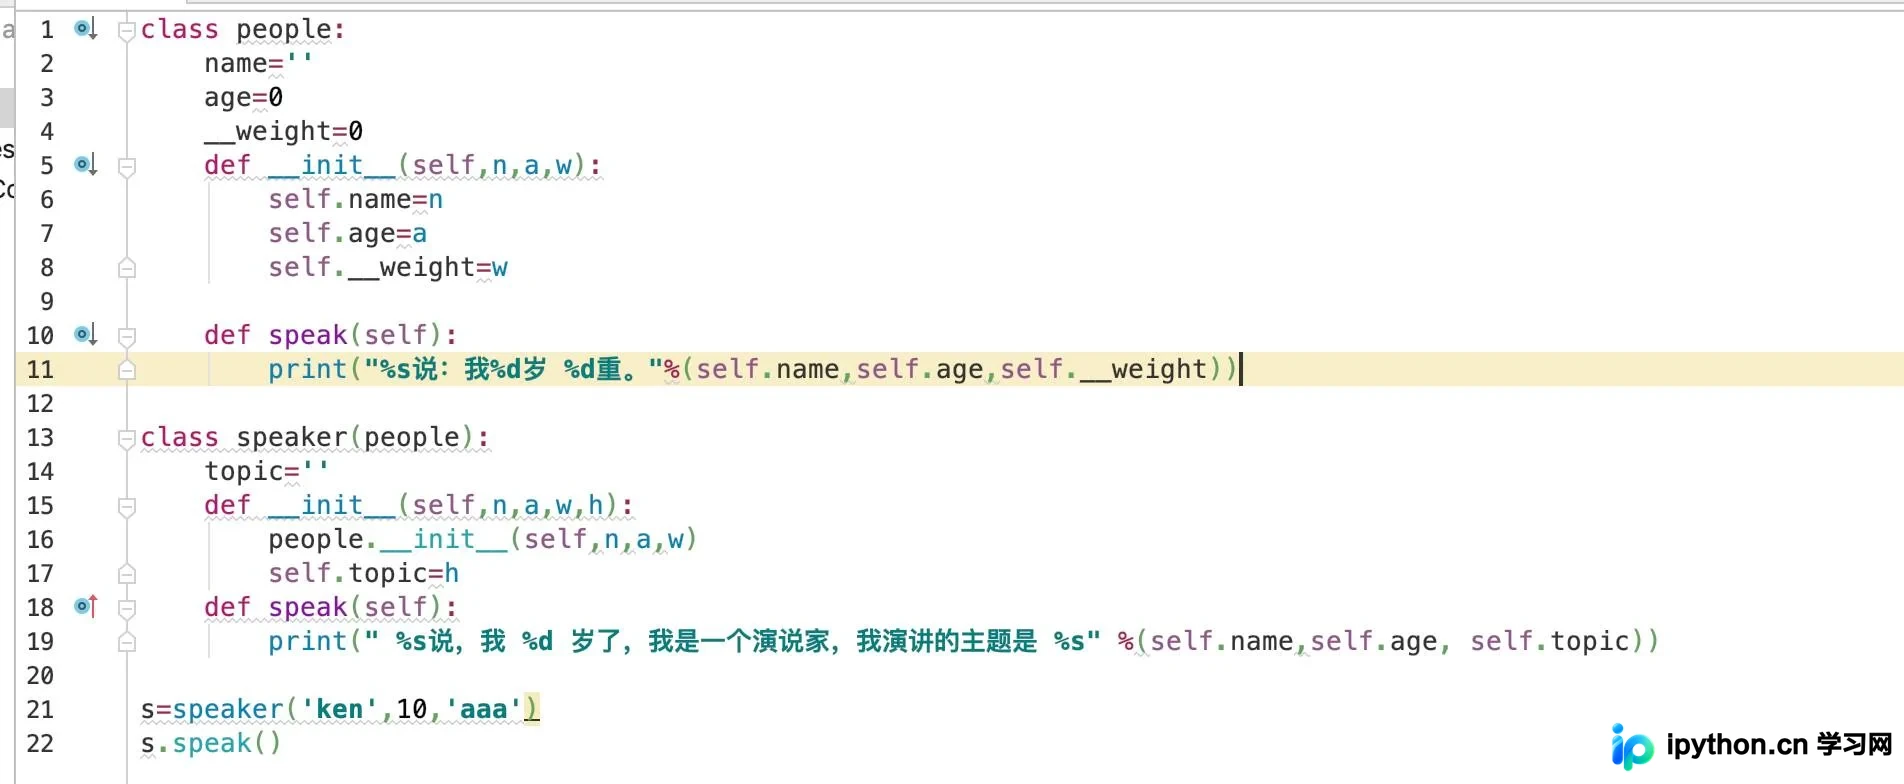
本文解析Python中类实例化时因参数数量不匹配导致的TypeError错误。当类定义包含__init__方法并指定多个参数时,实例化对象必须严格传入对应数量的实参,即使部分参数在逻辑上看似未使用。程序会自动调用__init__进行初始化,参数缺失将直接引发报错。
本文介绍使用Python处理500GB级别大量文件复制的两种方法。CopyFiles1保留目录结构,适合整理归档;CopyFiles2扁平化输出特定格式文件,速度更快但目录混乱。通过对比两种策略的代码实现与性能差异,帮助开发者根据实际需求选择合适的大规模文件复制方案。
本文深入解析Python类中__getitem__和__getattr__两个核心魔术方法的实现原理。__getitem__允许对象像字典一样通过方括号访问属性,而__getattr__则在属性查找失败时触发。文章结合具体代码示例,详细说明了属性取值、赋值及删除时的内部调用顺序与行为差异,帮助开发者理解对象属性访问机制。
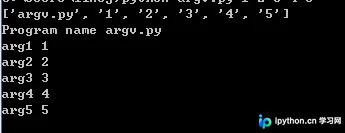
本文介绍如何在 Python 脚本中通过命令行传入参数。核心方法利用 sys 模块获取 sys.argv 列表,其中索引 0 为脚本名,后续索引依次对应传入的参数值。通过遍历列表即可处理多个参数,适用于各类需要外部配置的场景。
本文深入解析Python中的三种核心数据序列化模块:json、pickle和shelve。详细对比它们的数据支持范围、跨语言兼容性以及文件读写模式差异,重点讲解Python 2与3在编码处理上的不同,并提供dumps/loads与dump/load的具体代码示例,帮助开发者根据场景选择最合适的持久化方案。
本文介绍如何使用Python的matplotlib库生成背景透明的图片,并实现图例部分的透明显示效果。通过设置savefig参数transparent=True及调整图例框架属性,可确保导出PNG图片时背景完全透明,适用于需要透明底图的场景。
本文介绍Python中使用多线程分块读取大文件的实现方法。通过继承threading.Thread创建Reader类,结合Partition类划分文件区间,实现高效并发读取。代码包含行对齐处理、线程启动与同步逻辑,适用于需要快速处理大文本文件的场景。
本文详解在Linux服务器环境下使用Python进行K-means算法绘图时,Matplotlib出现中文乱码的解决方案。通过查找字体路径、上传simhei.ttf字体、清除缓存及修改配置文件等步骤,有效解决图表中文显示异常问题,并附带JMeter测试时的UTF-8参数设置建议。
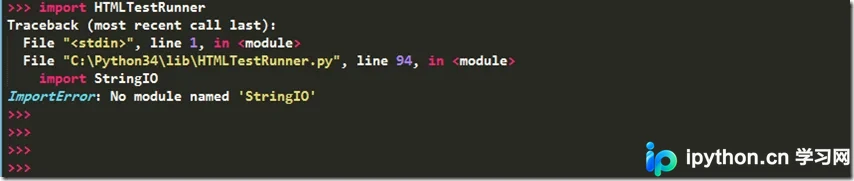
本文详细解析在Python3环境下使用HTMLTestRunner时遇到的ImportError: No module named 'StringIO'错误。由于官方原版基于Python2编写,需手动修改源码以适配Python3语法。文章列出了具体的代码修改位置及对应语句,包括StringIO导入、字典键值判断、字符串解码及print语句的转换,帮助开发者快速解决模块引入失败的问题。
本文详细介绍Python3中字节串bytes与字节数组bytearray的使用方法。涵盖bytes的多种构造方式、常用运算操作,以及bytes与str之间通过encode和decode进行的编码转换流程。