

Python星号与双星号用法:函数参数匹配与对象解包详解
本文系统讲解Python中单星号(*)与双星号(**)的核心语法。涵盖其在数学计算中的基础定义,作为动态参数收集器捕获不定长位置与关键字参数,限制函数调用仅接受关键字传参的规范作用,以及结合列表、字典进行高效解包与扩展赋值的完整实操案例。
2026-10-12
19

本文系统讲解Python中单星号(*)与双星号(**)的核心语法。涵盖其在数学计算中的基础定义,作为动态参数收集器捕获不定长位置与关键字参数,限制函数调用仅接受关键字传参的规范作用,以及结合列表、字典进行高效解包与扩展赋值的完整实操案例。
本文介绍如何使用Python编写脚本,通过百度通用翻译API自动提取并翻译目标软件界面字符串。内容涵盖密钥获取、请求签名生成、代码结构说明及防频率限制优化方法,帮助开发者快速搭建本地化翻译流程。

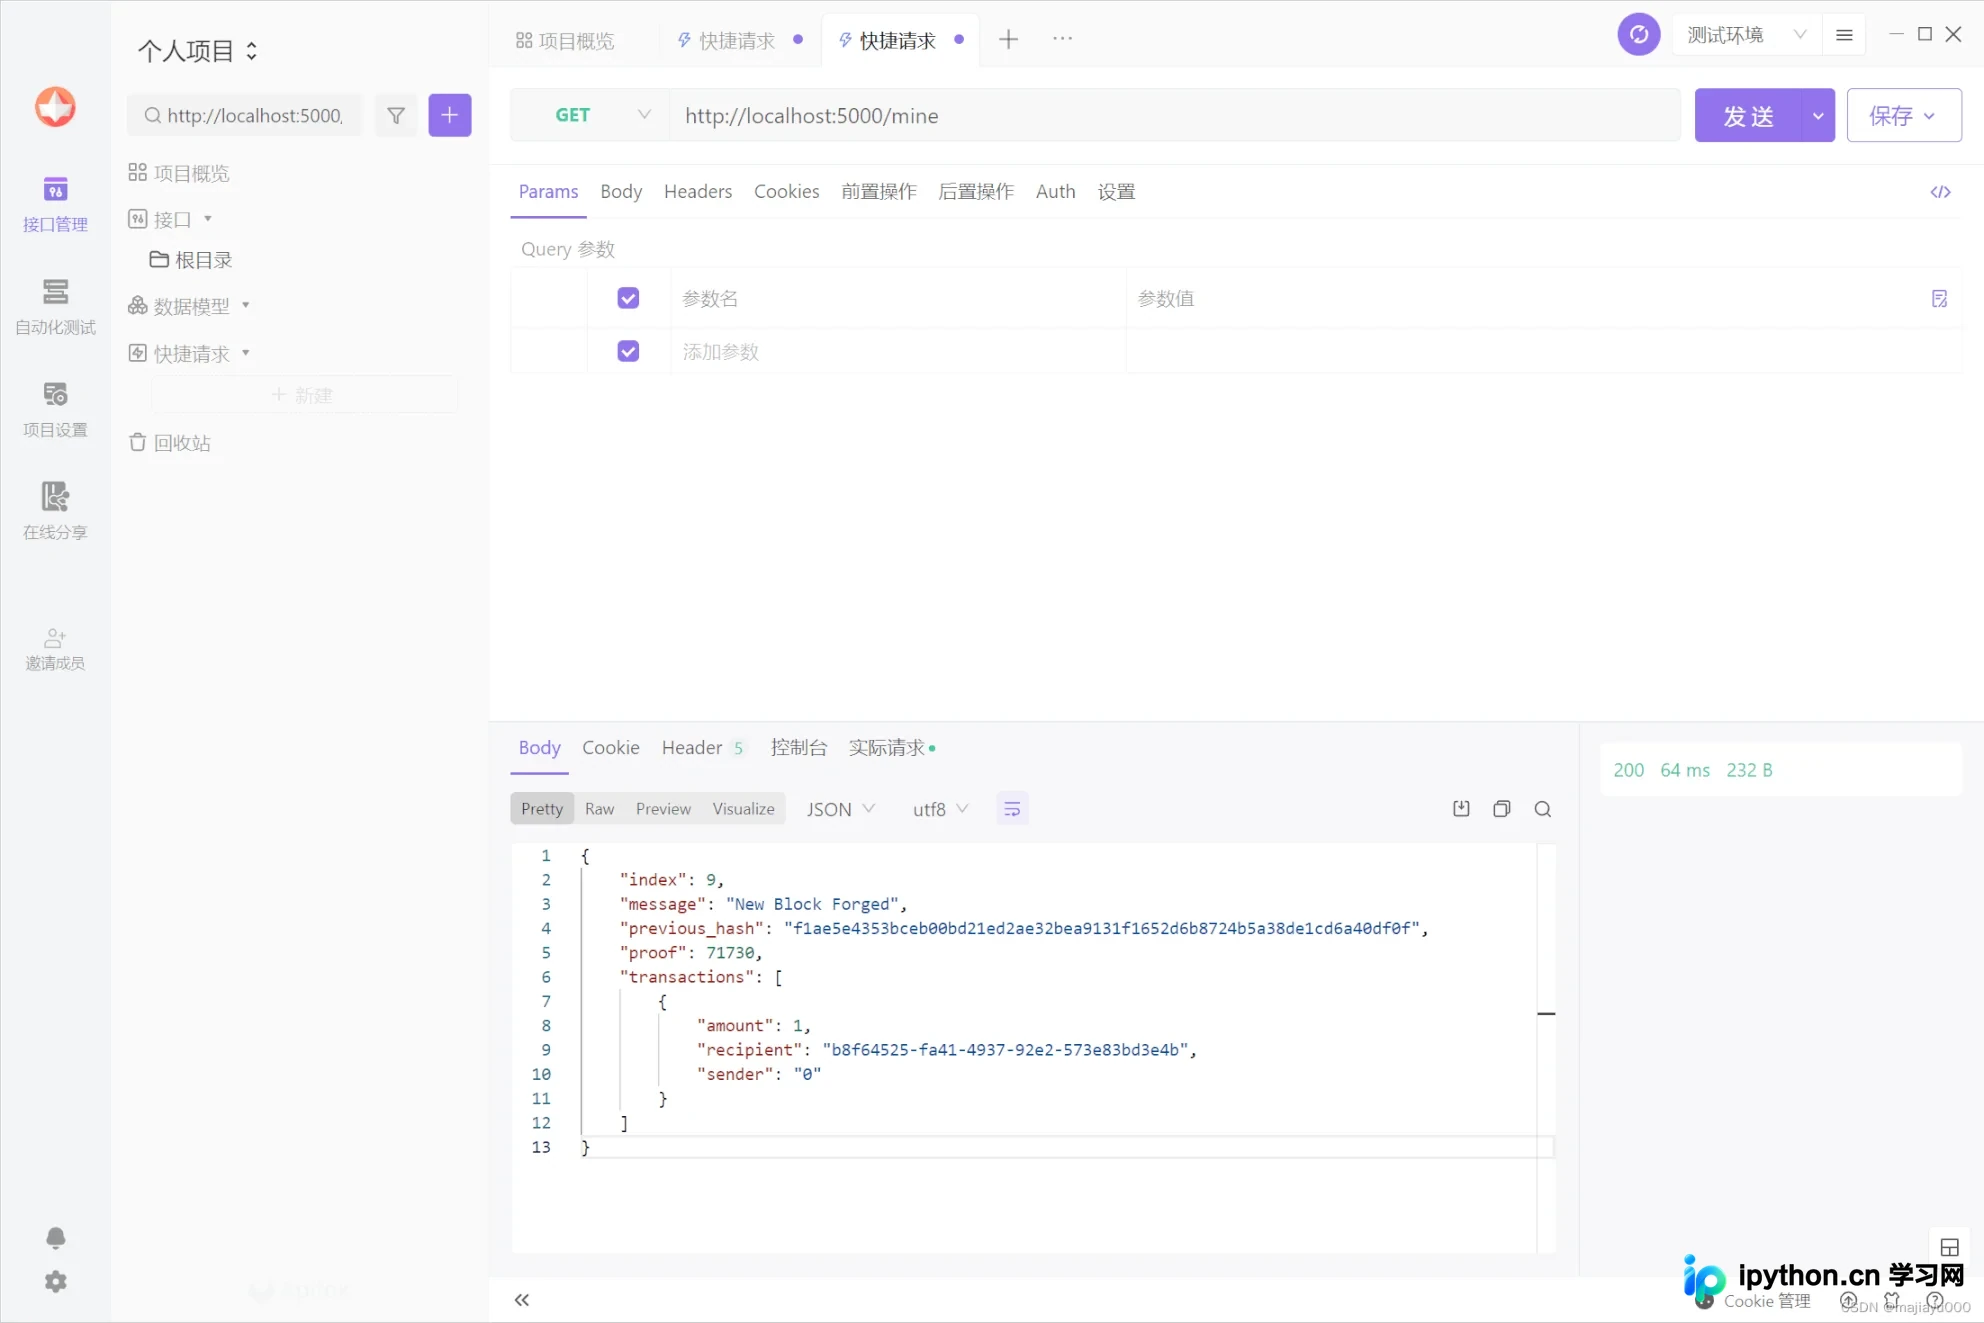
本文详解如何使用Python从零构建一个具备不可篡改特性的分布式账本。通过面向对象设计区块数据结构,实现基于SHA-256的工作量证明(PoW)挖矿算法,并利用Flask框架暴露RESTful接口。内容涵盖交易管理、创世区块初始化、节点注册、多链冲突检测及最长有效链共识机制,提供可直接运行的完整代码逻辑。
本文详细讲解 Pandas 中 DataFrame 与 Series 的数据排序方法,涵盖基于元素值的 sort_values() 与基于索引标签的 sort_index()。通过 ascending、na_position、inplace 及 axis 等核心参数配置,实现单列/多列升降序排列、缺失值控制及原地更新操作,附带类型冲突排错指南,适用于 Python 数据分析流程中的表结构整理。
本文详细解析Numpy数组的三种主流文件存储方案。Txt/CSV适用于简单二维数据但需手动处理维度;Npy/Npz保留完整结构且支持多数组,适合常规场景;Hdf5凭借压缩与切片特性,成为处理大规模数组、避免内存溢出的最佳选择。
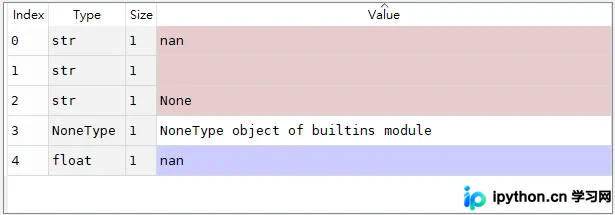
在NumPy数据处理流程中,NaN缺失值的判定存在明确的语法陷阱。直接使用等号比较或布尔条件会引发逻辑误判。本文系统梳理基于np.isnan()、身份运算符的标准验证方案,并结合Pandas内置函数演示如何高效过滤混合数据源,同时厘清None与空字符串的类型边界。
本文介绍如何使用Python的Pandas库读取CSV文件,通过sort_values函数对指定数值列进行排序,并结合Matplotlib生成排序前后的对比图表,帮助快速完成数据清洗与基础可视化。
本文详细拆解使用Pandas批量合并多张Excel表格的标准流程,涵盖有序文件遍历与无序目录扫描两种代码实现。同步给出身份证号等超长数字截断乱码的精准修复方案,助力高效完成底层数据汇总。
本文详细演示如何利用Pygame库实现窗口内小球的流畅反弹动画,并通过面向对象思想将运动逻辑封装为独立类。在此基础上,进一步引入内置的动画精灵组件,结合spritecollide函数完成多球体之间的自动碰撞反馈,提供可直接运行的完整工程结构。
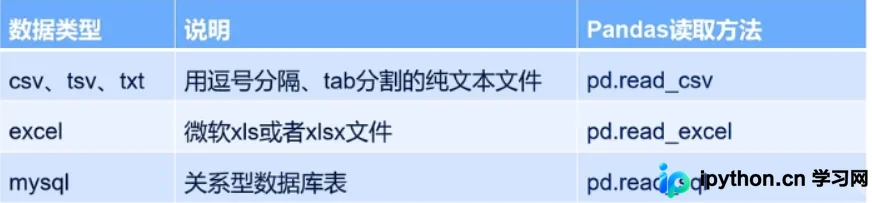
本文详解在 Python 数据分析中,如何使用 Pandas 库高效读取 CSV、TXT 文本文件、多 Sheet Excel 表格以及关系型数据库表。涵盖分隔符指定、列名自定义、数据库引擎配置等核心参数,提供可直接运行的代码示例,助您快速完成数据加载。
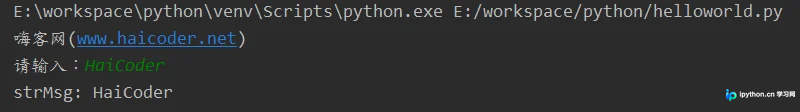
详细讲解Python中input()函数的语法、参数与返回值特性。通过实际案例演示如何获取控制台输入,并重点说明该函数始终返回字符串类型的机制,提供常见的数值类型转换与异常处理方法,帮助开发者稳定处理用户交互数据。
本文详细介绍在 Linux 环境下使用 uWSGI 部署 Django Web 项目的完整流程。涵盖基础环境安装、配置文件编写、系统服务管理与 Nginx 反向代理设置,帮助开发者快速完成生产环境的配置与启动。