

Python中 len() 函数的核心用法与实操示例
Python 中的 len() 是用于获取对象元素数量的内置函数,以 O(1) 时间复杂度直接读取对象的长度属性。它广泛支持字符串、列表、元组、字典及集合等内置序列与映射类型,同时可被 NumPy 数组和 pandas DataFrame 等第三方数据结构继承。本文将详细解析其运行原理、适用边界,并结合输入校验、循环控制与数据切分等实际编码场景提供标准化代码示例,帮助开发者高效调用并避免类型错误。
2026-10-12
19

Python 中的 len() 是用于获取对象元素数量的内置函数,以 O(1) 时间复杂度直接读取对象的长度属性。它广泛支持字符串、列表、元组、字典及集合等内置序列与映射类型,同时可被 NumPy 数组和 pandas DataFrame 等第三方数据结构继承。本文将详细解析其运行原理、适用边界,并结合输入校验、循环控制与数据切分等实际编码场景提供标准化代码示例,帮助开发者高效调用并避免类型错误。
在macOS系统中直接运行python命令前,需将解释器路径加入环境变量。本文根据系统默认终端差异提供两套配置方案。通过修改Shell初始化文件,添加PATH变量与别名设置,执行刷新命令后即可在任意目录下调用python,彻底解决命令行无法识别指令的问题。
讲解如何将 Python 列表快速转换为 Excel 表格第一列。分别基于 openpyxl 与 pandas 库提供完整代码示例,涵盖单维列表导入、二维数据切片及多表头组合写入,附带文件保存参数说明与常见报错排查,帮助开发者精准掌握数据导出流程。
本文详细讲解卷积神经网络(CNN)的工作原理,并提供基于NumPy的Python原生实现代码。涵盖卷积、激活、池化等核心层的搭建方法,帮助开发者快速理解并掌握CNN的前向传播逻辑,适用于图像分类与特征提取任务的基础学习。
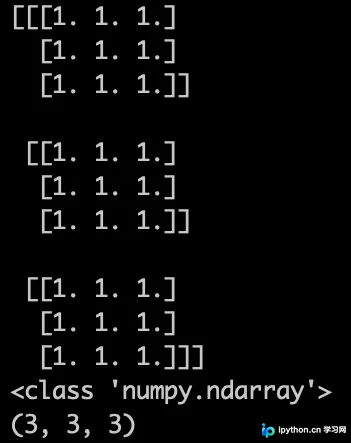
本文详细讲解在Python中如何利用NumPy库快速创建指定形状的三维数组,并通过理解深度、行与列的三维索引逻辑,演示如何将二维矩阵准确赋值至三维数组的不同切片层、行或列中,附带完整代码与运行结果对照。
本文介绍如何通过 Python 编程替代传统的 docker-compose YAML 文件进行容器编排。该方法借助 netkiller-devops 库,利用 Python 的动态特性自动生成 Dockerfile 与 docker-compose.yml,并通过内置接口一键管理服务生命周期。相比纯 YAML 配置,该方法更能满足大规模服务集群管理与复杂逻辑编排的需求。
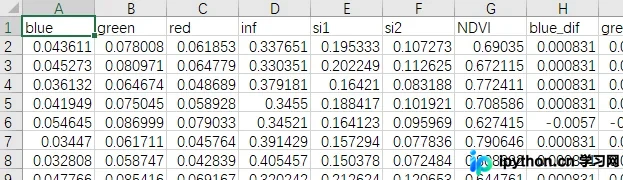
针对包含多列特征的表格数据,本文演示如何使用Python的pandas库,根据指定数值区间自动剔除不符合条件的行。通过布尔索引组合多列筛选条件,高效完成数据清洗并输出新文件,适用于模型训练前的大量样本过滤场景。
在Windows 11系统中原生命令行无法直接使用pip升级Python解释器。本文提供两种安全可靠的升级路径:利用系统自带Winget包管理器快速替换版本,以及通过Python官网安装器执行覆盖升级。内容涵盖环境核查、关键参数设置、多版本共存处理与常见报错排查,帮助开发者在无风险前提下完成版本迭代。
本文详解Python列表与字典推导式的标准写法与底层执行逻辑。通过条件过滤、键值转换等实战案例,展示如何用单行代码替代冗长循环。同时补充历史版本差异说明、dict构造函数与zip函数的等效替代方案,助力开发者高效完成数据清洗与映射任务。
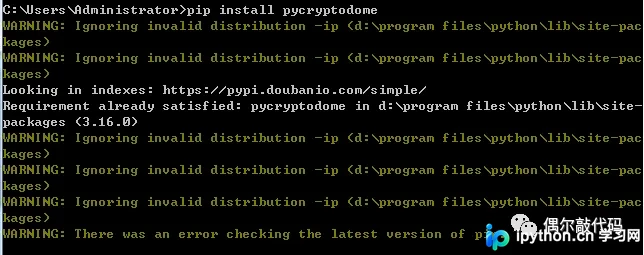
在Python项目中调用加密功能时常遇到No module named 'Crypto'报错。该问题多由安装包命名冲突、大小写不一致或环境缓存未刷新导致。本文通过标准安装流程配合Lib\site-packages路径手动校正,快速消除模块缺失错误,确保代码顺利运行。
本文详解 MapReduce 分布式计算思想在 Python 中的落地方法。通过基础映射归约代码演示核心流程,剖析多线程因 GIL 无法并行的原因,提供基于 multiprocessing 的多进程完整示例。进一步结合生成器分块读取与进程池,实现 GB 级文本的快速关键字检索,附带性能调优参数说明。
本文详细介绍如何利用Python的paramiko第三方库编写自动化脚本,完整涵盖SSH客户端实例化、账号密码与私钥双模认证、远程指令下发与结果流读取的全过程,并附带主机密钥安全配置规范及生产环境避坑指南。