

Python自定义模块制作教程 从建包到调用的完整指南
本指南系统讲解Python自定义模块的构建流程。通过合理规划包目录、编写核心函数与标准文档字符串、配置初始化文件,并结合精准导入语句进行测试验证,帮助开发者高效实现代码模块化复用与工程维护。
2026-10-11
20

本指南系统讲解Python自定义模块的构建流程。通过合理规划包目录、编写核心函数与标准文档字符串、配置初始化文件,并结合精准导入语句进行测试验证,帮助开发者高效实现代码模块化复用与工程维护。
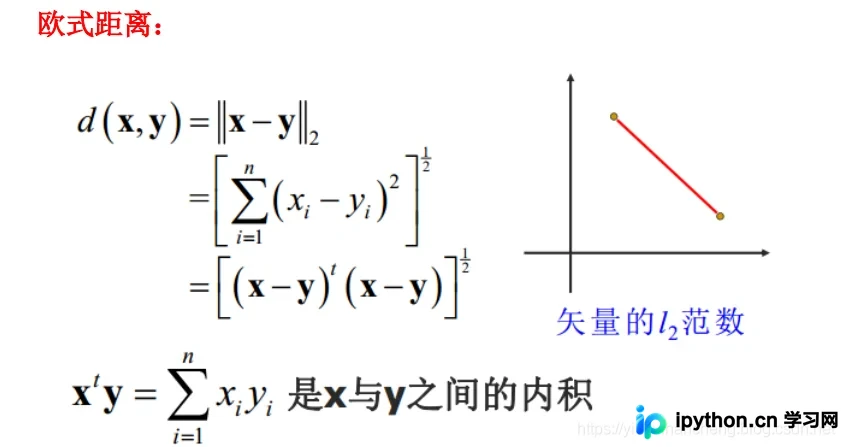
本文梳理了向量、字符串及集合场景下的主流相似度与距离计算方法,涵盖欧氏、余弦、杰卡德及三大相关性系数。提供基于 Python 3 与 SciPy 的完整实现代码,包含参数配置、环境依赖与运行结果对照,助开发者快速落地数据挖掘与分析任务。
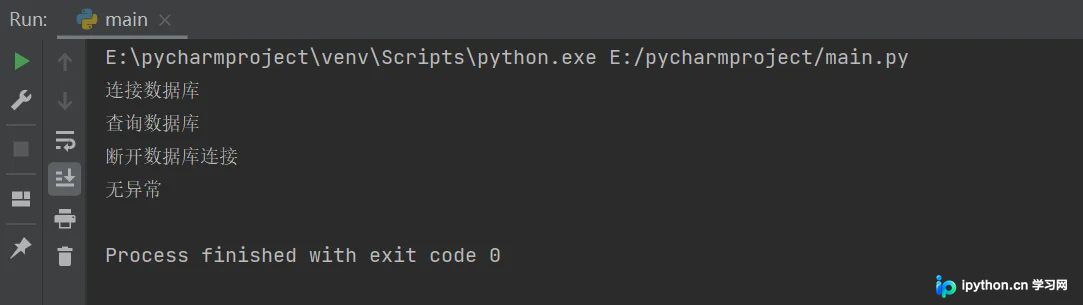
本文详解Python上下文管理器的工作原理与with语句的实际用法。通过构建符合__enter__与__exit__协议的类,可实现资源自动初始化与安全释放。内容涵盖方法参数解析、异常拦截机制及完整代码示例,助您编写更规范的资源管理逻辑。
在pandas中处理DataFrame时,布尔索引是最常用的行过滤方式。本文系统梳理单列条件、多条件组合及字符串匹配的写法,结合电影数据集演示完整筛选流程,并提示运算优先级与缺失值处理的易错点,帮助快速准确提取目标数据。
本文介绍如何在Python环境中安装Matplotlib数据可视化库,通过标准流程演示调用接口、定义X/Y轴数据、生成折线图及添加标题标签的代码逻辑。同时提供线条样式与配色参数的配置方法,覆盖从环境准备到结果输出的完整操作路径。
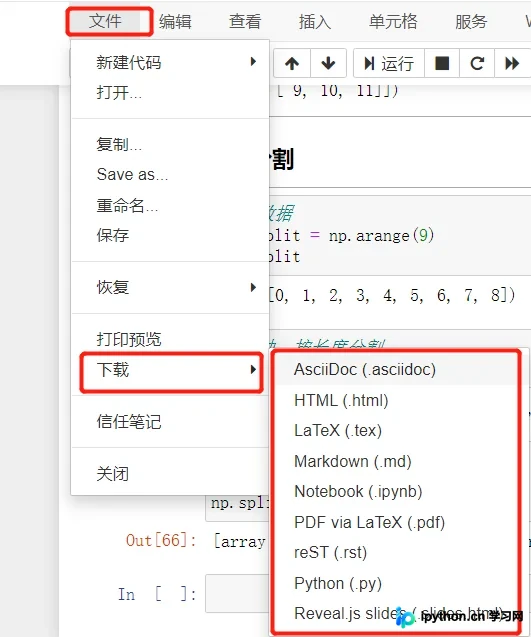
直接通过 Jupyter 界面导出 PDF 时常出现中文乱码或丢失。本文介绍使用命令行结合 XeLaTeX 引擎的标准工作流:安装 LaTeX 环境后,通过 jupyter nbconvert 生成 .tex 文件,仅需修改文档类为 ctexart 或引入 ctex 宏包,再运行 xelatex 编译即可输出排版规范且完整保留中文的 PDF 文档。
本文系统讲解Python中字典推导式与集合推导式的实用技巧。通过从零构建映射、安全合并双列数据及条件过滤等操作,演示推导式在批量数据处理中的高效写法,附带运行结果校验与常见边界问题说明,助力开发者写出更简洁的代码。
本文详细讲解 Python re 模块的核心用法,涵盖 re.search()、re.findall()、re.sub() 等常用函数的操作入口与参数配置。通过匹配数字、提取全量结果及文本替换的完整代码示例,说明如何正确编写正则模式与验证执行状态,并介绍 re.compile() 在高频调用场景下的性能优化方案。
本文详细演示如何利用Python内置的字符串方法结合os模块,自动统计TXT文本文件中的英文字母、数字、空格、中文字符及特殊符号数量。通过封装单行校验函数与文件遍历逻辑,提供完整可运行的代码方案,满足日常数据核对与批量处理需求。
针对生物信息学或网络分析中常见的双向重复记录(即节点A与B的互作被拆分为AB与BA两行),直接调用内置去重方法无法生效。本文详解如何利用字符串字典序构建临时归一化标识,配合apply函数与subset参数精准过滤冗余行,并安全移除辅助列的标准操作流程。
本文演示如何基于 Python 与 OpenCV 生态快速搭建轻量级人脸识别考勤系统。内容涵盖环境依赖安装、人员照片数据集目录规划、面部特征向量提取与实时视频流匹配算法,并结合 csv 模块实现打卡数据的自动写入。附带完整工程代码与运行指引,适合初学者理解计算机视觉基础应用开发流程。
在 Python 中处理外部文本数据时,需依赖内置模块完成安全读写。本文演示如何通过 open 函数结合 with 语句建立文件连接,详细拆解 read、readlines 用于提取内容,以及 write、writelines 用于持久化输出的操作逻辑。附带路径存在性检查与模式参数说明,确保脚本在不同工作目录下稳定运行。