

Python2中CSV写入出现空白行的原因及解决方法
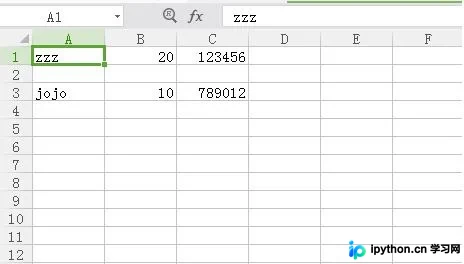
本文探讨Python2环境下使用csv模块写入数据时产生多余空白行的现象。核心原因在于文件打开模式的选择:二进制模式('wb')与文本模式('w')对换行符的处理机制不同。通过对比两种模式下的代码实现,解析换行符转换差异,帮助开发者避免此类数据格式错误。
2026-10-13
20

本文探讨Python2环境下使用csv模块写入数据时产生多余空白行的现象。核心原因在于文件打开模式的选择:二进制模式('wb')与文本模式('w')对换行符的处理机制不同。通过对比两种模式下的代码实现,解析换行符转换差异,帮助开发者避免此类数据格式错误。
本文介绍如何使用Python脚本结合pandas库与SQLAlchemy引擎,实现将本地CSV文件快速批量插入数据库的功能。脚本通过命令行接收文件名和表名,利用copy_from方法高效处理数据写入,适用于PostgreSQL等支持COPY命令的数据库场景。
本文介绍如何使用Python将CSV文件中的数据读取并导入MySQL数据库。通过示例代码展示连接数据库、解析CSV文件及执行插入语句的具体步骤,帮助开发者快速实现数据迁移功能。
本文详细介绍Python中利用xlrd模块读取Excel数据及xlwt模块写入Excel文件的方法。涵盖模块安装、工作簿与工作表对象获取、行列数据提取、单元格值读取以及新建工作簿、添加工作表、写入数据与样式设置等核心操作,提供完整代码示例供参考。
本文介绍使用Python实现自动发送报警监控邮件的方法。通过配置QQ企业邮箱的SMTP参数,实现日常任务执行状态的自动检查与异常报警。脚本支持指定发送与接收邮箱,并可添加附件功能,帮助运维人员及时获取任务执行结果,确保系统稳定运行。
本文提供Python实现人民币金额大写转换的完整代码及详细逻辑。通过将数字按四位分段处理,分别转换整数与小数部分,并处理零值及单位追加等特殊情况,确保转换结果符合财务规范。代码包含调试开关及四舍五入逻辑,适用于需要精确金额大写输出的场景。
本文详解利用Numpy和Pandas库将CSV文件数据读取为数组或矩阵的方法。重点解决路径转义字符导致的SyntaxError,并演示使用Pandas处理缺失值及结合Sklearn的Imputer进行数据清洗的完整流程。
本文介绍了一个基于Python的小型爬虫系统实现,涵盖URL管理、HTML下载、解析及输出模块。通过正则表达式提取链接,利用BeautifulSoup解析文本内容,并支持将抓取结果保存为HTML表格或TXT文件。代码展示了从初始URL到批量文档下载的全流程,适合Python初学者理解爬虫架构与核心逻辑。
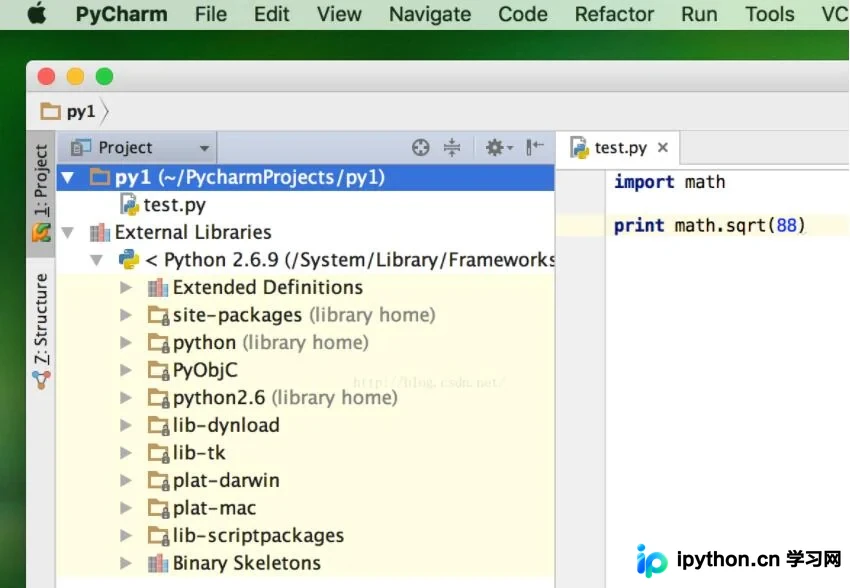
本文介绍在macOS系统中,当PyCharm默认使用旧版Python(如2.6)时,如何手动切换至系统自带的Python 2.7版本。通过检查系统已安装的Python版本,并在PyCharm的项目解释器设置中指定正确的解释器路径,完成External Libraries的配置,确保第三方库正常加载。
本文详细介绍如何在Scrapy框架中集成Redis以实现分布式爬虫。涵盖scrapy-redis库的安装方法、Redis服务器的启动与缓存清理,以及settings.py中的关键配置参数。通过示例代码展示如何继承RedisSpider类并设置redis_key,帮助开发者高效构建高性能的分布式数据采集系统。
本文详细讲解如何利用pandas库对Series和DataFrame进行排序操作。内容涵盖按索引排序、按值排序、升降序调整及多列排序等核心功能,通过具体代码示例与运行结果展示,帮助开发者掌握数据清洗与预处理中的关键排序技巧。
本文介绍如何在Python pandas中处理包含多层索引的DataFrame。通过示例展示使用droplevel()方法逐层移除索引,从而将多重索引转换为单一默认索引,帮助开发者简化数据结构。