Python批量获取基金数据的方法步骤
本文介绍如何使用Python批量获取基金数据。通过请求特定URL获取基金编号,解析JavaScript文件提取基金代码,并进一步获取单位净值和累计净值。代码实现了初步的数据汇总,输出CSV文件保存基金的单位与累计净值,为后续结合统计方法筛选优质基金提供基础数据支持。
2026-10-12
21

本文介绍如何使用Python批量获取基金数据。通过请求特定URL获取基金编号,解析JavaScript文件提取基金代码,并进一步获取单位净值和累计净值。代码实现了初步的数据汇总,输出CSV文件保存基金的单位与累计净值,为后续结合统计方法筛选优质基金提供基础数据支持。
处理百万行级别的Excel文件时,常规方法往往耗时过长。本文通过对比pandas、xlrd和openpyxl模块的性能,发现开启openpyxl的只读模式可将打开20MB文件的时间从67秒缩短至0.4秒。文章提供了生成测试数据及读取大文件的完整Python代码示例,帮助开发者高效处理大规模表格数据。
本文详细介绍使用Python开发学生通讯录管理系统的实现过程。系统包含添加、删除、修改学生信息,统计联系人数量及展示所有通讯信息五大核心功能。通过菜单交互与列表存储,提供完整的Python源码供学习参考,适合编程初学者理解基础数据结构与逻辑控制。
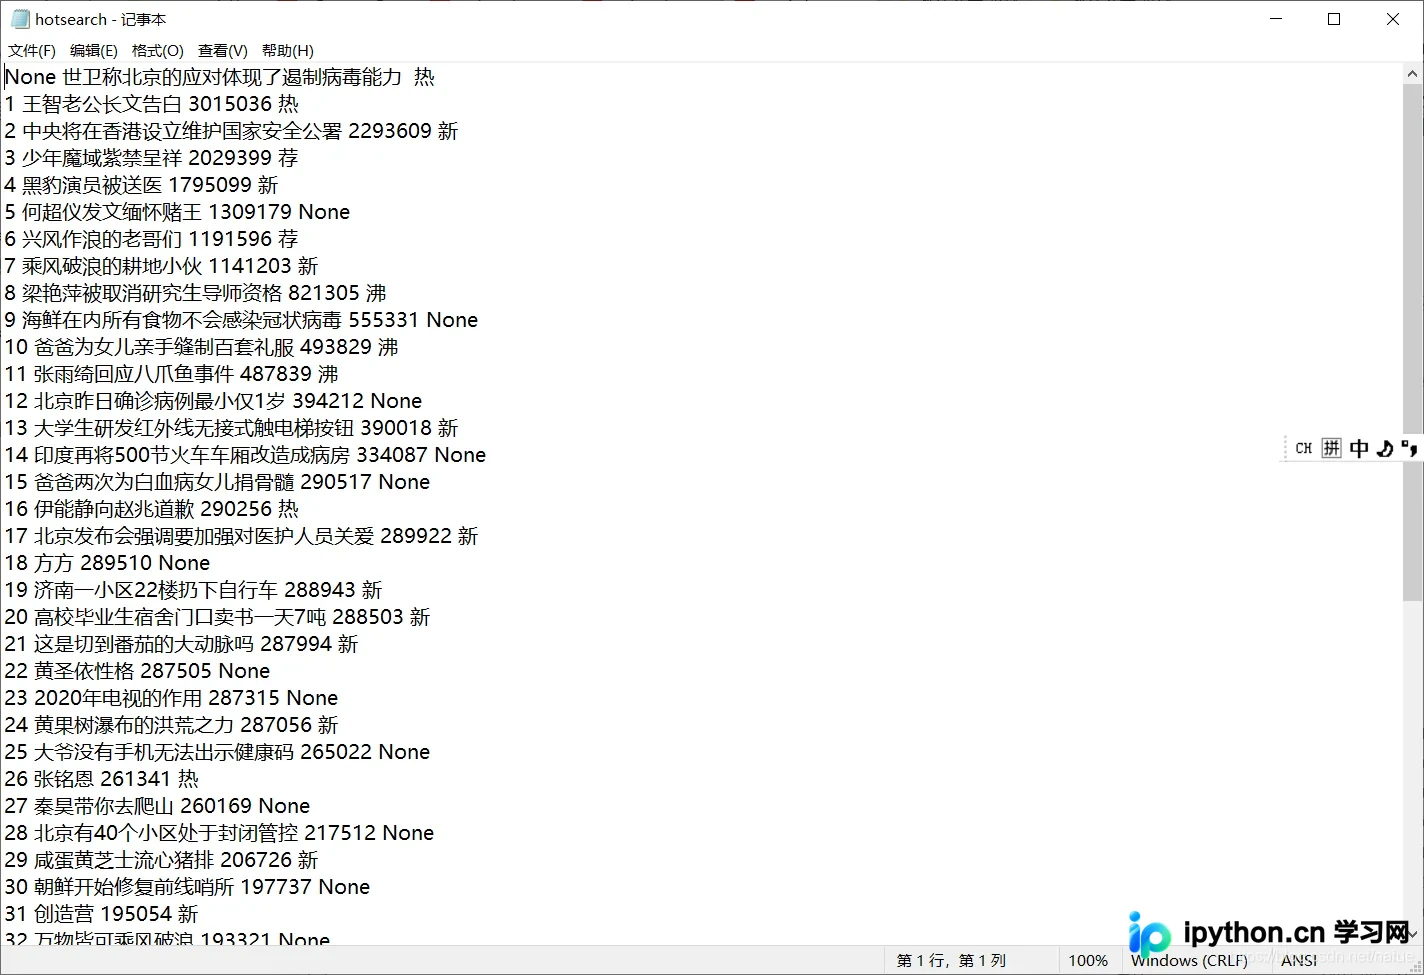
本文介绍如何使用Python爬取微博热搜数据并保存为文本文件。通过requests获取页面,利用BeautifulSoup解析HTML结构,提取热搜排名、标题及指数。此外,结合pandas和pyecharts库,对定时爬取的热搜数据进行可视化分析,生成动态时间轮播图,展示热搜趋势。
本文深入解析 Python 中 re.match() 函数的正则匹配机制,重点对比贪婪模式(.*)与懒惰模式(.*?)的行为差异。通过具体代码示例,展示如何控制捕获组提取内容,并探讨特殊字符在正则表达式中的实际作用与潜在报错原因。
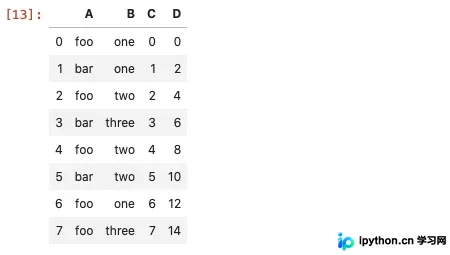
本文详细解析在Python Pandas中将包含列表的列拆分为多行的多种实现方法。通过对比apply、repeat、reindex及numpy组合等方案的性能与适用场景,帮助开发者选择最高效的数据处理策略。
本文详解pandas中筛选指定列值对应行的多种方法。涵盖布尔索引、基于iloc的位置索引、基于loc的标签索引及高效的query API。通过具体代码示例,演示如何筛选等于标量、属于范围、多条件组合及排除特定值的行,帮助开发者高效处理数据子集。
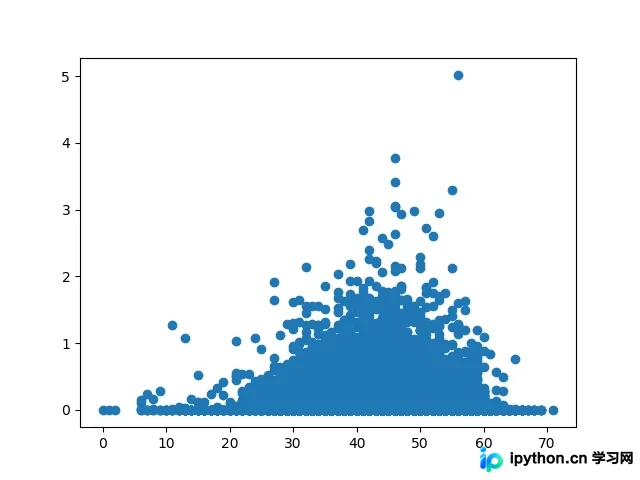
本文介绍在 Matplotlib 中修改绘图背景的多种方法。通过 set_facecolor 或 set 函数设置纯色背景,利用 set_alpha 控制透明度。此外,演示如何加载图片并使用 imshow 结合 extent 参数将其作为散点图背景,实现丰富的可视化效果。
本文详细介绍 Python 中删除列表元素的三种常用方法:remove、pop 和 del。remove 按值删除首个匹配元素;pop 按索引删除并返回被删元素;del 根据索引或范围删除,也可用于删除整个变量引用。文章通过具体代码示例对比三者的行为差异,并补充了通过遍历生成新列表的变相删除技巧,帮助开发者根据实际需求选择合适的方法。
本文详解Python中join()函数的核心原理与使用场景。通过指定分隔符将字符串、列表、元组或字典序列合并为新字符串,并介绍os.path.join()在路径组合中的应用。包含具体代码示例与注意事项,帮助开发者高效处理字符串拼接任务。
本文介绍了Python中实现剪切板监听的两种常见方法。第一种基于win32clipboard库,执行速度快但稳定性较差,容易出错;第二种采用pyperclip库,虽然速度稍慢,但运行稳定且不易报错。作者建议在程序开发中优先使用第二种方案,以确保后台脚本的可靠性。
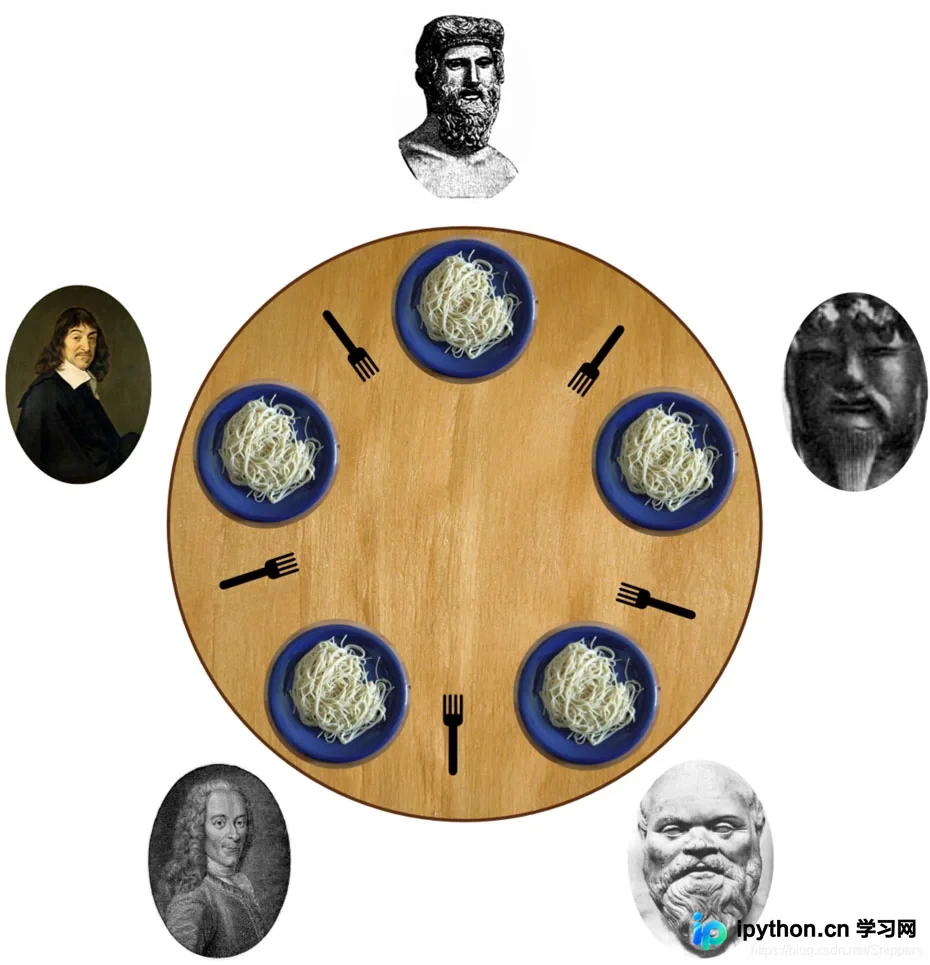
本文介绍如何使用Python多线程解决经典的哲学家就餐问题。通过定义CountDownLatch和DiningPhilosophers类,利用Lock实现叉子资源的互斥访问,并采用非阻塞获取策略避免死锁。代码完整展示了哲学家思考、拿取、进食及释放叉子的全过程,并输出符合格式的行为记录列表。