详解Python中如何计算矩阵的行列式
本文详细介绍在Python环境中计算矩阵行列式的方法。通过配置NumPy与SymPy依赖库,分别演示基于浮点数的数值求解与基于符号运算的精确求解。涵盖2×2与3×3方阵的完整代码示例,说明精度处理逻辑与非方阵报错机制,帮助开发者快速掌握行列式求解流程。
2026-10-11
21

本文详细介绍在Python环境中计算矩阵行列式的方法。通过配置NumPy与SymPy依赖库,分别演示基于浮点数的数值求解与基于符号运算的精确求解。涵盖2×2与3×3方阵的完整代码示例,说明精度处理逻辑与非方阵报错机制,帮助开发者快速掌握行列式求解流程。
本文详细解析Scrapy框架中items文件夹的标准工作流程。通过创建继承自scrapy.Item的结构化数据类,在Spider解析函数中提取并填充字段,最后经settings.py配置的Pipeline管道进行清洗或入库,可彻底告别松散字典传递,实现高效稳健的爬虫数据管理。
列出已安装的 Python 包有助于快速审计项目依赖或排查环境冲突。本文详细演示如何通过 pip 命令行、Python 内置模块、依赖可视化工具以及 Jupyter 等常见开发环境,准确获取安装包列表及其版本信息,并提供对应的参数设置与结果核对方法。
本文详细介绍如何在 Python 中使用 BeautifulSoup 库解析 HTML 网页。通过安装依赖、配置代理请求、结合 find 方法与 CSS 选择器提取标题、链接及指定元素文本,帮助开发者快速实现静态页面的自动化数据抓取与结构化处理。
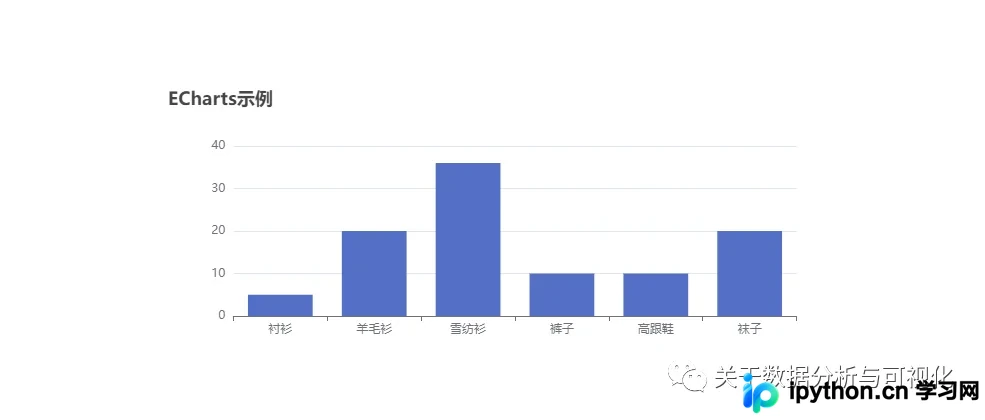
在数据分析与可视化场景中,借助 Python 库 Streamlit 搭配 ECharts 或 Pyecharts,开发者无需前端经验即可快速搭建交互式 Web 数据大屏。本文详细演示如何通过 pip 安装依赖、编写图表配置字典,以及调用内置渲染函数实现两种主流方式的图表渲染,并提供运行验证与排错指引。
本文详解 Python 多处理模块中 Process 类的标准用法。针对 CPU 密集型任务受全局解释器锁限制的问题,提供从零创建子进程、批量并发执行、跨进程数据传递及异常隔离处理的完整实操指南,帮助开发者快速构建高效的多进程并行计算流程。
在 Python 中处理包含字典的列表时,若需批量移除满足特定条件的元素或指定位置的记录,可采用列表推导式、filter 函数配合 lambda 表达式,以及 del 关键字按索引操作。本文详细演示三种方法的代码写法、执行结果及注意事项,帮助开发者根据实际场景选择最高效且安全的实现方案。
借助NumPy库可高效构建与编辑图像矩阵。本文以RGB三通道为例,演示如何通过zeros初始化指定尺寸与数据类型的底层数组,利用全切片赋值快速切换纯色背景,并通过精确的行列切片操作在画布上绘制空心矩形,适用于图像处理初学者建立内存级绘图认知。
本文详细演示如何使用Python标准库os.walk遍历目录树并高效查找文件。通过文件名包含、后缀过滤、目录检索及正则模糊搜索等多种策略,结合性能优化技巧,帮助开发者快速定位目标资源,解决批量文件管理与自动化巡检中的实际需求。
本文详细解析Python函数的四种核心参数类型及其组合规则,通过BMI计算示例演示位置参数、默认参数、*args可变参数与**kwargs关键字参数的定义顺序和调用技巧,帮助开发者避免传参报错,提升代码可读性与灵活性。
functools.singledispatch 是 Python 提供的单分派工具,可将普通函数转换为基于首个参数类型自动路由的泛型函数。通过装饰器为不同数据类型注册独立处理器,替代冗长的条件分支,显著提升代码可读性与扩展性。本文详解其核心机制、标准配置步骤及多类型兼容实战,帮助开发者快速掌握类型分发模式。
Python 处理本地数据时,常需自动获取目录文件列表以替代繁琐的手动筛选。本文基于标准库 os,详细演示如何精准提取单层目标文件、递归收集多级子目录内容,并结合实际业务流完成文件批量重命名。代码附带路径安全校验与异常处理机制,帮助开发者快速搭建稳定的自动化数据预处理管道。