

使用Python高效实现Markdown与其他文档格式相互转换
本文详细介绍如何利用Python生态中的MarkItDown与python-markdown两大开源工具,实现多格式文档(如PDF、Office、图片)与Markdown之间的双向高效转换。内容涵盖环境配置、核心API调用、内置插件扩展机制及自定义样式处理,助您快速搭建自动化长文本解析与数据预处理流水线。
2026-10-11
21

本文详细介绍如何利用Python生态中的MarkItDown与python-markdown两大开源工具,实现多格式文档(如PDF、Office、图片)与Markdown之间的双向高效转换。内容涵盖环境配置、核心API调用、内置插件扩展机制及自定义样式处理,助您快速搭建自动化长文本解析与数据预处理流水线。
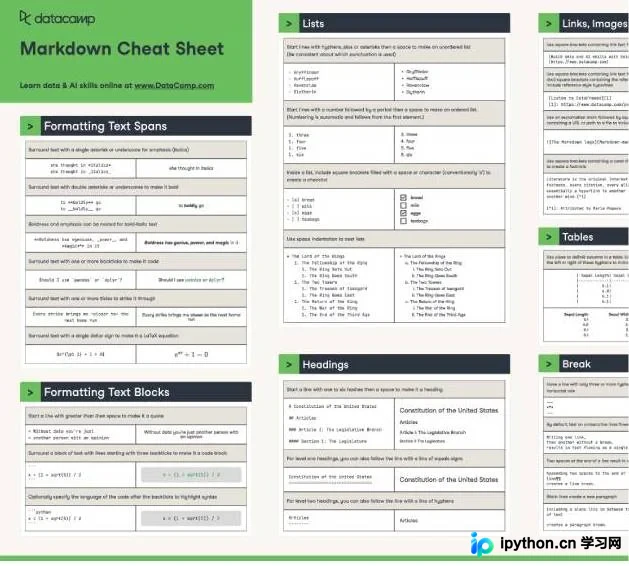
本文介绍如何利用 Python 结合 OpenCV 库,将闲置智能手机通过 IP Webcam 应用转化为网络摄像头,并在电脑上实时读取并显示其视频流的方法。涵盖环境配置、网络地址获取、完整 Python 代码实现以及常见问题排查。
针对服务器处于无网、内网或高安全隔离环境而无法使用 pip install 的情况,本文演示如何从 PyPI 获取指定版本的源码压缩包,并通过本地解析与命令执行完成 Python 第三方包的离线部署。流程涵盖资源定位、文件传输、解压安装及依赖验证,适用于各类遵循标准打包规范的独立模块。

在Python项目开发中,合理使用 from import 语句能够大幅简化模块调用语法,同时降低命名空间污染风险。本文系统梳理了标准全量导入与定向对象导入的执行差异、典型应用场景及工业级代码规范,帮助开发者有效规避隐式依赖与同名录入冲突,写出更易维护的脚本。
在Python开发中,精准控制日期与时间的显示格式是日志记录、数据导出和文件命名的常见需求。本文系统梳理基于内置datetime与time模块的标准写法,对比arrow、dateutil、pytz与pandas等第三方库的高效实现,并给出历史区间计算、模糊文本解析及跨时区转换的工程技巧,帮助开发者快速匹配最优方案。
面对包含多个工作表的Excel文件,手动拆分极易漏改且耗时。本文介绍使用Python与pandas库编写自动化脚本,按Sheet名称逐个读取并导出为独立文件的操作流程,附带核心参数说明与运行排错指南,适用于日常数据处理与办公提效。
本文详解如何使用Python主流库处理PDF文件。涵盖PyPDF2执行合并拆分与加解密、pdfminer.six与PyMuPDF精准提取文档文本、ReportLab动态创建页面及嵌入图片。提供完整代码示例、依赖安装步骤与安全操作规范,助您快速掌握自动化文档处理全流程。
在使用 pip install jupyterlab 安装深度学习交互式笔记本时,常因缺少 Rust 编译环境或依赖损坏导致构建失败。本文详细解析 pywinpty 包的底层依赖机制,并给出基于 conda 通道快速补全组件、绕过本地编译限制的标准操作步骤。
针对日常办公中重复繁琐的任务,本文提供10个基于Python的自动化办公脚本方案。涵盖Excel批量处理、数据清洗、自动发邮件、文件重命名与备份、PPT生成、报表可视化及任务调度等核心场景,附带关键库安装说明、完整代码示例及参数配置方法,助你快速搭建个人提效工具链。
在数据分析与建模前,原始数据常伴随缺失、重复、异常及格式混乱等问题。本文基于Python生态,系统梳理数据清洗的标准流程:涵盖缺失值的删除与多维填充、重复记录的清除与标记、异常值的阈值控制、类型转换与文本清洗,以及分组统计、连续变量分箱和特征归一化。掌握这些操作可快速提升数据质量,保障后续分析结果的可靠性。
介绍在Python中如何准确测量代码执行时间。指出传统time.time()方法易受系统干扰且精度不足,进而详解timeit模块的核心参数、timeit()与repeat()函数的实际调用方式,以及命令行界面的快捷用法,帮助开发者高效进行代码性能基准测试与算法对比。
Python 的 socket 模块提供底层网络通信接口。基于 TCP 协议搭建稳定的客户端与服务端,需依次完成套接字创建、地址与端口绑定、监听分发、数据收发及连接释放。本文通过完整代码演示如何利用 threading 实现服务端并发处理,明确各核心参数的作用范围,并附带运行验证结果与常见断连排错方法。