

Pandas数据清洗与转换:缺失值处理、去重及哑变量生成详解
本文系统讲解Pandas库中数据清洗与转换的核心指令。涵盖缺失值检测与处理,包括使用dropna过滤、fillna填充及thresh参数控制;详解数据去重方法duplicated与drop_duplicates;介绍replace替换、rename重命名及get_dummies生成One-hot编码的技巧,助力高效数据预处理。
2026-10-14
9

本文系统讲解Pandas库中数据清洗与转换的核心指令。涵盖缺失值检测与处理,包括使用dropna过滤、fillna填充及thresh参数控制;详解数据去重方法duplicated与drop_duplicates;介绍replace替换、rename重命名及get_dummies生成One-hot编码的技巧,助力高效数据预处理。
本文详解 Python Selenium 中键盘与鼠标的高级操作。通过 Keys 类模拟 Ctrl+A/V 等组合键及删除、清空输入框;利用 ActionChains 类实现右击、双击、拖动及元素悬停。结合具体代码示例,展示如何在 Web 测试中精准控制浏览器交互,提升自动化脚本的实用性与完整性。
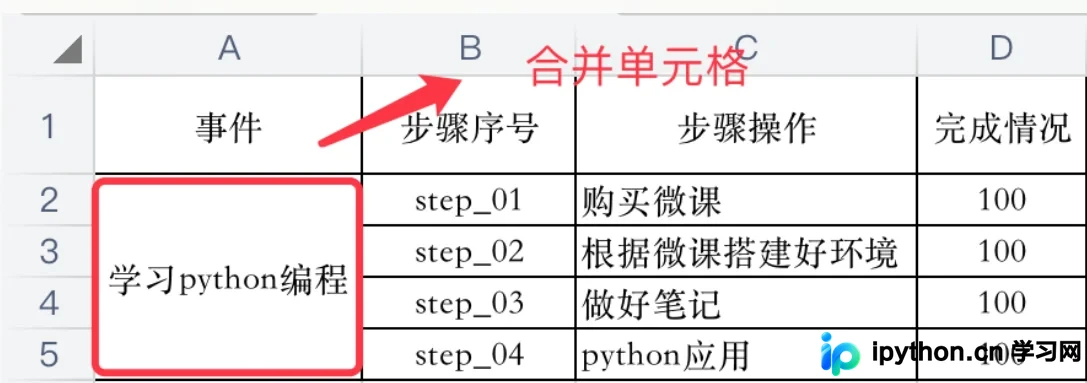
本文介绍如何使用Python的xlrd模块读取Excel文件中的合并单元格数据。通过解析merged_cells属性,编写函数获取合并单元格的值,并判断指定坐标是否为合并单元格。
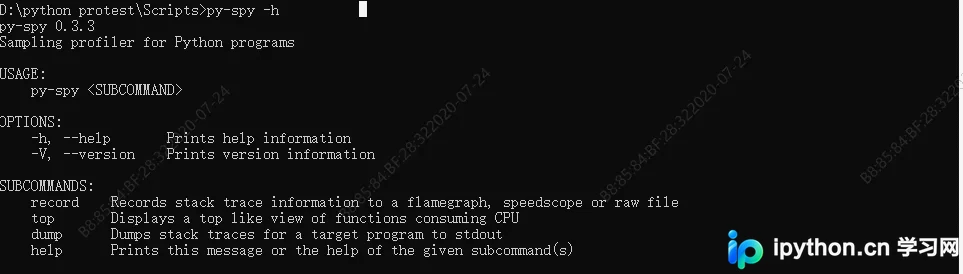
本文详细介绍Python性能分析工具py-spy的安装与核心用法。作为基于Rust开发的低开销抽样分析器,py-spy无需修改代码即可监控生产环境。文章涵盖通过record命令生成火焰图以定位瓶颈,以及利用top命令实时查看函数耗时并排序分析,帮助开发者高效解决Python应用的性能问题。
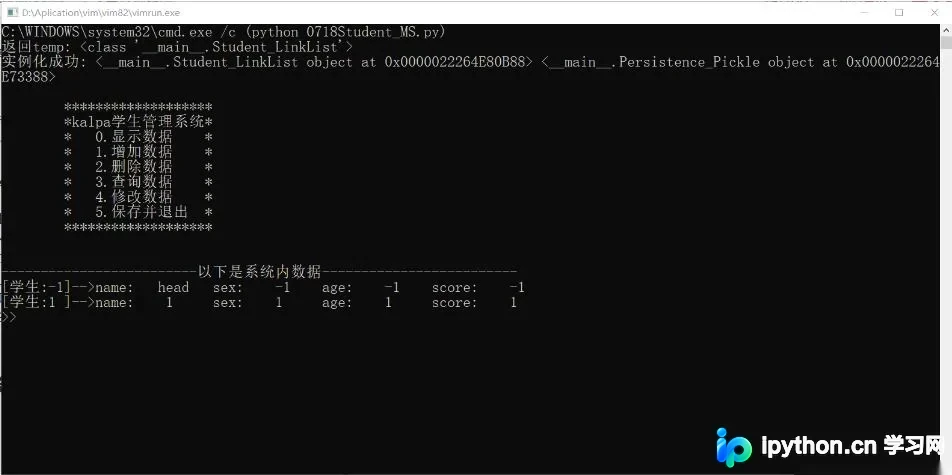
本文介绍使用Python实现学生管理系统的完整方案。系统采用单链表存储学生数据,通过Node类构建节点,利用Student_LinkList类管理链表操作。数据持久化借助pickle模块的dump和load方法实现文件存储,配置文件通过configparser解析Student.ini以动态加载子类。文章涵盖类关系设计、命令行交互界面及核心代码逻辑,适合Python初学者理解面向对象设计与数据管理。
本文详解 Python 中正则表达式处理多行文本的常见陷阱。当使用点号(.)匹配任意字符时,默认无法匹配换行符。文章介绍了两种解决方案:一是通过非捕获组(?:.\n)显式包含换行符;二是利用 re.compile 的 re.DOTALL 标志,使点号能匹配包括换行符在内的所有字符。同时对比了两种方法的适用场景,建议复杂模式优先使用标志位以提高代码可读性和维护性。
本文探讨为何Python成为树莓派开发的首选语言。尽管树莓派基于ARM架构且支持多种语言,但Python凭借简洁语法、跨平台特性及丰富的社区库,极大降低了硬件控制门槛。文章对比了Python与其他语言在树莓派上的表现,并引用社区观点分析了RPi.GPIO库的优缺点及实际应用场景。
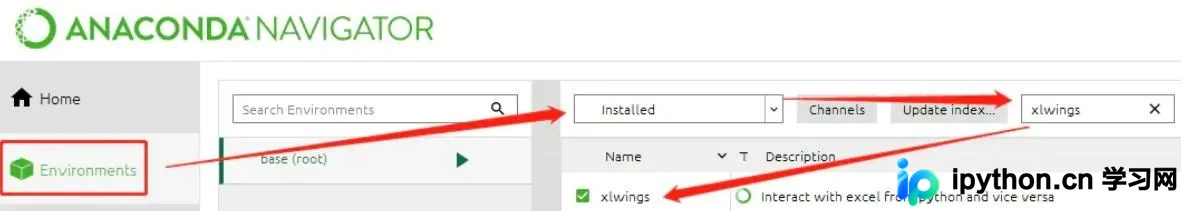
本文详细介绍如何使用Python的xlwings库为Excel文件自动添加表格边框。通过安装依赖、导入模块、定位数据范围及调用Borders API,实现上下左右及内部线条的自动化设置。文章包含完整的代码示例,涵盖文件打开、范围获取、边框参数配置及保存关闭流程,帮助开发者快速掌握Excel格式自动化技巧。
本文介绍Python中基于卡方值的分箱算法实现。通过初始等频分箱,确保每箱包含0和1标签,随后对卡方值最小的相邻箱进行合并,直至达到目标箱数。代码展示了如何计算各箱的IV值、坏比率及WOE值,适用于信用评分卡等场景的特征工程处理。
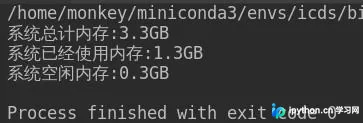
本文介绍如何使用Python的psutil库获取系统内存和CPU占用信息。psutil是一个跨平台系统监控库,支持Linux、Windows等系统。文章提供了安装方法及获取内存总量、已用内存、空闲内存以及CPU逻辑/物理核心数等具体代码示例,帮助开发者实现系统资源监控。
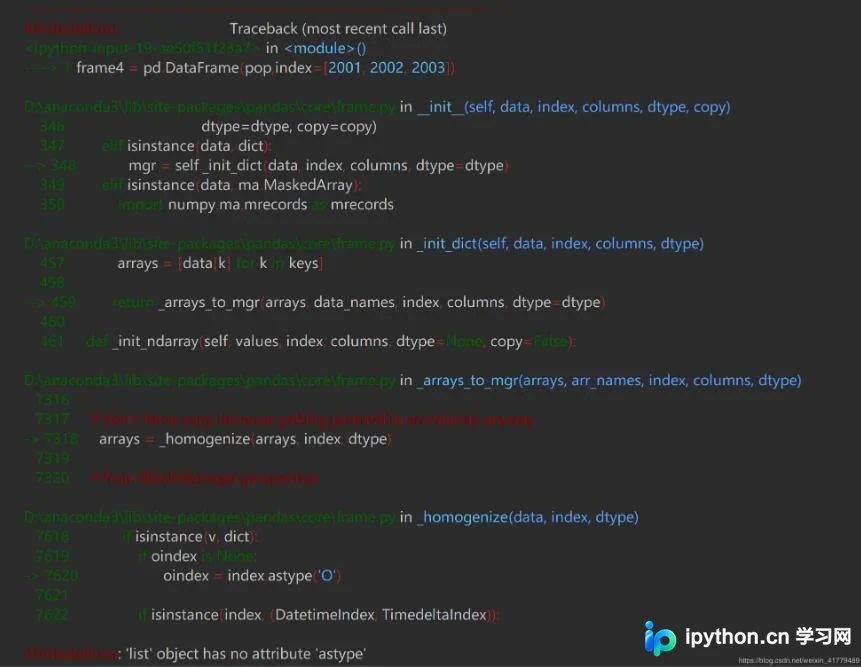
本文详解Python中常见的AttributeError错误。当列表对象调用shape或astype属性时,需先通过np.array()转换为数组或确保DataFrame参数格式正确。提供具体代码示例,帮助开发者快速定位并修复因数据类型不匹配导致的程序中断问题。
本文介绍在Python中使用Pandas将指定列转换为字符串类型的两种主要方法:在读取Excel文件时通过dtype参数直接指定,以及使用apply()函数对已有数据列进行转换。此外,还补充了无需apply即可修改全列时间格式的高效技巧,适用于需要提取特定日期数据的场景。