

Python开发环境选型指南:代码编辑器与集成开发工具对比
本文详细梳理了Python开发所需的软件选择,将工具分为代码编辑器与集成开发环境(IDE)两大类。重点介绍了Sublime Text、Vim、Atom、Emacs、VS Code等轻量级编辑器的特性,以及PyCharm、Eclipse+PyDev、Visual Studio、Spyder和Thonny等专业IDE的功能差异,帮助开发者根据需求高效选型。
2026-10-13
21

本文详细梳理了Python开发所需的软件选择,将工具分为代码编辑器与集成开发环境(IDE)两大类。重点介绍了Sublime Text、Vim、Atom、Emacs、VS Code等轻量级编辑器的特性,以及PyCharm、Eclipse+PyDev、Visual Studio、Spyder和Thonny等专业IDE的功能差异,帮助开发者根据需求高效选型。
本文通过Python代码实例,详解如何实现字符串列表的右对齐表格打印。重点解析两种核心方法:利用sort方法结合lambda函数动态计算列宽,以及直接遍历比较获取最大长度。通过对比示例代码,展示如何优化列表处理逻辑,确保输出格式整齐美观,适用于各类文本排版场景。
本文通过实际代码测试对比Python中list、set和dict在大规模数据下的查找效率。结果显示,list因O(n)线性查找耗时极长;set去重后结构优化,查找最快;dict虽涉及哈希过程,但效率仍优于list。结论建议高频查找场景优先使用set。
本文详细介绍Python中集合的创建、添加及删除操作。集合是无序且元素唯一的可变序列,仅支持不可变类型。文章演示了三种创建方式:直接赋值、range转换及列表转换。同时讲解add方法添加元素,以及del、clear、remove和pop四种删除元素的具体用法与区别,适合Python初学者参考。
本文提供使用Python和Pandas库拆分大型CSV文件的完整代码示例。通过设置chunksize参数进行分块读取,根据指定行数动态计算输出文件数量,并自动处理有表头和无表头两种情况。代码演示了如何遍历数据块并逐一保存为独立CSV文件,适用于处理超出内存限制的大规模数据集。
本文介绍如何使用Python3通过递归方法计算二叉树的最大深度。文章定义了二叉树深度的概念,即根节点到最远叶子节点路径上的节点数,并详细解析了递归遍历的逻辑:从根节点向下遍历,每进入一层子节点深度加一。文中提供了完整的Python3代码实现,包括TreeNode类的定义及Solution类的maxDepth和getDepth方法,最后对算法的时间与空间复杂度进行了简要分析,帮助读者掌握二叉树基础遍历技巧。
本文介绍如何在Django中将秒数转换为包含天、时、分、秒的人性化字符串,利用gettext_lazy实现多语言支持。同时详解使用model_to_dict将Django Model实例转换为字典对象的方法,适用于API开发及数据序列化场景。
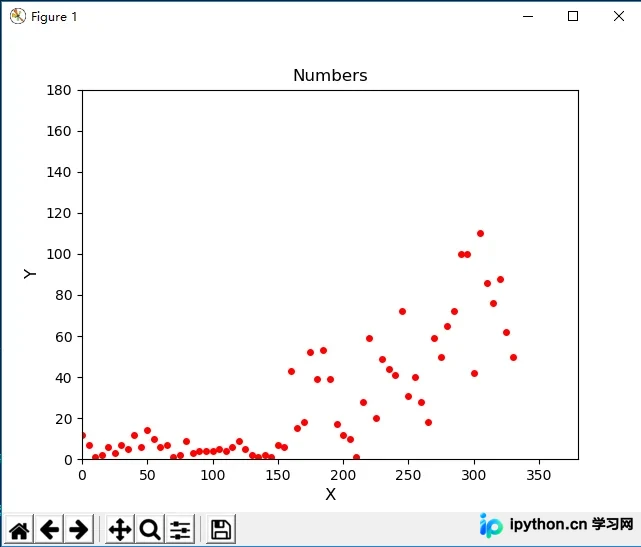
本文通过Python的matplotlib模块scatter方法,展示如何绘制散点图。示例包含生成x、y坐标数据,设置标记大小、颜色及形状,添加标题与轴标签,调整刻度与坐标范围,并输出结果。适合Python初学者参考学习。
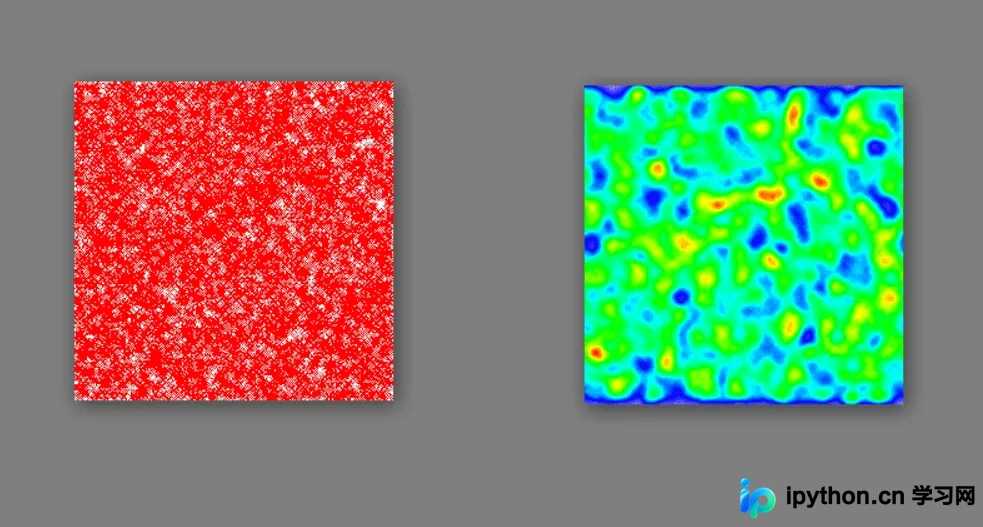
本文介绍Python中绘制热力图的两种常用方法。第一种使用pyheatmap库,通过生成随机坐标数据快速生成点击图和热图;第二种基于matplotlib,利用LogNorm对大规模网格数据进行对数归一化渲染,展示高密度分布。代码包含完整示例及运行结果说明,适合需要快速可视化空间分布或密度数据的开发者参考。
本文详解Python Pandas中处理Excel数据缺失值的两种核心方法:dropna用于删除全空行或列,fillna用于填充特定值或前向/后向填充。通过读取含空行的Excel文件,演示如何忽略前导空行、检测空值、删除无效数据列及行,并将分数列空值填为0,姓名列使用前向填充。最终保存清洗后的数据,提供从读取到保存的完整清洗流程。
本文介绍在Python中将纯数字转换为标准时间格式的多种方法。通过dateutil.parser解析整数日期,利用matplotlib进行时间序列分析,以及使用time模块生成Unix时间戳。内容涵盖从数字到datetime对象的转换、时间序列数值化处理及时间戳计算,为数据处理提供实用参考。
本文介绍如何使用 Python 模拟创建 Seafile 目录的操作。通过 requests 库进行身份验证,获取 CSRF Token 后,构造 POST 请求并发送 JSON 数据,实现远程目录的创建。